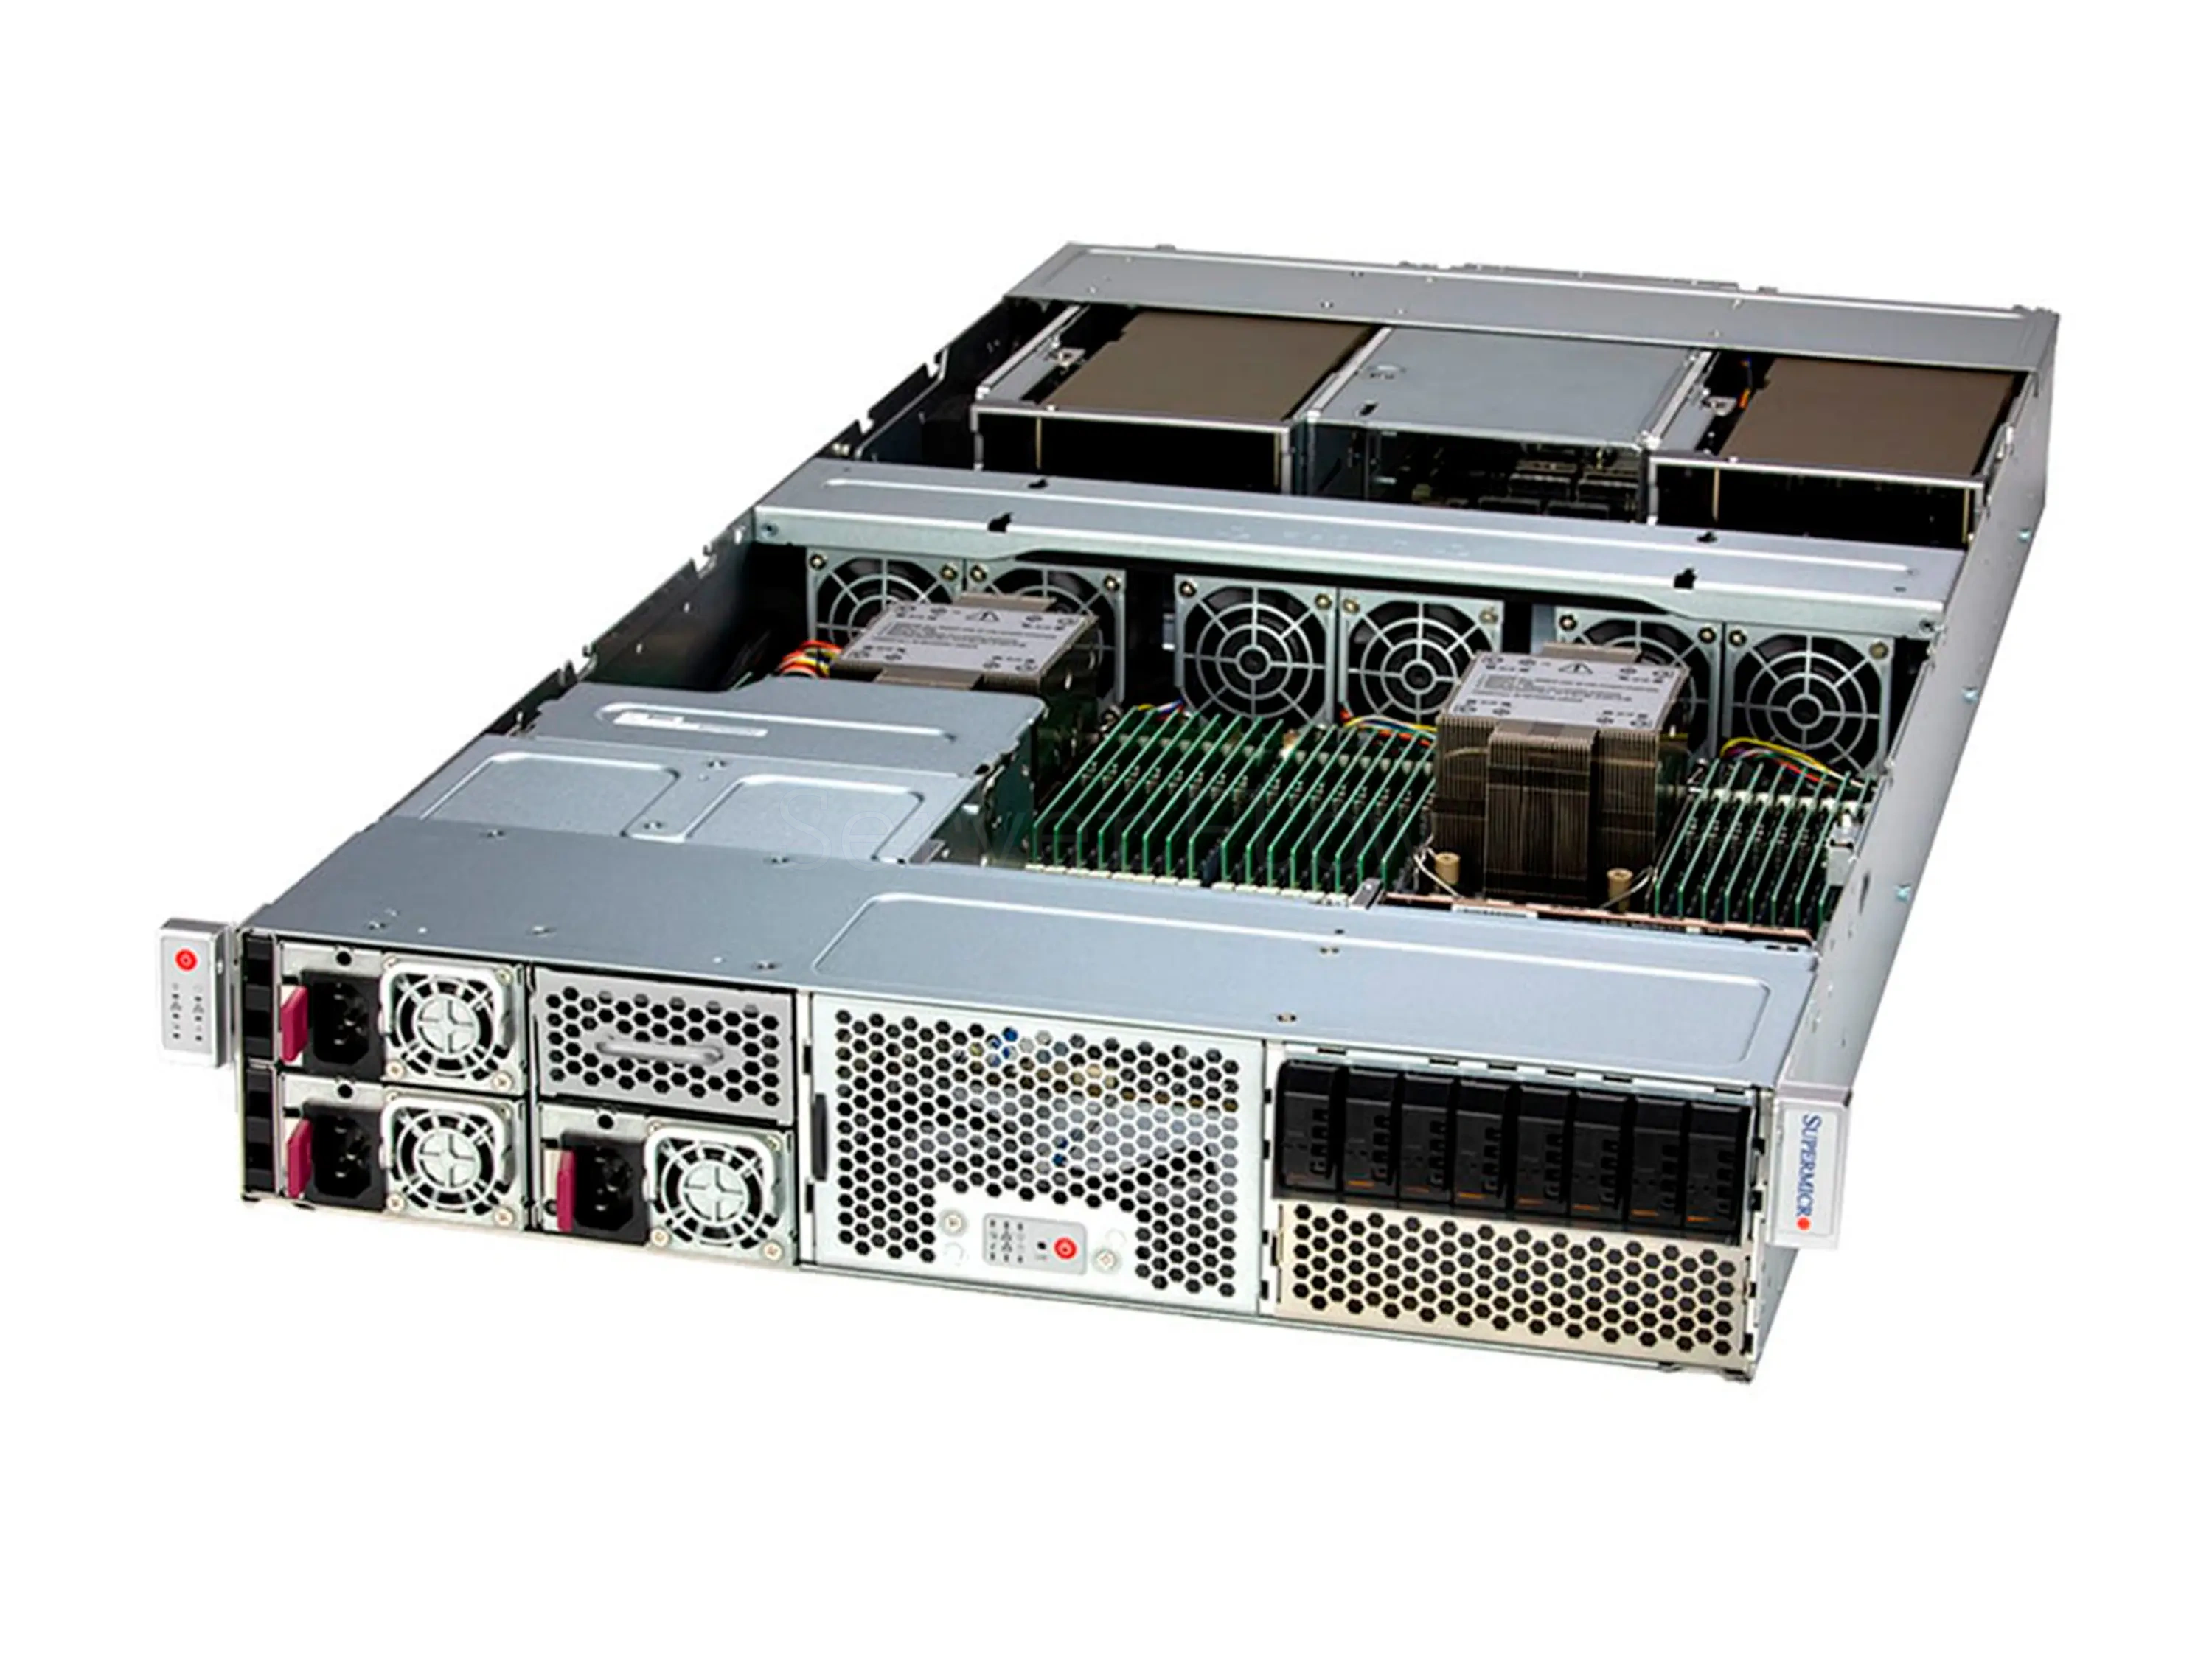
Supermicro SYS-221GE-NR (4x NVIDIA H100 80GB)
18 413 200 ₽
Цена ориентировочная. Информация в каталоге не является публичной офертой.
- Артикул
- SF-23491
- Наличие
- Уточняется
- Обновлено
- 12.11.2026
Поставки организациям и ИП для бизнеса. Для оформления заказа свяжитесь с менеджером и согласуйте итоговую цену, комплектацию и наличие. Контакты менеджера
Характеристики
- Тип
- Новые
- Основная задача
- Обучение моделей / Инференс / Дообучение моделей / RAG-системы / Анализ данных / Научные расчеты (HPC)
- Процессор (CPU)
- Intel Xeon
- Видеокарта (GPU)
- NVIDIA H100
- Количество GPU, шт
- 4
- Общий объем видеопамяти (VRAM), ГБ
- 320
- Тип памяти GPU
- HBM3
- Объем оперативной памяти (RAM), ГБ
- 8192
- Тип оперативной памяти
- DDR5 ECC REG
- Форм-фактор
- 2U
- Тип точности Совокупная мощность четырех H100
- Совокупная мощность четырех H100
- FP64 Tensor Core
- 204 TFLOPS
- FP32 Tensor Core
- 3 024 TFLOPS
- BF16/FP16 Tensor Core
- 6 052 TFLOPS
- FP8 Tensor Core
- 12 104 TFLOPS
- INT8 Tensor Core
- 12 104 TOPS
- Платформа
- Supermicro SYS-221GE-NR
- Видеокарта
- 4x NVIDIA H100 80GB HBM3
- Процессор
- 2x Intel Xeon Scalable 4th и 5th Gen в сокетах LGA 4677
- Оперативная память
- 32 DIMM, до 8TB DDR5 ECC RDIMM
- SSD накопитель
- 8x E1.S NVMe, 2x M.2 NVMe/SATA slots (M-key)
Описание
Supermicro SYS-221GE-NR в конфигурации с 4x NVIDIA H100 80GB - это плотная 2U GPU-платформа для задач уровня дата-центра, где важны высокая вычислительная мощность, большой объём видеопамяти и работа под длительной нагрузкой. Официально эта платформа рассчитана на установку до четырёх PCIe GPU NVIDIA, включая H100, и позиционируется для Обучения моделей (Training), Дообучения моделей (Fine-tuning), Инференса / Развертывания (Inference), RAG-систем и HPC / Научных расчётов.
H100 относится к архитектуре Hopper и ориентирован на современные AI-нагрузки. Для PCIe-версии H100 80GB NVIDIA указывает поддержку CUDA 11.8+, FP8, FP16, INT8, а также 80 GB HBM-памяти на карту, что делает такую конфигурацию сильной для крупных LLM, тяжёлого inference и многопоточного serving на одном узле.
Суммарный объём в 320 GB видеопамяти даёт хороший запас под большие модели, длинный контекст, высокий batch size и несколько параллельных пайплайнов. При этом платформа остаётся именно серверным AI/HPC-решением, а не универсальной рабочей станцией для интерактивной графики или типичного VDI-сценария.
Производительность GPU
| Тип точности | Совокупная мощность четырех H100 |
| FP64 Tensor Core | 204 TFLOPS |
| FP32 Tensor Core | 3 024 TFLOPS |
| BF16/FP16 Tensor Core | 6 052 TFLOPS |
| FP8 Tensor Core | 12 104 TFLOPS |
| INT8 Tensor Core | 12 104 TOPS |
Совместимость с LLM-моделями
| Модель | Тип квантизации | Требуется VRAM | Совместимость | Примечание |
| DeepSeek-R1-Distill-Llama-70B | Нет | Примерно 141GB | ✅ | Уверенно распределяется между 2 GPU и оставляет большой запас под длинный контекст, KV-cache и несколько параллельных сценариев inference. |
| Qwen3.5-122B-A10B-FP8 / Qwen3.6-35B-A3B | FP8 / Нет | Примерно 127GB / 71.9 GB | ✅ | Хорошо подходит для крупного inference на одном узле и оставляет очень большой запас памяти под контекст, батчи и стабильную multi-user нагрузку. |
| gpt-oss:120b | Нет (FP16) | Примерно 260GB | ✅ | Комфортно работает на 4 GPU и сохраняет заметный запас под KV-cache, высокий throughput и параллельное обслуживание нескольких запросов. |
| gemma-4-31B-it | нет | Примерно 62.6GB | ✅ | Очень лёгкая модель для 4x H100 80GB и удобна для нескольких одновременных инстансов, длинного контекста и высокой плотности запросов. |
| MiniMax-M3 | UD-Q4_K_M | Примерно 264GB | ✅ | Квантизированная версия с заметно меньшим объёмом; удобна для серверов с ограниченным запасом памяти, RAG-сценариев, ассистентов и локальных LLM-сервисов. |
| MiMo-V2.5 | Нет | Примерно 316GB | ✅ | Базовая версия среднего объёма для серверов с хорошим запасом памяти; подходит для RAG, корпоративных ассистентов, генерации текста и стабильного инференса без квантизации. |
Совместимость с диффузионными моделями
| Модель | Тип | Совместимость | Примечание |
| Stable Diffusion XL 1.0 | Текст в изображение | ✅ | Уверенно подходит для high-res генерации, крупных батчей и параллельных пайплайнов на нескольких GPU. |
| FLUX.2-dev | Текст в изображение | ✅ | Требовательная модель, но на 4x H100 80GB её удобно распределять по GPU и держать серьёзную очередь задач с большим запасом по памяти. |
| SD Turbo | Быстрые предпросмотры | ✅ | Отлично подходит для быстрых итераций, массовой генерации и высокой плотности параллельных задач. |
| Kandinsky-5.0-T2I-Lite-sft-Diffusers | Текст в изображение | ✅ | Лёгкая версия Kandinsky 5.0 и на этой конфигурации остаётся большой запас видеопамяти под высокое разрешение, батчи и параллельные задания. |
| Kandinsky-6.0-Pro-distill-5s-Diffusers | Текст/изображение в видео со звуком | ✅ | Подходит для пакетной генерации коротких роликов и хорошо масштабируется на нескольких GPU с высоким запасом по производительности. |
| NVIDIA-Cosmos3-Super | Генерации, анализа и симуляции физического мира, которая может работать с текстом, изображениями, видео и действиями | ✅ | Модель объёмом 133 GB для генерации, анализа и симуляции физического мира. Работает с текстом, изображениями, видео и действиями, поэтому подходит для сложных мультимодальных сценариев. Требует высокой производительности и большого объёма видеопамяти, а стабильность запуска зависит от конкретной конфигурации и настроек оптимизации. |
Технические характеристики
| Платформа | Supermicro SYS-221GE-NR |
| Видеокарта | 4x NVIDIA H100 80GB HBM3 |
| Процессор | 2x Intel Xeon Scalable 4th и 5th Gen в сокетах LGA 4677 |
| Оперативная память | 32 DIMM, до 8TB DDR5 ECC RDIMM |
| SSD накопитель | 8x E1.S NVMe, 2x M.2 NVMe/SATA slots (M-key) |