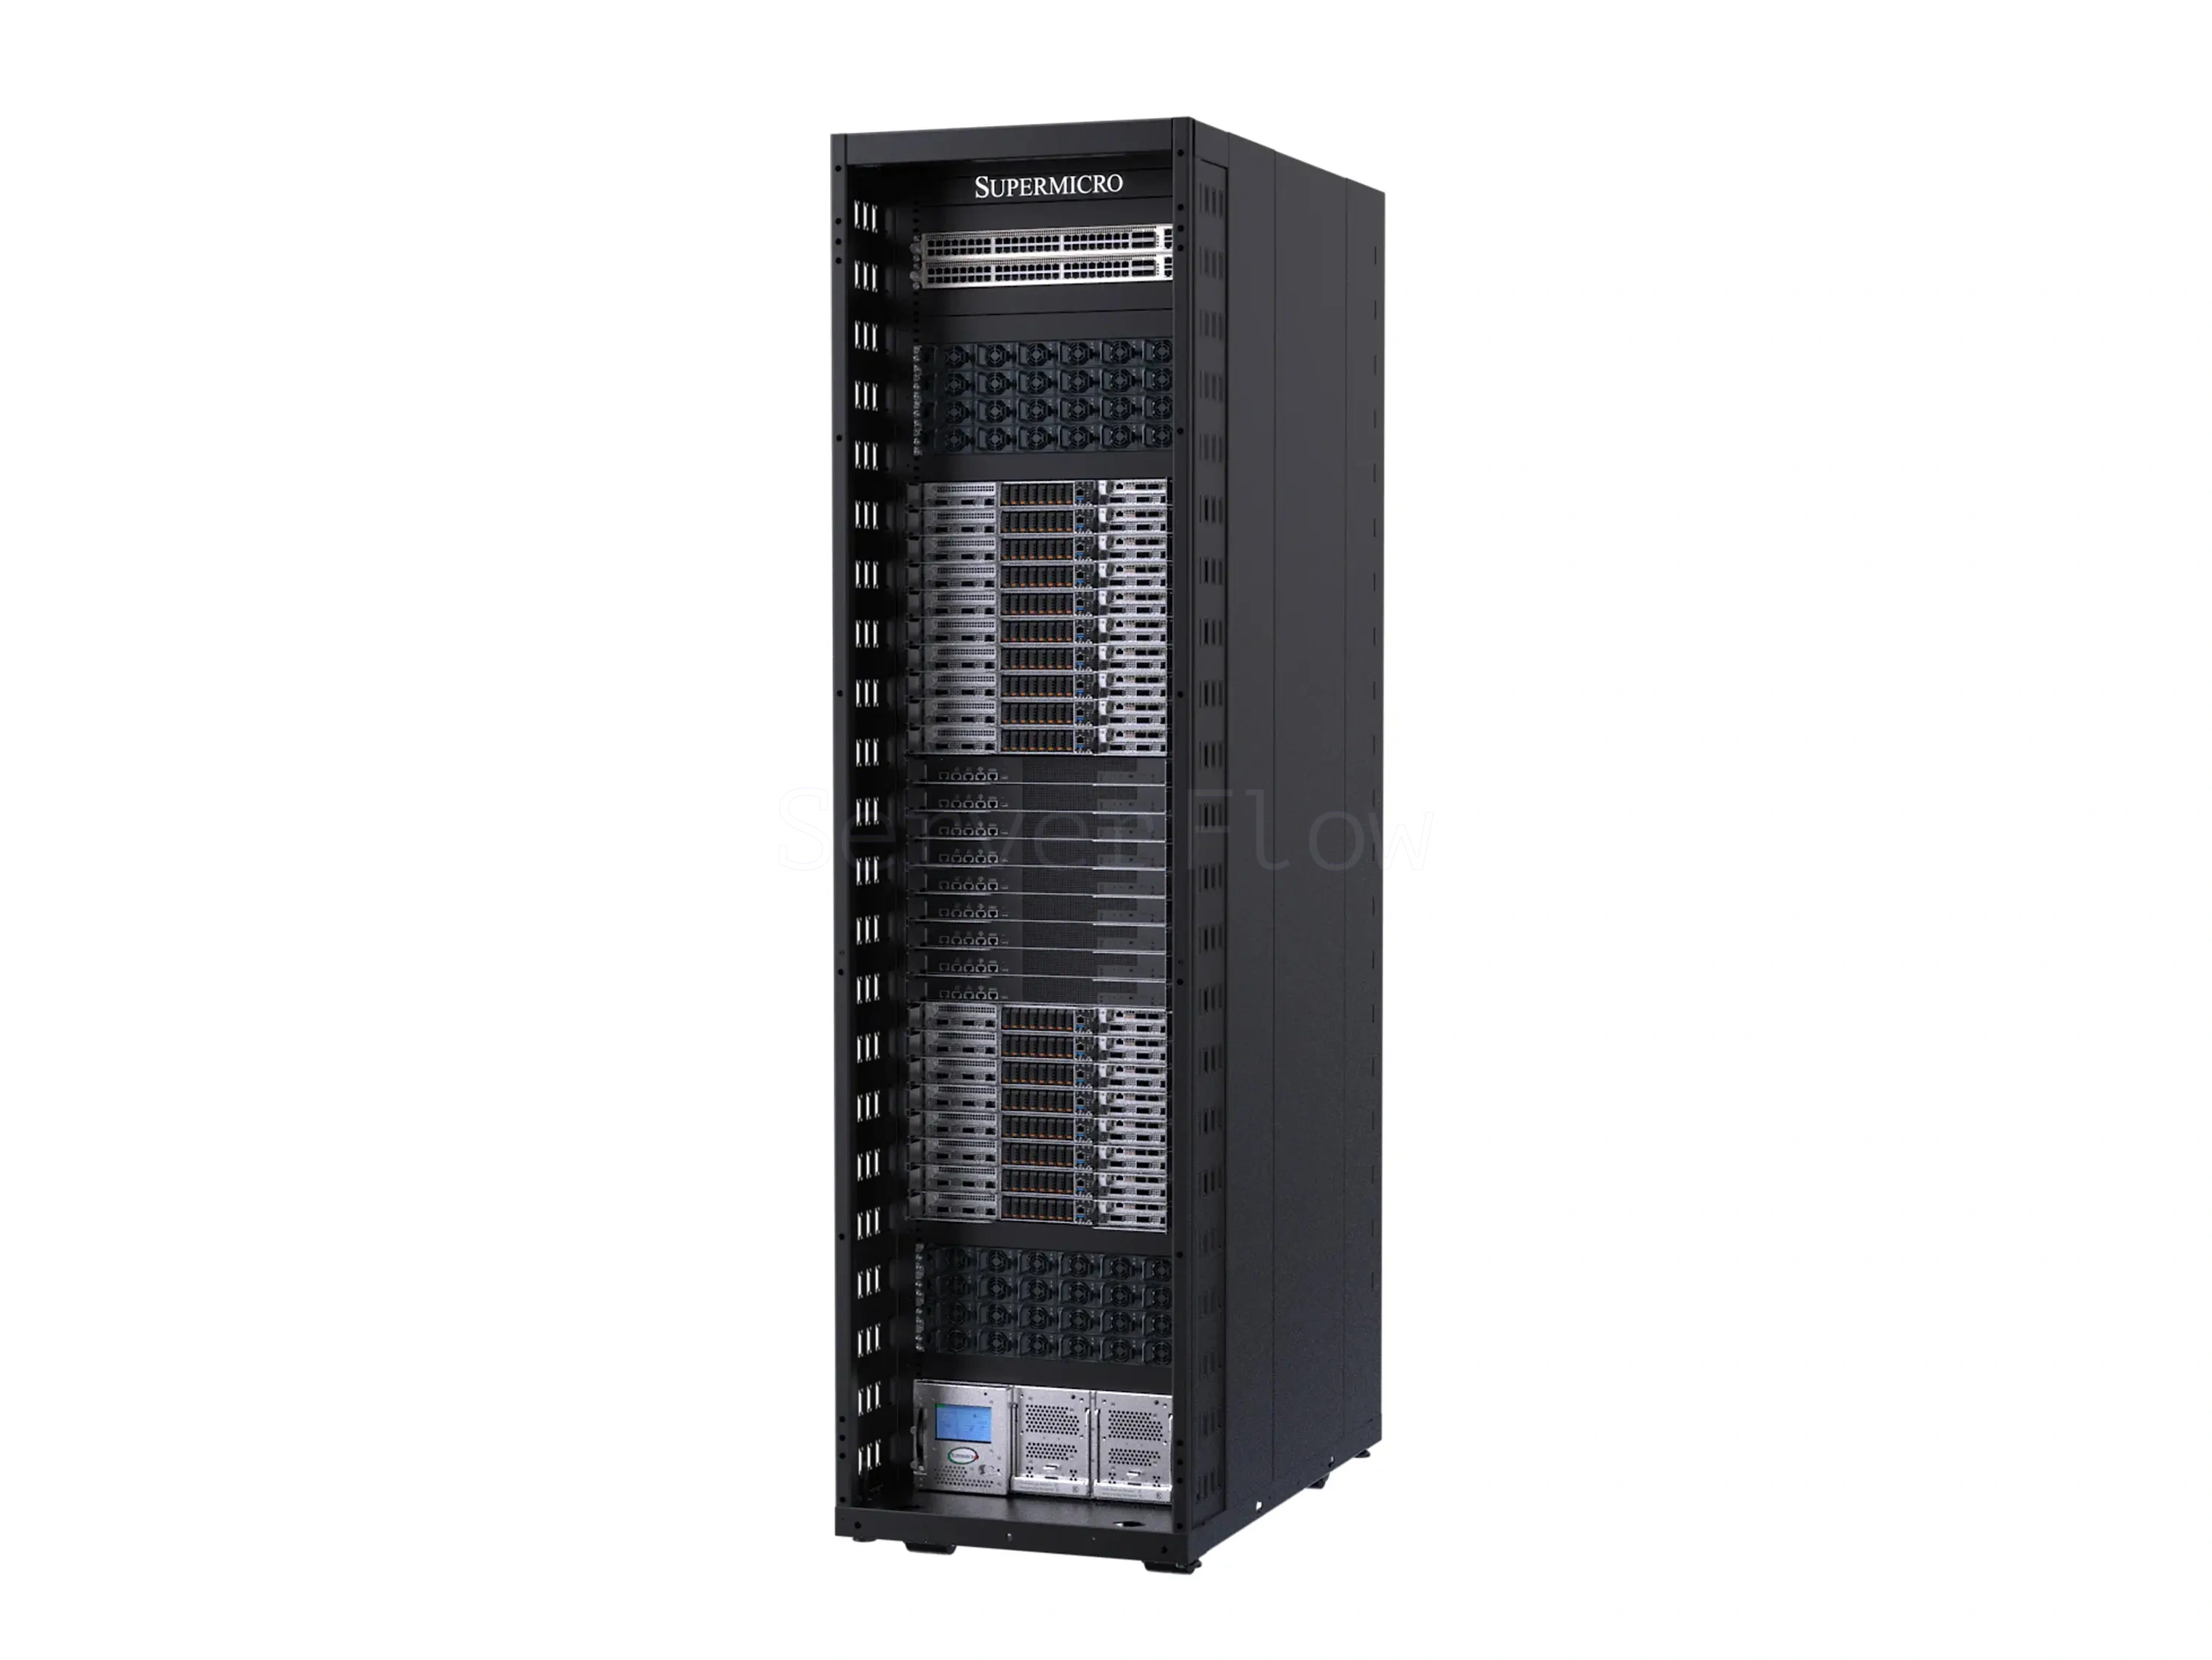
Supermicro NVIDIA GB300 NVL72 (36x GB300 Grace Blackwell Ultra) [SRS-GB300-NVL72]
913 437 600 ₽
Цена ориентировочная. Информация в каталоге не является публичной офертой.
- Артикул
- SF-24644
- Партномер
- SRS-GB300-NVL72
- Наличие
- Уточняется
- Обновлено
- 12.11.2026
Поставки организациям и ИП для бизнеса. Для оформления заказа свяжитесь с менеджером и согласуйте итоговую цену, комплектацию и наличие. Контакты менеджера
Характеристики
- Тип
- Новые
- Парт.№
- SRS-GB300-NVL72
- Основная задача
- Обучение моделей / Инференс / Дообучение моделей / RAG-системы / Анализ данных / Научные расчеты (HPC) / Визуализация и рендеринг
- Процессор (CPU)
- NVIDIA GB300 (Grace)
- Видеокарта (GPU)
- NVIDIA GB300 (Blackwell Ultra)
- Количество GPU, шт
- 72
- Общий объем видеопамяти (VRAM), ГБ
- 20088
- Тип памяти GPU
- HBM3e
- Объем оперативной памяти (RAM), ГБ
- 17856
- Тип оперативной памяти
- LPDDR5x
- Форм-фактор
- 48U
- Тип точности Совокупная мощность системы
- Совокупная мощность системы
- FP4 Tensor core
- 1440 PFLOPS
- FP8 Tensor core
- 720 PFLOPS
- FP6 Tensor core
- 720 PFLOPS
- FP16 Tensor core
- 360 PFLOPS
- BF16 Tensor core
- 360 PFLOPS
- FP32
- 6 PFLOPS
- TF32 Tensor core
- 180 PFLOPS
- FP64 Tensor core
- 100 TFLOPS
- INT8
- 24 POPS
Описание
Supermicro NVIDIA GB300 NVL72 SRS-GB300-NVL72 - это жидкостно-охлаждаемая стоечная AI-система на базе 72 ускорителей NVIDIA B300 Blackwell Ultra и 36 процессоров NVIDIA Grace. Платформа предназначена для Обучения моделей (Training), Дообучения моделей (Fine-tuning), Инференса / Развертывания (Inference), RAG-систем (Retrieval-Augmented Generation), Анализа данных (Data Science) и HPC / Научных расчётов, включая работу с крупнейшими языковыми и reasoning-моделями.
Система оснащается до 20 ТБ памяти HBM3e и до 17 ТБ LPDDR5X, а высокоскоростной контур NVLink обеспечивает эффективную совместную работу всех GPU при длинном контексте, больших батчах и высоком числе параллельных запросов. Архитектура Blackwell Ultra поддерживает современные режимы вычислений FP4, FP8/FP6, FP16/BF16 и INT8, поэтому Supermicro GB300 NVL72 ориентирована на дата-центры и AI-фабрики, где требуется максимальная производительность для масштабного обучения и обслуживания моделей.
Производительность GPU
| Тип точности | Совокупная мощность системы |
| FP4 Tensor core | 1440 PFLOPS |
| FP8 Tensor core | 720 PFLOPS |
| FP6 Tensor core | 720 PFLOPS |
| FP16 Tensor core | 360 PFLOPS |
| BF16 Tensor core | 360 PFLOPS |
| FP32 | 6 PFLOPS |
| TF32 Tensor core | 180 PFLOPS |
| FP64 Tensor core | 100 TFLOPS |
| INT8 | 24 POPS |
Совместимость с LLM-моделями
| Модель | Тип квантизации | Требуется VRAM | Совместимость | Примечание |
| DeepSeek-V4-Pro | Нет | Примерно 865GB | ✅ | Supermicro SRS-GB300-NVL72 уверенно запускает модель с огромным запасом GPU-памяти под длинный контекст, KV-cache, крупные батчи и высокий параллелизм запросов. |
| Qwen3.8-2.4T-A95B | Нет | Примерно 4.89TB | ✅ | Крупная MoE-модель для серверов с большим объёмом GPU-памяти; подходит для сложных reasoning-задач, RAG, агентных сценариев и production-инференса. Для стабильной работы требуется распределение по нескольким GPU и достаточный запас памяти под KV-cache, длинный контекст и параллельные запросы. |
| Gpt-oss:120b | Нет | Примерно 196GB | ✅ | Для этой rack-scale системы модель требует лишь небольшую часть доступной GPU-памяти, что позволяет держать множество одновременных инстансов, длинный контекст и высокий поток запросов. |
| GigaChat3.5-432B-A28B-bf16 | Нет | Примерно 868GB | ✅ | SRS-GB300-NVL72 подходит для крупномасштабного развёртывания модели с длинным контекстом, большими батчами и параллельным обслуживанием большого числа пользователей. |
| Mistral-Large-3-675B-Instruct-251 | Нет | Примерно 682GB | ✅ | Платформа обеспечивает большой резерв для корпоративного инференса, расширенных контекстных окон, крупных батчей и одновременной работы множества запросов. |
| GLM-5.3 | Нет | Примерно 756GB | ✅ | Даже для модели такого класса Supermicro SRS-GB300-NVL72 оставляет значительный запас под KV-cache, большие контексты, параллельные сессии и высоконагруженный инференс. |
| Gemma-4-31B-IT-NVFP4 | NVFP4 (FP4 для NVIDIA) | Примерно 32.7GB | ✅ | Модель в формате NVFP4 хорошо соответствует архитектуре Blackwell Ultra, а для SRS-GB300-NVL72 она подходит для массового параллельного запуска, длинного контекста и максимальной плотности обслуживания запросов. |
| NVIDIA-Nemotron-3-Super-120B-A12B-NVFP4 | NVFP4 (FP4 для NVIDIA) | Примерно 80.4GB | ✅ | NVFP4-модель эффективно использует возможности Blackwell Ultra, а система позволяет одновременно разворачивать большое число инстансов для длинного контекста и высоконагруженного обслуживания запросов. |
| Kimi-K3 | Нет | Примерно 1.56TB | ✅ | Полноразмерная версия для мощных GPU-серверов; подходит для reasoning-задач, RAG, агентных рабочих процессов и производственного инференса с высоким запасом качества. |
| MiniMax-M3 | Нет | Примерно 854GB | ✅ | Полноразмерная версия для серверов с большим запасом памяти; подходит для reasoning-задач, RAG, агентных сценариев и стабильного production-инференса без агрессивной квантизации. |
| MiMo-V2.5-Pro | Нет | Примерно 1.03TB | ✅ | Крупная Pro-версия для серверов с большим объёмом GPU-памяти; подходит для сложных reasoning-задач, RAG, агентных сценариев и production-инференса с высоким запасом качества. |
Совместимость с диффузионными моделями
| Модель | Тип | Совместимость | Примечание |
| Stable Diffusion XL 1.0 | Текст в изображение | ✅ | Supermicro SRS-GB300-NVL72 легко справляется с генерацией высокого разрешения, крупными батчами и массовым параллельным запуском графических пайплайнов. |
| Flux.2-dev | Текст в изображение | ✅ | Большой объём HBM3e и масштаб rack-scale платформы позволяют повышать разрешение, ускорять пакетную генерацию и одновременно обслуживать множество очередей. |
| SD Turbo | Быстрые предпросмотры | ✅ | Подходит для создания большого количества быстрых предпросмотров и параллельной обработки множества пользовательских заданий. |
| Kandinsky-5.0-T2I-Lite-sft-Diffusers | Текст в изображение | ✅ | Платформа позволяет одновременно запускать множество независимых пайплайнов генерации изображений с большим запасом по GPU-памяти и производительности. |
| Kandinsky-6.0-Pro-distill-5s-Diffusers | Текст/изображение в видео со звуком | ✅ | Система подходит для параллельной генерации коротких видеороликов, пакетной обработки заданий и ускорения ресурсоёмких видеодиффузионных сценариев. |