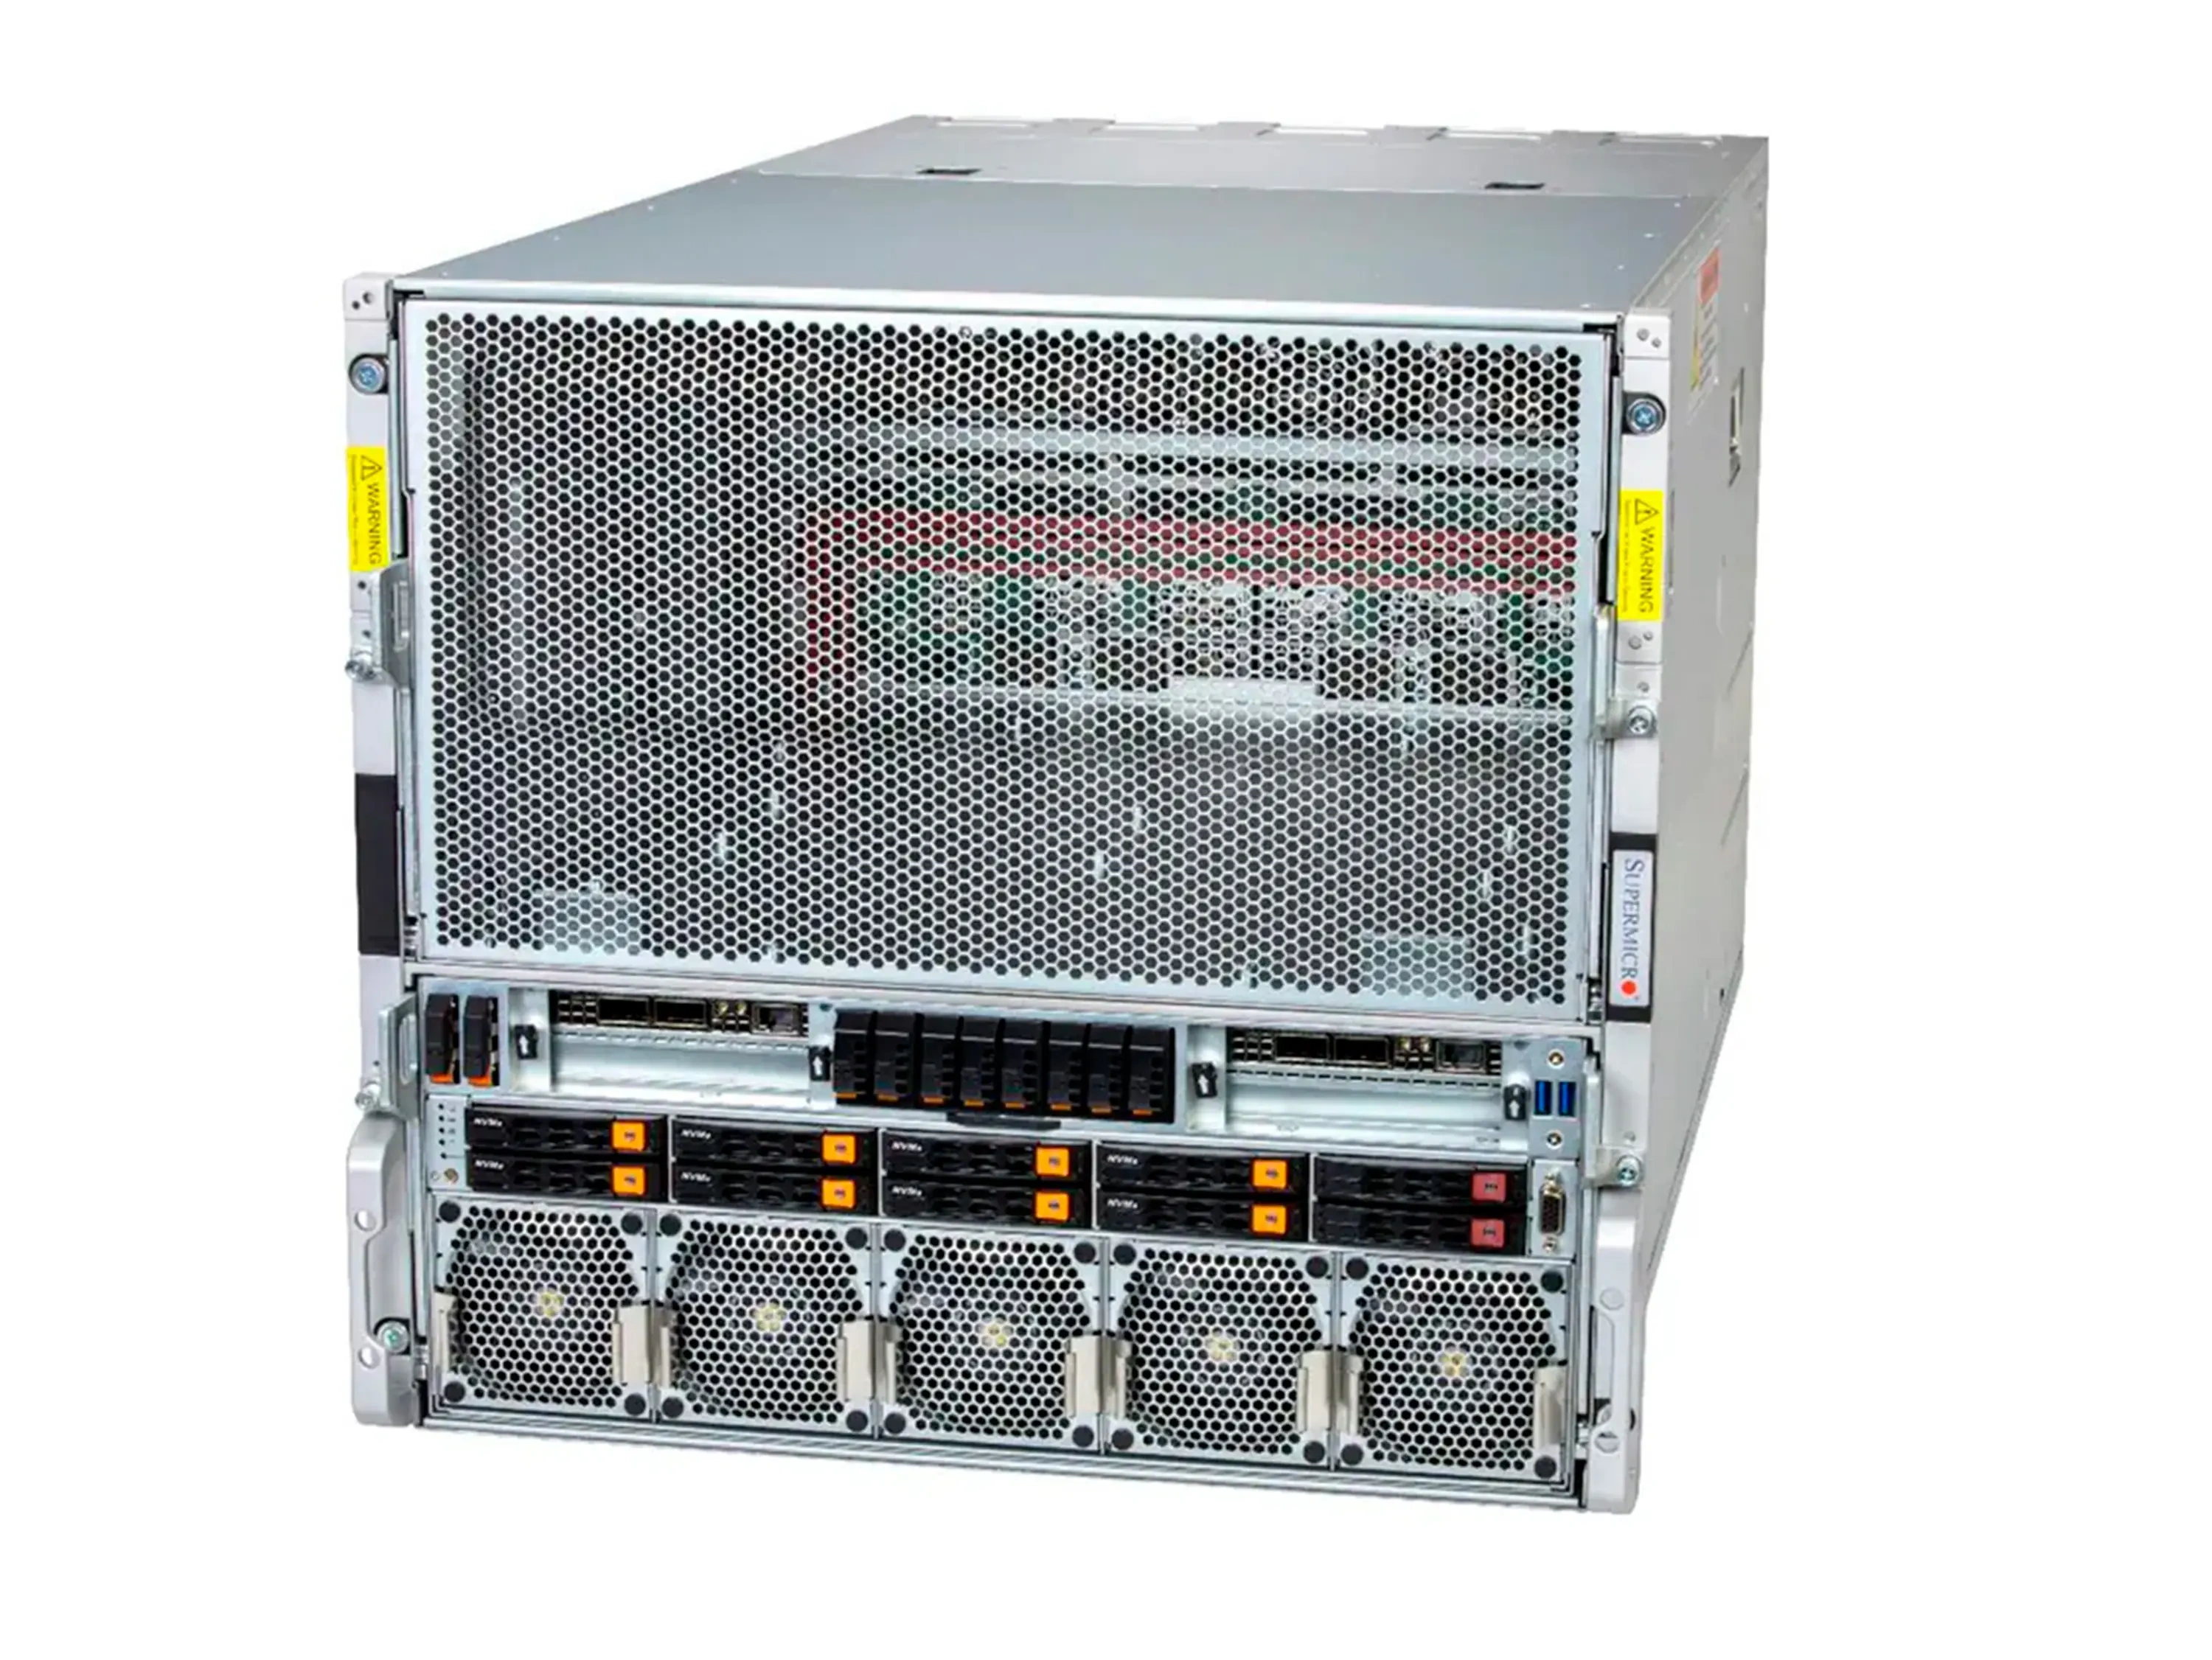
Supermicro AS-A126GS-TNBR (8× B200 SXM 180GB)
88 338 900 ₽
Цена ориентировочная. Информация в каталоге не является публичной офертой.
- Артикул
- SF-20684
- Наличие
- Уточняется
- Обновлено
- 12.11.2026
Поставки организациям и ИП для бизнеса. Для оформления заказа свяжитесь с менеджером и согласуйте итоговую цену, комплектацию и наличие. Контакты менеджера
Характеристики
- Тип
- Новые
- Основная задача
- Обучение моделей / Инференс / Дообучение моделей / RAG-системы / Анализ данных / Научные расчеты (HPC) / Визуализация и рендеринг
- Процессор (CPU)
- AMD EPYC
- Видеокарта (GPU)
- NVIDIA B200 SXM
- Количество GPU, шт
- 8
- Общий объем видеопамяти (VRAM), ГБ
- 1440
- Тип памяти GPU
- HBM3e
- Объем оперативной памяти (RAM), ГБ
- 6144
- Тип оперативной памяти
- DDR5 ECC REG
- Форм-фактор
- 10U
- Тип точности Совокупная мощность HGX B200 8-GPU
- Совокупная мощность HGX B200 8-GPU
- FP64 Tensor core
- 296 TFLOPS
- FP32 Tensor core
- 600 TFLOPS
- BF16/FP16 Tensor core
- 36 PFLOPS
- INT8 Tensor core
- 72 POPS
- FP8/FP6 Tensor core
- 72 PFLOPS
- FP4 Tensor core
- 144 PFLOPS
- Видеокарта
- 8x Nvidia B200 SXM 180GB HBM3e
- Процессор
- 2× AMD EPYC 9005/9004 (SP5 (LGA 6096))
- Оперативная память
- до 6TB DDR5 ECC RDIMM, 24 слота
- SSD накопители
- 8× hot-swap 2.5" NVMe + 2× hot-swap 2.5" SATA, 2× M.2 NVMe
Описание
Конфигурация на NVIDIA HGX B200 180GB (8× SXM) ориентирована на Обучение моделей (Training), Дообучение моделей (Fine-tuning), Инференс / Развертывание (Inference), RAG-системы (Retrieval-Augmented Generation) и HPC / Научные расчёты, когда важны 8-GPU узел и высокая эффективность масштабирования внутри одного сервера.
Установлен HGX B200 8-GPU (180GB на GPU) с суммарным объёмом видеопамяти 1440GB VRAM (≈ 1.4TB) на HBM3e, что помогает держать длинный контекст, крупные батчи и высокий параллелизм запросов без частых упоров в память. Архитектура Blackwell хорошо раскрывается в задачах FP16/FP8/INT8, а для продакшн-serving удобно сочетать tensor parallel на 4–8 GPU с аккуратным контролем KV-cache.
Для связности ускорителей заявлены NVLink с NVSwitch, а CPU-GPU интерконнект - PCIe 5.0 x16, что упрощает работу с распределёнными графами вычислений и снижает накладные расходы при интенсивных обменах между GPU.
Платформа поддерживает 2× AMD EPYC 9005/9004 (до 500W TDP), память ECC DDR5 RDIMM в 24 DIMM с максимумом до 6TB (скорость зависит от поколения CPU), а для накопителей доступны 8 фронтальных hot-swap 2.5" NVMe и 2 hot-swap 2.5" SATA, опционально - 8 E1.S NVMe, плюс 2 M.2 NVMe.
Производительность GPU
| Тип точности | Совокупная мощность HGX B200 8-GPU |
| FP64 Tensor core | 296 TFLOPS |
| FP32 Tensor core | 600 TFLOPS |
| BF16/FP16 Tensor core | 36 PFLOPS |
| INT8 Tensor core | 72 POPS |
| FP8/FP6 Tensor core | 72 PFLOPS |
| FP4 Tensor core | 144 PFLOPS |
Совместимость с LLM-моделями
| Модель | Тип квантизации | Требуется VRAM | Совместимость | Примечание |
| DeepSeek-V4-Pro | Нет | Примерно 865GB | ✅ | Уверенно работает без квантизации на 8 GPU и даёт хороший запас под длинный контекст и батчи. | Qwen3.5-397B-A17B / Qwen3.6-35B-A3B | Нет | Примерно 807GB / 71.9 GB | ✅ | Хорошо масштабируется по 2–8 GPU и подходит для стабильного продакшн serving и агентных сценариев. |
| Gpt-oss:120b | Нет | Примерно 196GB | ✅ | Комфортно держать на 2–4 GPU, оставляя остальную VRAM под высокий concurrency и KV-cache. |
| GigaChat3.5-432B-A28B-bf16 | Нет | Примерно 868GB | ✅ | Эффективно использует 8×B200 и 1.4TB VRAM для длинных контекстов и высокой пропускной способности. |
| Mistral-Large-3-675B-Instruct-251 | Нет | Примерно 682GB | ✅ | Удобна для крупных аналитических задач на 8 GPU, особенно при длинном контексте и высоких батчах. | GLM-5.3 | Нет | Примерно 756GB | ✅ | Стабильно ложится на 8 GPU и хорошо подходит для продакшн LLM-сервисов с высоким QPS. |
| Kimi-K2.7-Code | Нет | Примерно 595GB | ✅ | Полноразмерная версия для мощных GPU-серверов; подходит для reasoning-задач, RAG, агентных рабочих процессов и производственного инференса с высоким запасом качества. |
| MiniMax-M3 | Нет | Примерно 854GB | ✅ | Полноразмерная версия для серверов с большим запасом памяти; подходит для reasoning-задач, RAG, агентных сценариев и стабильного production-инференса без агрессивной квантизации. |
| MiMo-V2.5-Pro | Нет | Примерно 1.03TB | ✅ | Крупная Pro-версия для серверов с большим объёмом GPU-памяти; подходит для сложных reasoning-задач, RAG, агентных сценариев и production-инференса с высоким запасом качества. |
Совместимость с диффузионными моделями
| Модель | Тип | Совместимость | Примечание |
| Stable Diffusion XL 1.0 | Текст в изображение | ✅ | Легко держит high-res и большие батчи, генерацию удобно распараллеливать по нескольким GPU. |
| Flux.2-dev | Текст в изображение | ✅ | Большая VRAM позволяет уверенно работать с high-res и повышать throughput через параллельные очереди. |
| SD Turbo | Быстрые предпросмотры | ✅ | Идеален для быстрых итераций и высокой параллельности предпросмотров на одном узле. |
| Kandinsky-5.0-T2I-Lite-sft-Diffusers | Текст в изображение | ✅ | Лёгкая модель, можно запускать много пайплайнов параллельно и повышать разрешение без упора в память. |
| Kandinsky-5.0-T2V-Lite-sft-5s-Diffusers | Текст в видео | ✅ | Удобно распределять задачи по GPU для пакетной генерации коротких роликов и очередей. |
Технические характеристики
| Видеокарта | 8x Nvidia B200 SXM 180GB HBM3e |
| Процессор | 2× AMD EPYC 9005/9004 (SP5 (LGA 6096)) |
| Оперативная память | до 6TB DDR5 ECC RDIMM, 24 слота |
| SSD накопители | 8× hot-swap 2.5" NVMe + 2× hot-swap 2.5" SATA, 2× M.2 NVMe |
Если нужна конфигурация на эту платформу под ваши задачи - свяжитесь с менеджером, и мы предложим подходящий вариант под бюджет и требования.