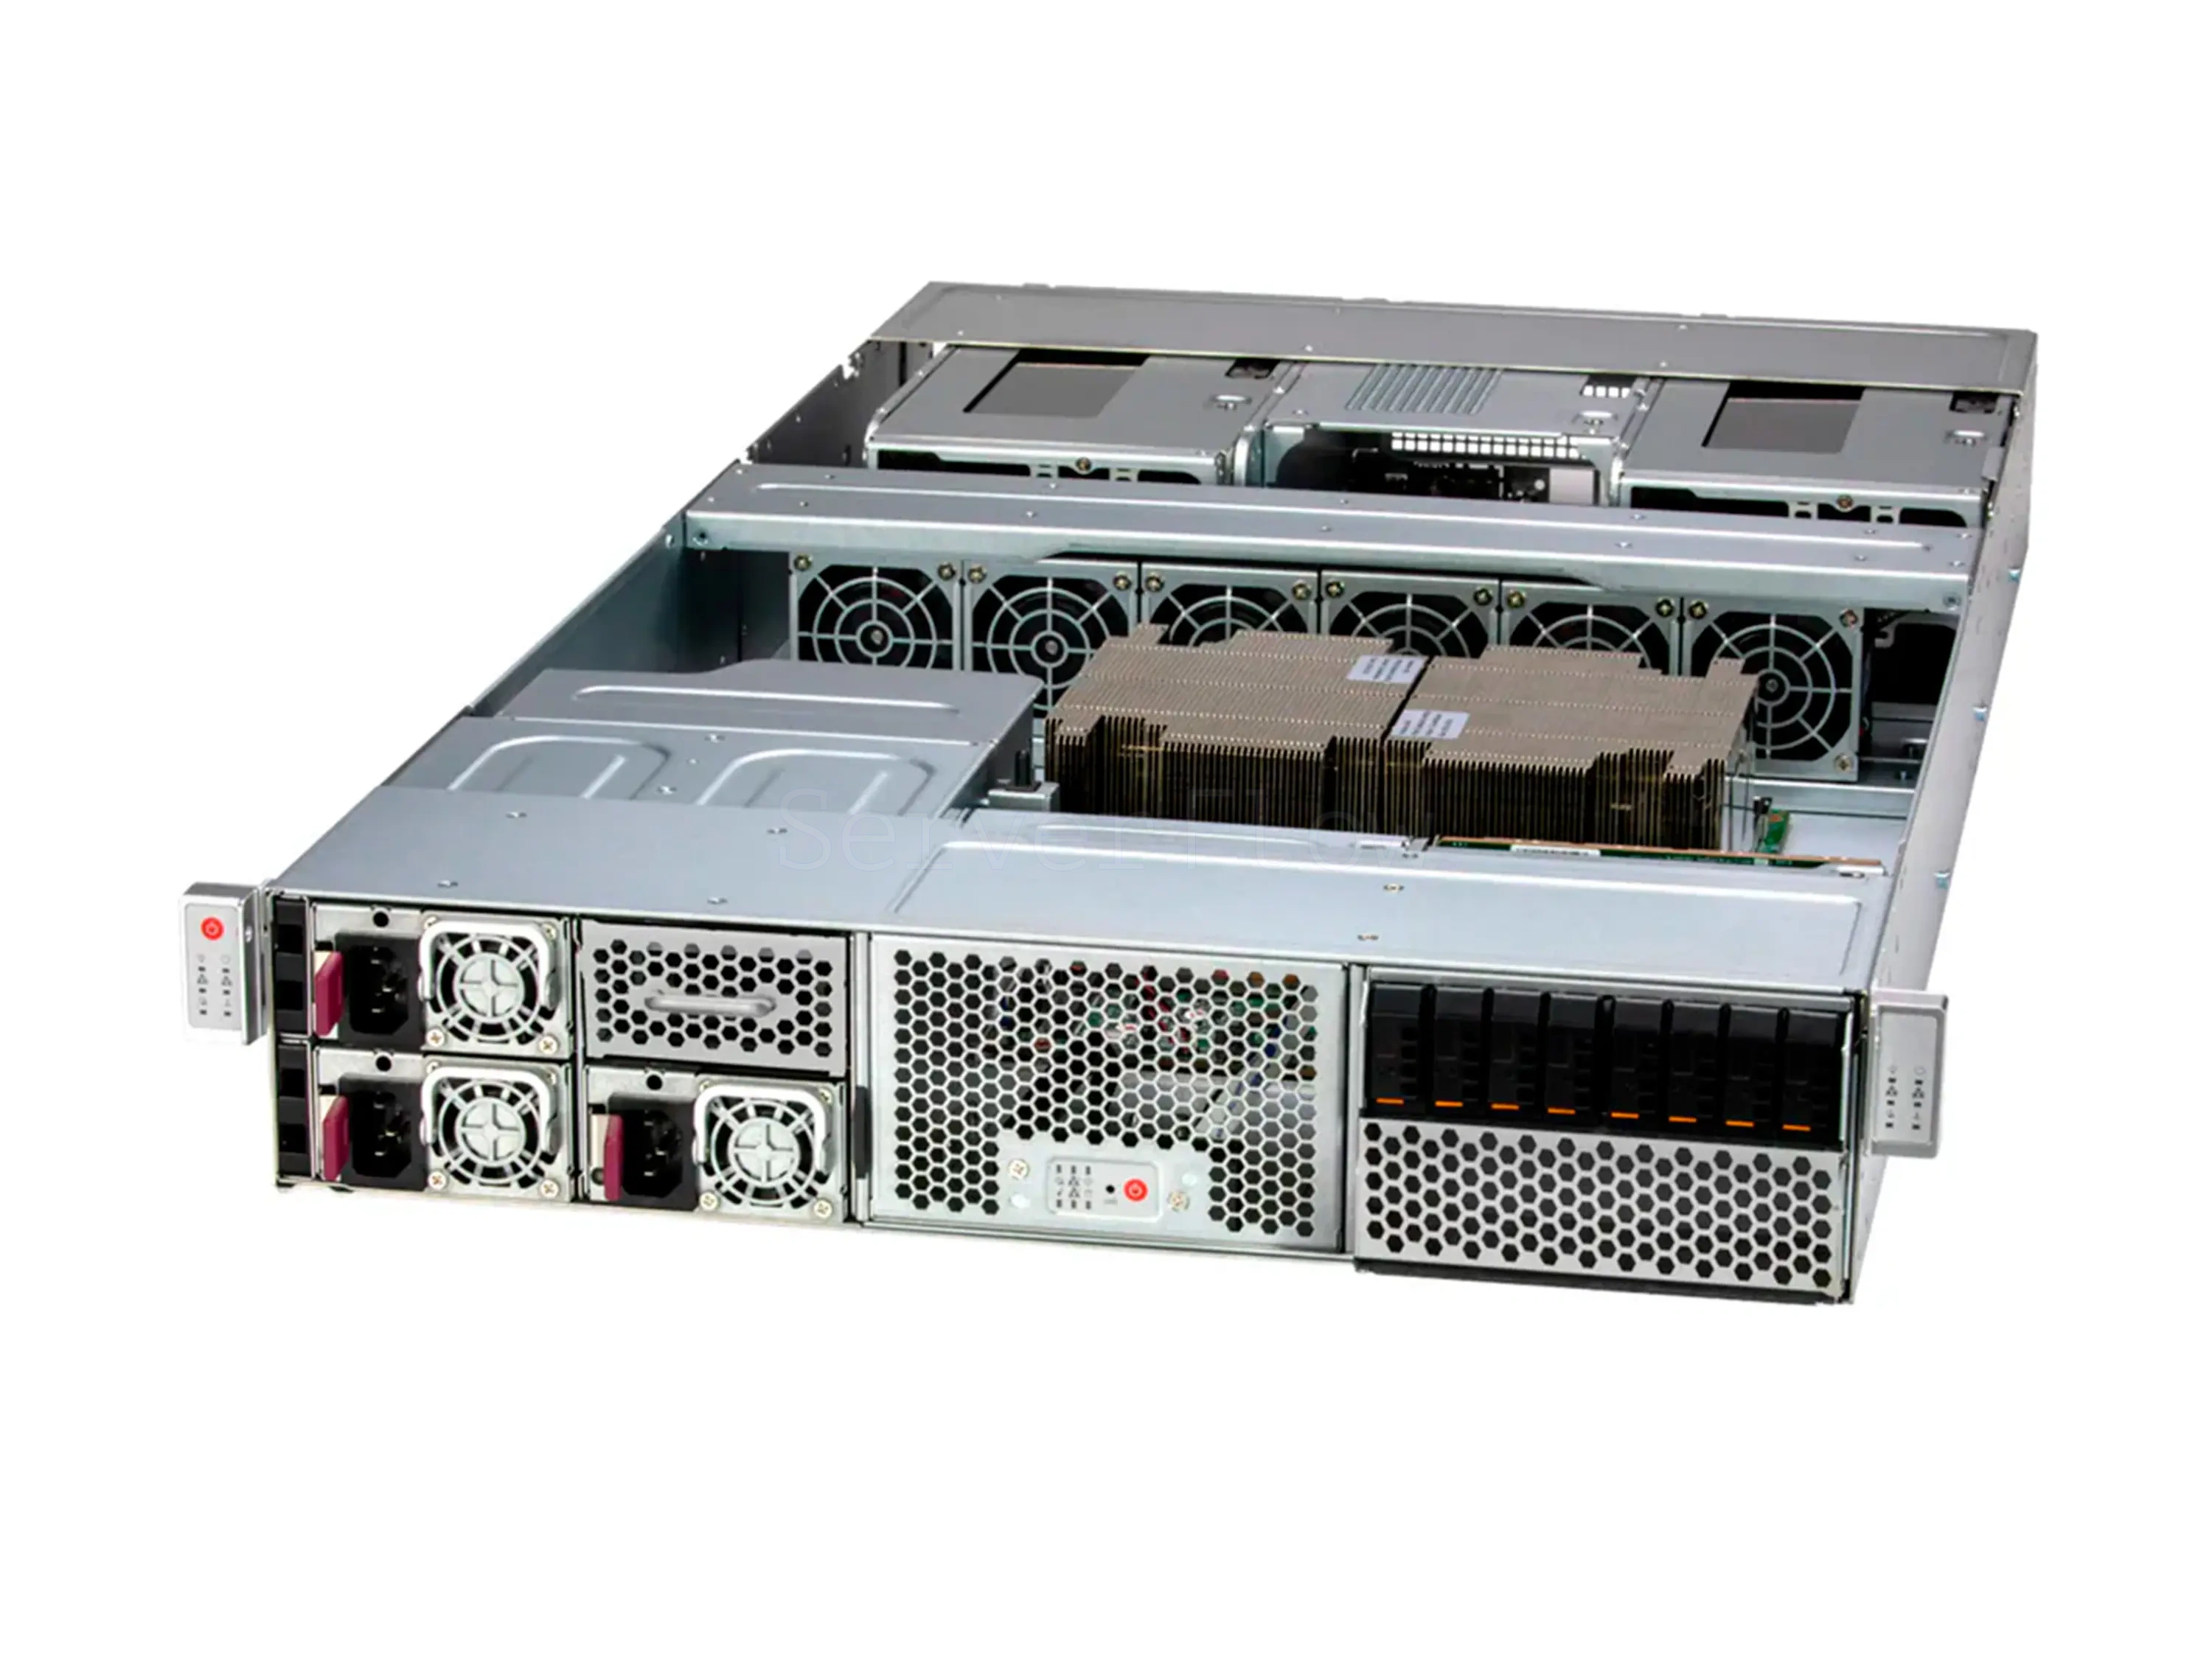
Supermicro ARS-221GL-SR (4× H100 NVL 94GB, 2× Grace, RAM 960GB)
20 904 200 ₽
Цена ориентировочная. Информация в каталоге не является публичной офертой.
- Артикул
- SF-22809
- Наличие
- Уточняется
- Обновлено
- 12.11.2026
Поставки организациям и ИП для бизнеса. Для оформления заказа свяжитесь с менеджером и согласуйте итоговую цену, комплектацию и наличие. Контакты менеджера
Характеристики
- Тип
- Новые
- Основная задача
- Обучение моделей / Инференс / Дообучение моделей / RAG-системы / Анализ данных / Научные расчеты (HPC)
- Процессор (CPU)
- NVIDIA Grace
- Видеокарта (GPU)
- NVIDIA H100
- Количество GPU, шт
- 4
- Общий объем видеопамяти (VRAM), ГБ
- 376
- Тип памяти GPU
- HBM3
- Объем оперативной памяти (RAM), ГБ
- 960
- Тип оперативной памяти
- LPDDR5x
- Форм-фактор
- 2U
- Тип точности Совокупная мощность двух H100 NVL
- Совокупная мощность двух H100 NVL
- FP8 Tensor Core
- 6682 TFLOPS
- BF16 / FP16 Tensor Core
- 3342 TFLOPS
- TF32 Tensor Core
- 1670 TFLOPS
- FP32
- 120 TFLOPS
- FP64 Tensor Core
- 120 TFLOPS
- INT8 Tensor Core
- 6682 TOPS
- Платформа
- Supermicro ARS-221GL-NR
- Видеокарта
- 4x NVIDIA H100 NVL 94GB HBM3
- Процессор
- 2x NVIDIA Grace
- Оперативная память
- 960GB LPDDR5X
- SSD накопитель
- 8x E1.S NVMe 2x M.2 NVMe (M-key)
Описание
Supermicro ARS-221GL-NR - это 2U-платформа для инференса / развертывания, RAG-систем, дообучения моделей и научных расчётов. В этой конфигурации используются два встроенных процессора NVIDIA Grace и четыре ускорителя NVIDIA H100 NVL по 94GB, поэтому сервер получает 376GB HBM3 и 960GB ECC LPDDR5X. Такой вариант уже подходит не только для крупных моделей и длинного контекста, но и для распределённого запуска больших LLM на 4 GPU.
Платформа сочетает большой объём видеопамяти и общей памяти системы, поэтому на ней удобно запускать несколько сервисов одновременно, распределять нагрузку между четырьмя GPU или использовать одну систему под несколько моделей. Конфигурация особенно интересна для больших языковых моделей, RAG, генерации изображений и сценариев, где важна высокая производительность без перехода на полноценный кластер.
Производительность GPU
| Тип точности | Совокупная мощность двух H100 NVL |
| FP8 Tensor Core | 6682 TFLOPS |
| BF16 / FP16 Tensor Core | 3342 TFLOPS |
| TF32 Tensor Core | 1670 TFLOPS |
| FP32 | 120 TFLOPS |
| FP64 Tensor Core | 120 TFLOPS |
| INT8 Tensor Core | 6682 TOPS |
Совместимость с LLM-моделями
| Модель | Тип квантизации | Требуется VRAM | Совместимость | Примечание |
| DeepSeek-R1-Distill-Llama-70B | Нет | Примерно 141GB | ✅ | Уверенно работает на этой системе и оставляет большой запас памяти под длинный контекст и несколько параллельных запросов. |
| Qwen3.5-122B-A10B | Нет | Примерно 250GB | ✅ | Подходит для запуска на 4 GPU и позволяет держать стабильную работу даже при длинном контексте и высокой нагрузке. |
| gpt-oss-120b | Нет | Примерно 196GB | ✅ | Удобный вариант для этой конфигурации - остаётся запас памяти под рабочий контекст, дополнительные сервисы и параллельные задачи. |
| GLM-5.3-Flash | Нет | Примерно 328GB | ✅ | Практически полностью использует доступную видеопамять, поэтому лучше держать умеренный контекст и не перегружать систему дополнительными задачами. |
| Gemma-4-31B-it | Нет | Примерно 62.6GB | ✅ | Подходит для запуска с большим запасом памяти и удобен для параллельной работы нескольких сервисов на 4 GPU. |
| MiniMax-M3 | UD-Q4_K_M | Примерно 264GB | ✅ | Квантизированная версия с заметно меньшим объёмом; удобна для серверов с ограниченным запасом памяти, RAG-сценариев, ассистентов и локальных LLM-сервисов. |
| MiMo-V2.5 | Нет | Примерно 316GB | ✅ | Базовая версия среднего объёма для серверов с хорошим запасом памяти; подходит для RAG, корпоративных ассистентов, генерации текста и стабильного инференса без квантизации. |
Совместимость с диффузионными моделями
| Модель | Тип | Совместимость | Примечание |
| stable-diffusion-3.5-medium | Текст в изображение | ✅ | Подходит для генерации изображений в высоком разрешении и удобной параллельной работы сразу на четырёх GPU. |
| FLUX.2-dev | Текст в изображение | ✅ | Требовательная модель, но на этой конфигурации её удобно распределять между четырьмя GPU для более быстрой и стабильной генерации. |
| SD Turbo | Быстрые предпросмотры | ✅ | Подходит для быстрых итераций, серийной генерации и большого числа одновременных задач. |
| Kandinsky-5.0-T2I-Lite-sft-Diffusers | Текст в изображение | ✅ | Лёгкая модель для этой платформы - можно держать высокое разрешение, большие батчи и несколько процессов одновременно. |
| Kandinsky-6.0-Pro-distill-5s-Diffusers | Текст/изображение в видео со звуком | ✅ | Подходит для коротких роликов и пакетной обработки с распределением нагрузки между четырьмя GPU. |
| NVIDIA-Cosmos3-Super | Генерации, анализа и симуляции физического мира, которая может работать с текстом, изображениями, видео и действиями | ✅ | Модель объёмом 133 GB для генерации, анализа и симуляции физического мира. Работает с текстом, изображениями, видео и действиями, поэтому подходит для сложных мультимодальных сценариев. Требует высокой производительности и большого объёма видеопамяти, а стабильность запуска зависит от конкретной конфигурации и настроек оптимизации. |
Технические характеристики
| Платформа | Supermicro ARS-221GL-NR |
| Видеокарта | 4x NVIDIA H100 NVL 94GB HBM3 |
| Процессор | 2x NVIDIA Grace |
| Оперативная память | 960GB LPDDR5X |
| SSD накопитель | 8x E1.S NVMe
2x M.2 NVMe (M-key) |