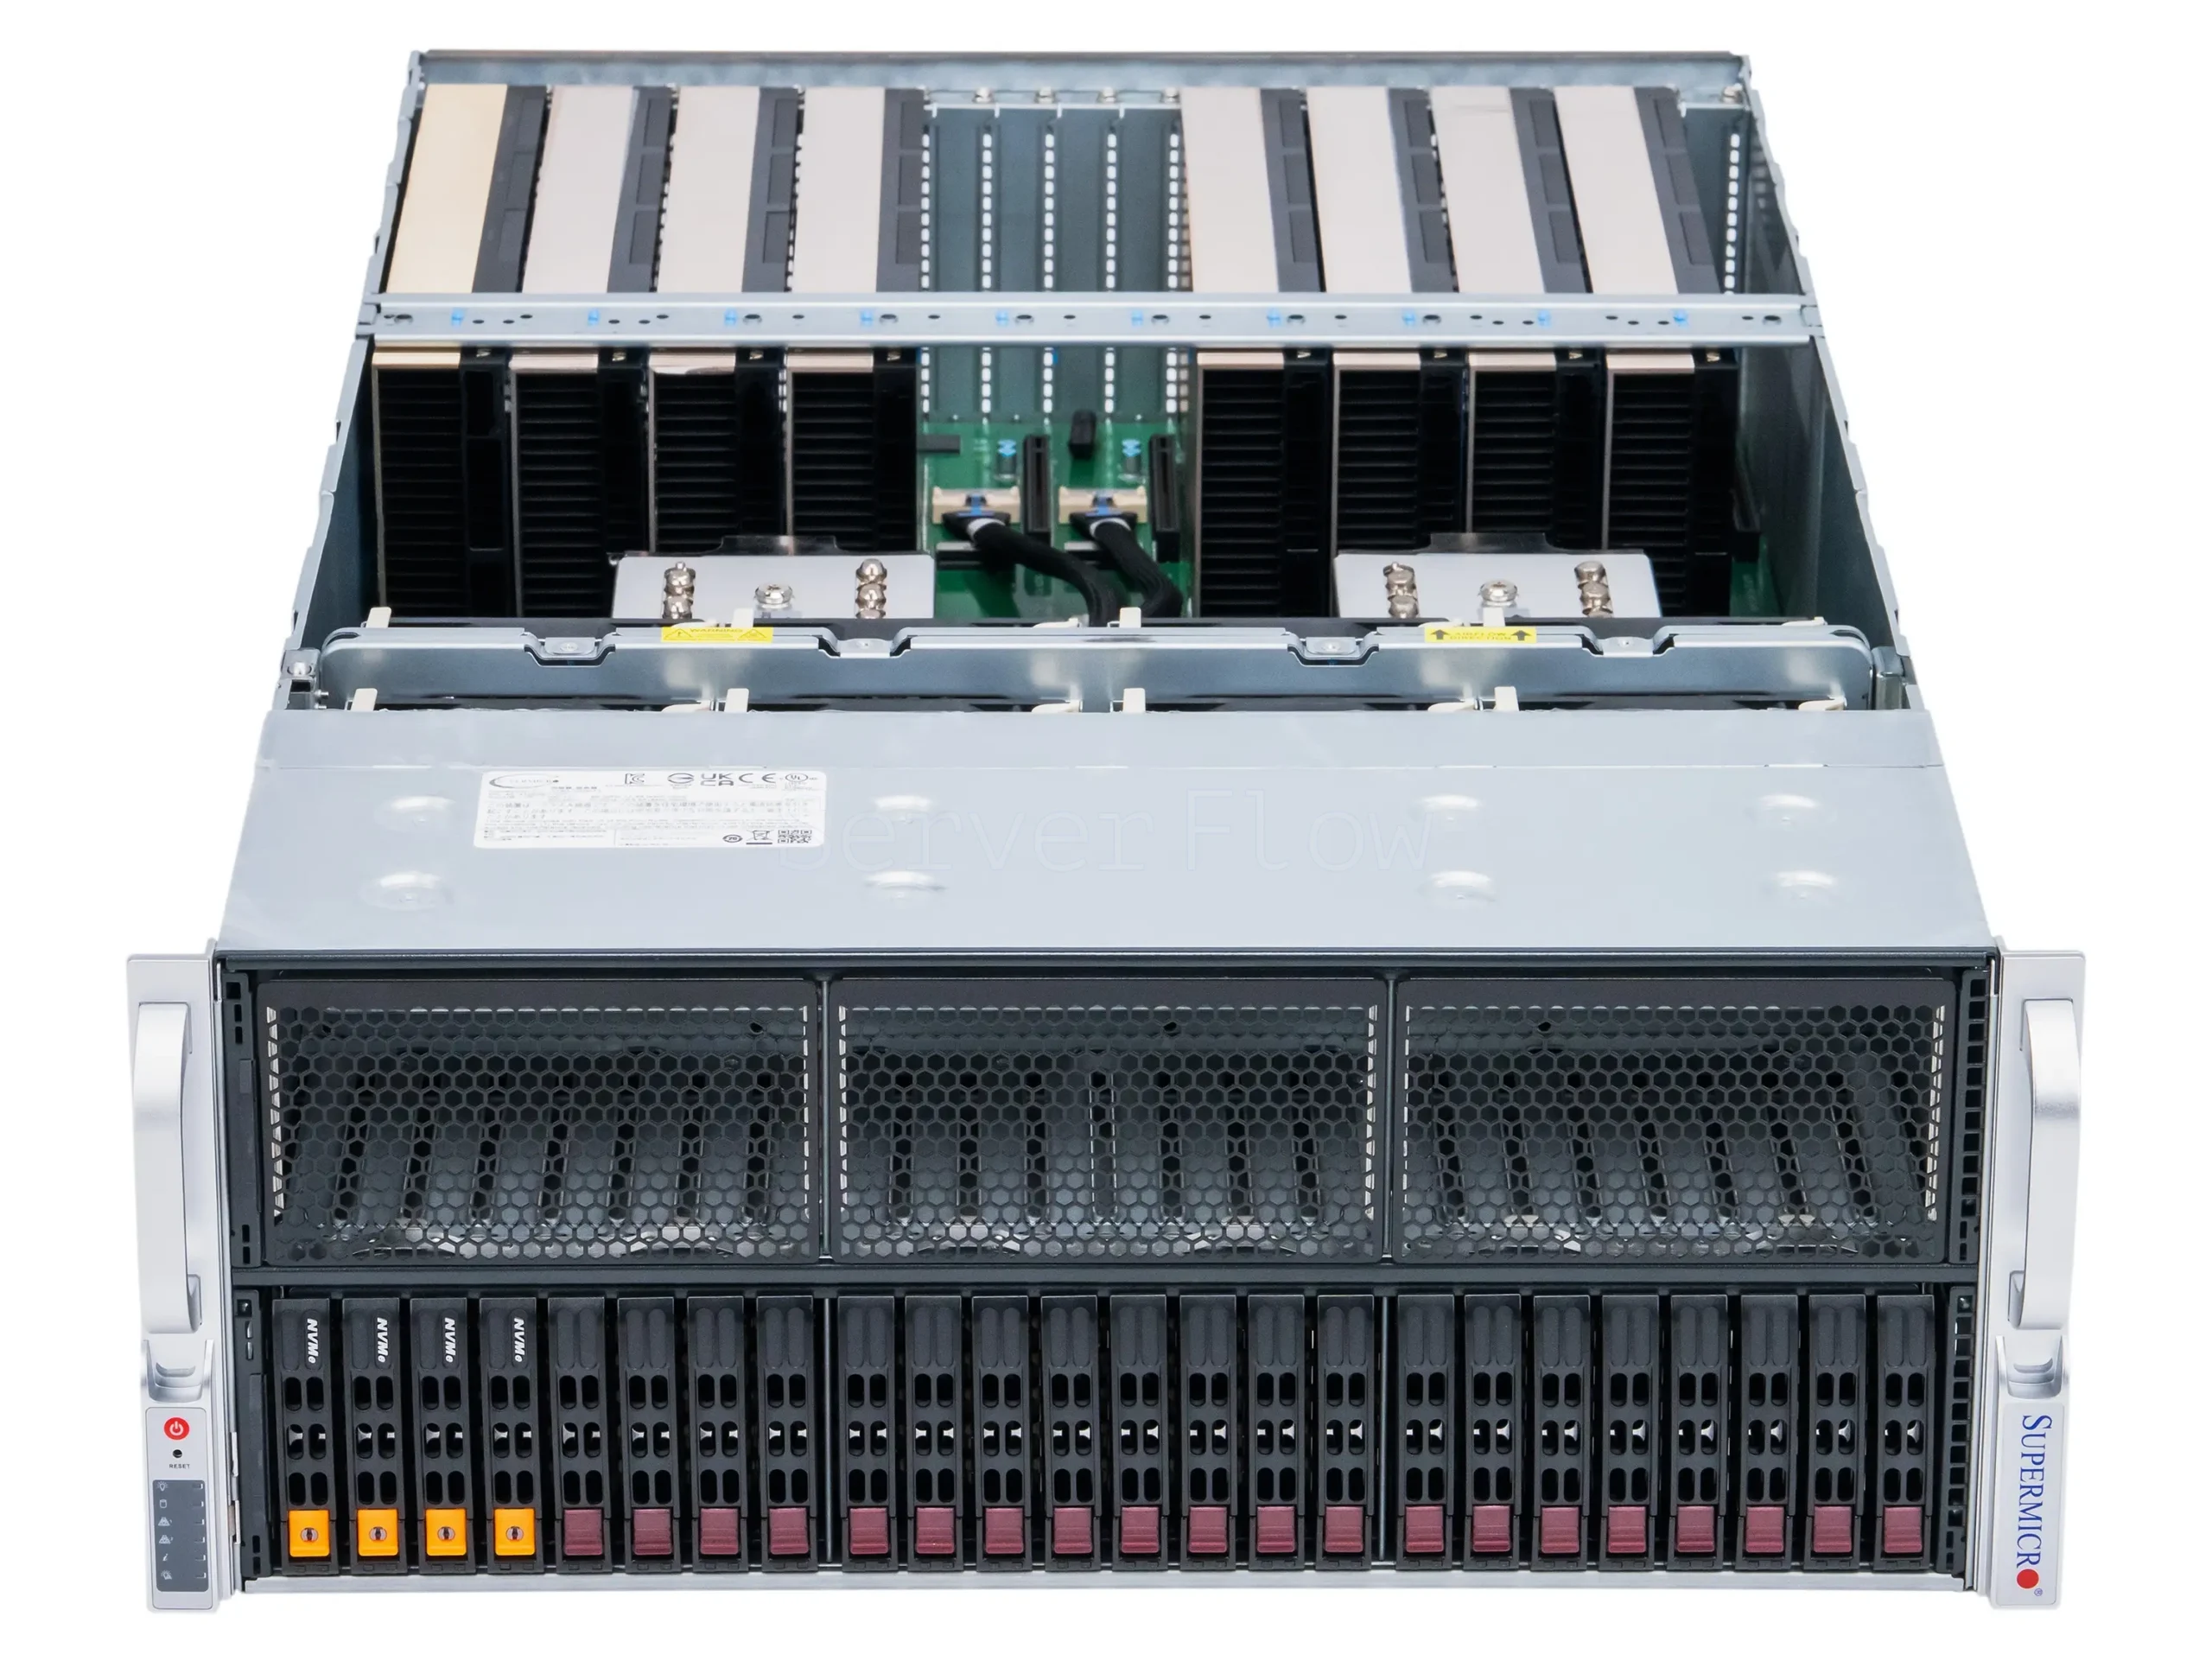
Supermicro 4125GS-TNRT (8× H200 NVL 141GB, 2× EPYC 9845, RAM 2TB)
88 302 200 ₽
Цена ориентировочная. Информация в каталоге не является публичной офертой.
- Артикул
- SF-17431
- Наличие
- Уточняется
- Обновлено
- 12.11.2026
Поставки организациям и ИП для бизнеса. Для оформления заказа свяжитесь с менеджером и согласуйте итоговую цену, комплектацию и наличие. Контакты менеджера
Характеристики
- Тип
- Новые
- Основная задача
- Обучение моделей / Инференс / Дообучение моделей / RAG-системы / Анализ данных / Научные расчеты (HPC)
- Процессор (CPU)
- AMD EPYC
- Видеокарта (GPU)
- NVIDIA H200
- Количество GPU, шт
- 8
- Общий объем видеопамяти (VRAM), ГБ
- 1128
- Тип памяти GPU
- HBM3e
- Объем оперативной памяти (RAM), ГБ
- 2048
- Тип оперативной памяти
- DDR5 ECC REG
- Форм-фактор
- 4U
- Тип точности Совокупная мощность восьми H200
- Совокупная мощность восьми H200
- FP64 Tensor Core
- 480 TFLOPS
- TF32 Tensor Core
- 6680 TFLOPS
- BF16/FP16 Tensor Core
- 13368 TFLOPS
- FP8 Tensor Core
- 26728 TFLOPS
- INT8 Tensor Core
- 26728 TOPS
- Платформа
- Supermicro A+ Server 4125GS-TNRT 4U 24SFF
- Видеокарта
- 8x NVIDIA H200 NVL 141GB HBM3e
- Процессор
- 2x AMD EPYC 9845 (160c/320t, 2.1GHz-3.7GHz, 390W)
- Оперативная память
- 16x 128GB DDR5 ECC REG SK Hynix 5600Mhz 2S2Rx4
- SSD накопитель
- 4x Samsung PM1743 7.68TB 2.5" U.2
Описание
Сервер на 8× NVIDIA H200 NVL 141GB - вершина производительности для Обучения моделей (Training), Дообучения (Fine-tuning), Инференса / Развертывания и HPC. Суммарные 1128 GB HBM3e (по 141 GB на GPU) позволяют запускать и обучать сверхкрупные LLM (200B–600B+) без квантизации и держать очень длинные контексты.
Архитектура Hopper с Transformer Engine (FP8) поддерживает FP8/FP16/BF16/INT8, а HBM3e обеспечивает повышенную пропускную способность памяти по сравнению с H100. МежGPU-связь через NVLink/NVSwitch даёт практически линейное масштабирование в PyTorch 2.x, DeepSpeed, Megatron-LM, vLLM, TensorRT-LLM.
Производительность GPU
| Тип точности | Совокупная мощность восьми H200 |
| FP64 Tensor Core | 480 TFLOPS |
| TF32 Tensor Core | 6680 TFLOPS |
| BF16/FP16 Tensor Core | 13368 TFLOPS |
| FP8 Tensor Core | 26728 TFLOPS |
| INT8 Tensor Core | 26728 TOPS |
Совместимость с LLM-моделями
| Модель | Тип квантизации | Требуется VRAM | Совместимость | Примечание |
| DeepSeek-V4-Pro | Нет | Примерно 865GB | ✅ | Работает стабильно в vLLM / Ollama. |
| Qwen3.5-397B-A17B / Qwen3.6-35B-A3B | Нет | Примерно 807GB / 71.9 GB | ✅ | Идёт «в лоб» без offload. Отличный выбор для reasoning и аналитики. |
| gpt-oss-120b | Нет | Примерно 196GB | ✅ | Высокая скорость отклика и стабильность. Идеально для RAG и многопоточного инференса. |
| GigaChat3.5-432B-A28B-bf16 | Нет | Примерно 868GB | ✅ | Укладывается в 8×H200 NVL без квантизации; подходит для сложных русскоязычных ассистентов и генерации длинных текстов. |
| Mistral-Large-3-675B-Instruct-251 | Нет | Примерно 682GB | ✅ | Стабильно работает без квантизации; многоязычная модель для reasoning-задач, RAG-сценариев и аналитики.. |
| GLM-5.3 | Нет | Примерно 756GB | ✅ | Укладывается в 8×H200 в формате FP8; высокая скорость инференса для сложных ассистентов, reasoning- и RAG-сценариев. |
| Kimi-K2.7-Code | Нет | Примерно 595GB | ✅ | Полноразмерная версия для мощных GPU-серверов; подходит для reasoning-задач, RAG, агентных рабочих процессов и производственного инференса с высоким запасом качества. |
| MiniMax-M3 | Нет | Примерно 854GB | ✅ | Полноразмерная версия для серверов с большим запасом памяти; подходит для reasoning-задач, RAG, агентных сценариев и стабильного production-инференса без агрессивной квантизации. |
| MiMo-V2.5-Pro | Нет | Примерно 1.03TB | ✅ | Крупная Pro-версия для серверов с большим объёмом GPU-памяти; подходит для сложных reasoning-задач, RAG, агентных сценариев и production-инференса с высоким запасом качества. |
Совместимость с диффузионными моделями
| Модель | Тип | Совместимость | Примечание |
| Stable Diffusion 3 Medium | Текст в изображение | ✅ | 3072×3072–4096×4096 «из коробки». Для 8K используйте генерацию по тайлам (UNet/VAE). |
| FLUX.2-dev | Текст в изображение | ✅ | Требует ~178GB VRAM. Подходит для генерации изображений высокого разрешения и больших батчей. |
| Stable Video Diffusion 1.1 | Видео(img2vid) | ✅ | Ролики до 8–12 сек в Full HD. Более длинные — рендер сегментами с объединением. |
| Kandinsky-5.0-T2I-Lite-sft-Diffusers | Текст в изображение | ✅ | Лёгкая версия Kandinsky 5.0; требует ~35GB VRAM, на этих конфигурациях есть большой запас по видеопамяти для высокого разрешения и батчей. |
| Kandinsky-6.0-Pro-distill-5s-Diffusers | Текст/изображение в видео со звуком | ✅ | Модель для генерации 5-секундных видео с синхронизированным звуком по тексту или изображению. |
| NVIDIA-Cosmos3-Super | Генерации, анализа и симуляции физического мира, которая может работать с текстом, изображениями, видео и действиями | ✅ | Модель объёмом 133 GB для генерации, анализа и симуляции физического мира. Работает с текстом, изображениями, видео и действиями, поэтому подходит для сложных мультимодальных сценариев. Требует высокой производительности и большого объёма видеопамяти, а стабильность запуска зависит от конкретной конфигурации и настроек оптимизации. |
Технические характеристики
| Платформа | Supermicro A+ Server 4125GS-TNRT 4U 24SFF |
| Видеокарта | 8x NVIDIA H200 NVL 141GB HBM3e |
| Процессор | 2x AMD EPYC 9845 (160c/320t, 2.1GHz-3.7GHz, 390W) |
| Оперативная память | 16x 128GB DDR5 ECC REG SK Hynix 5600Mhz 2S2Rx4 |
| SSD накопитель | 4x Samsung PM1743 7.68TB 2.5" U.2 |