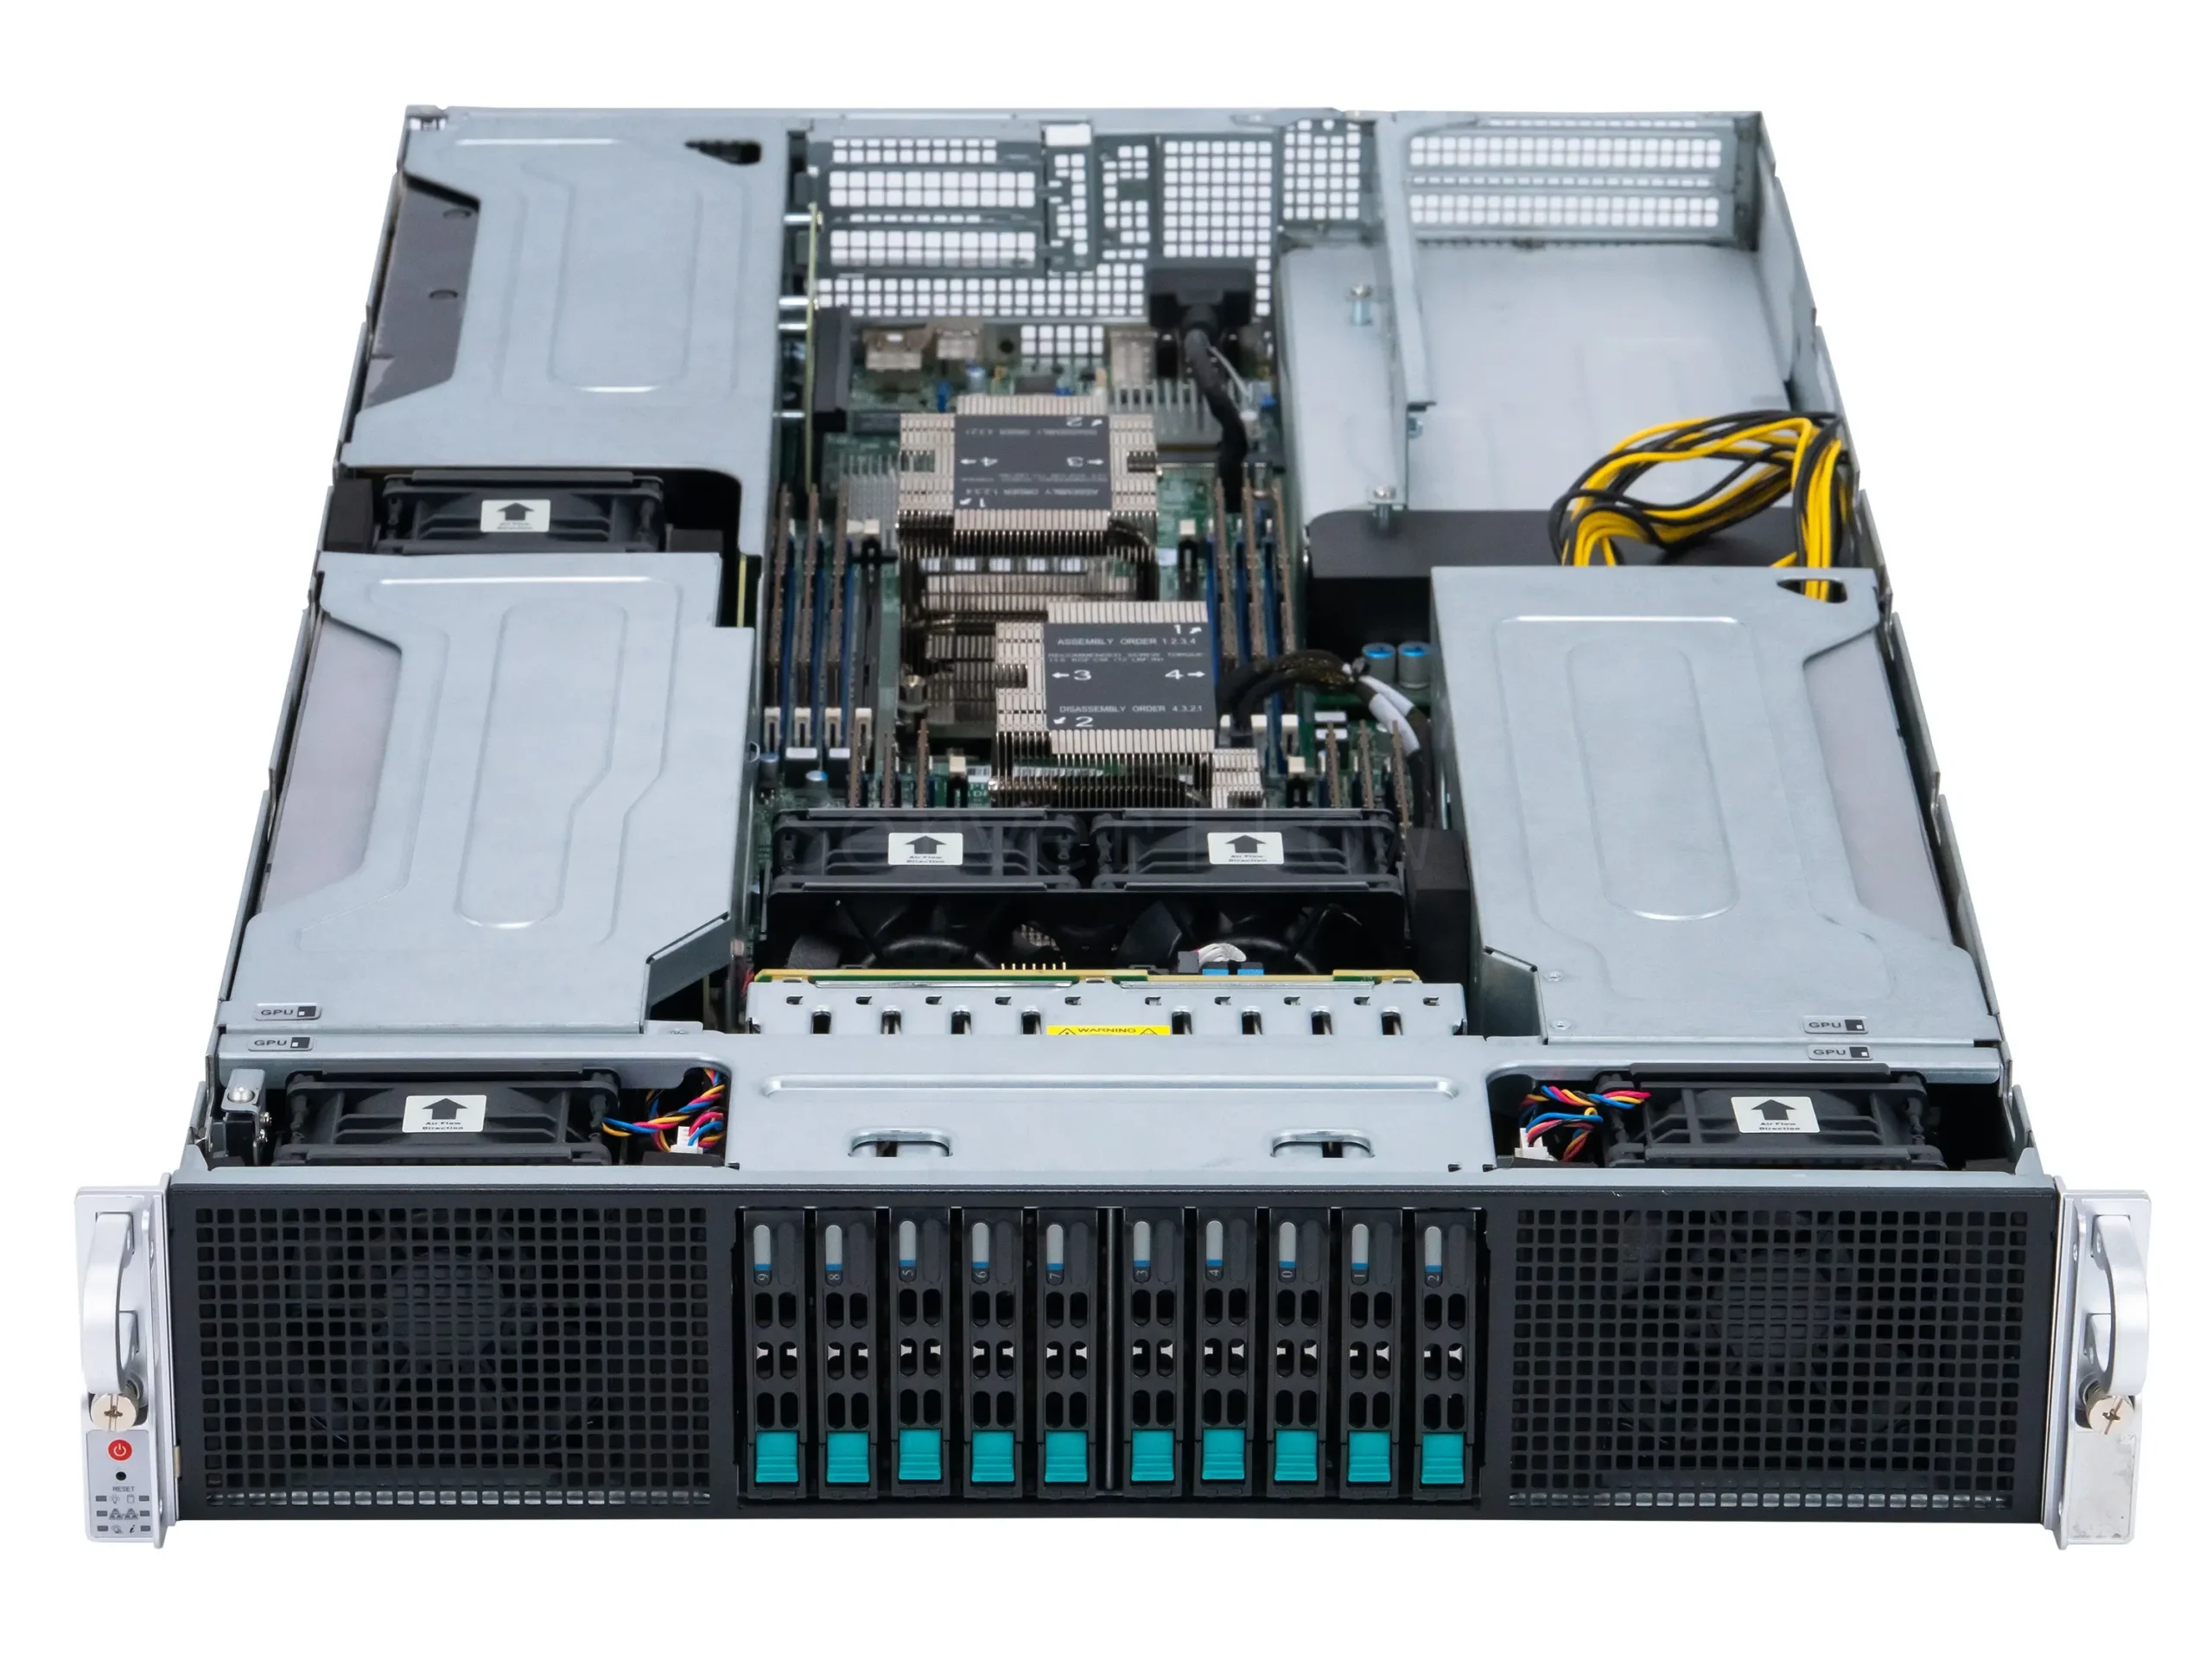
Supermicro 2029GP-TR (6× Tesla V100 16GB, 2× Xeon Platinum 8160, RAM 384GB)
1 092 800 ₽
Цена ориентировочная. Информация в каталоге не является публичной офертой.
- Артикул
- SF-17375
- Наличие
- Уточняется
- Обновлено
- 12.11.2026
Поставки организациям и ИП для бизнеса. Для оформления заказа свяжитесь с менеджером и согласуйте итоговую цену, комплектацию и наличие. Контакты менеджера
Характеристики
- Тип
- Б/У
- Основная задача
- Инференс / Дообучение моделей / RAG-системы
- Процессор (CPU)
- Intel Xeon
- Видеокарта (GPU)
- NVIDIA Tesla V100
- Количество GPU, шт
- 6
- Общий объем видеопамяти (VRAM), ГБ
- 96
- Тип памяти GPU
- HBM2
- Объем оперативной памяти (RAM), ГБ
- 384
- Тип оперативной памяти
- DDR4 ECC REG
- Форм-фактор
- 2U
- Тип точности Совокупная мощность шести V100
- Совокупная мощность шести V100
- FP64
- 42 TFLOPS
- TF32
- 84 TFLOPS
- Тензорная производительность (FP16 Tensor + INT8)*
- 672 TFLOPS
- Платформа
- Supermicro SuperServer 2029GP-TR 2U 10SFF
- Видеокарта
- 6x NVIDIA Tesla V100 16GB HBM2
- Процессор
- 2x Intel Xeon Platinum 8160 (24c/48t, 2.1GHz-3.7GHz, 150W)
- Оперативная память
- 12x 32GB DDR4 ECC REG Micron 2666Mhz 2Rx4
- SSD накопитель
- 2x Intel S4510 480GB 2.5" 6Gb/s 2x Intel D5-P5530 960GB 2.5" U.2
Описание
Этот сервер ориентирован на Инференс / Развертывание, Дообучение моделей и RAG-системы для корпоративных сценариев: чат-ассистенты, аналитика документов, генерация кода и изображений. Конфигурация из шести Tesla V100 даёт суммарно 96 GB высокоскоростной HBM2, что позволяет запускать крупные LLM в 4-битной квантизации с тензорным распараллеливанием и поддержкой высоких токен-потоков.
Volta-архитектура V100 обеспечивает тензорные ядра для FP16 и поддержку INT8 (через TensorRT), стабильный стек CUDA (PyTorch/vLLM/Ollama/DeepSpeed-Inference). Без NVLink возможен запуск через tensor-parallel с умеренными ограничениями по скоростям.
Ограничения: отсутствует FP8/FP4; 16 GB на каждой видеокарте - крупные модели требуют мульти-GPU (tensor-/pipeline-parallel). Рекомендуемые среды: CUDA 11.8–12.x, PyTorch 2.x, vLLM 0.5+.
Производительность GPU
| Тип точности | Совокупная мощность шести V100 |
| FP64 | 42 TFLOPS |
| TF32 | 84 TFLOPS |
| Тензорная производительность (FP16 Tensor + INT8)* | 672 TFLOPS |
* - так обозначалось только в первом поколении видеокарт на архитектуре Volta.
Совместимость с LLM-моделями
| Модель | Тип квантизации | Требуется VRAM | Совместимость | Примечание |
| DeepSeek-R1 70B | Q4_K_M | Примерно 70GB | ✅/⚠️ | Запуск через vLLM / Ollama; tensor-parallel на 4-6 GPU |
| Qwen3.8-27B | Нет | Примерно 55.6GB | ✅ | Полноценный запуск без квантизации в multi-GPU на 6× Tesla V100 16GB; суммарно 96GB VRAM, достаточный запас под KV-cache и контекст |
Совместимость с диффузионными моделями
| Модель | Тип | Совместимость | Примечание |
| Stable Diffusion XL 1.0 | Текст в изображение | ✅/⚠️ | Оптимальна при ≥48 GB суммарно; для больших батчей - мульти-GPU |
| Flux 1.1 Pro | Диффузионная | ✅ / ⚠️ | Требует CUDA 11.8+; ускорение через xFormers |
| SD Turbo | Видео / серийные кадры | ✅ | Быстрые предпросмотры, низкие задержки |
| Kandinsky-5.0-T2I-Lite-sft-Diffusers | Текст в изображение | ✅ | Лёгкая версия Kandinsky 5.0; требует ~35GB VRAM, на этих конфигурациях есть большой запас по видеопамяти для высокого разрешения и батчей. |
| Kandinsky-6.0-Pro-distill-5s-Diffusers | Текст/изображение в видео со звуком | ✅ | Модель для генерации 5-секундных видео с синхронизированным звуком по тексту или изображению. |
Технические характеристики
| Платформа | Supermicro SuperServer 2029GP-TR 2U 10SFF |
| Видеокарта | 6x NVIDIA Tesla V100 16GB HBM2 |
| Процессор | 2x Intel Xeon Platinum 8160 (24c/48t, 2.1GHz-3.7GHz, 150W) |
| Оперативная память | 12x 32GB DDR4 ECC REG Micron 2666Mhz 2Rx4 |
| SSD накопитель | 2x Intel S4510 480GB 2.5" 6Gb/s
2x Intel D5-P5530 960GB 2.5" U.2 |