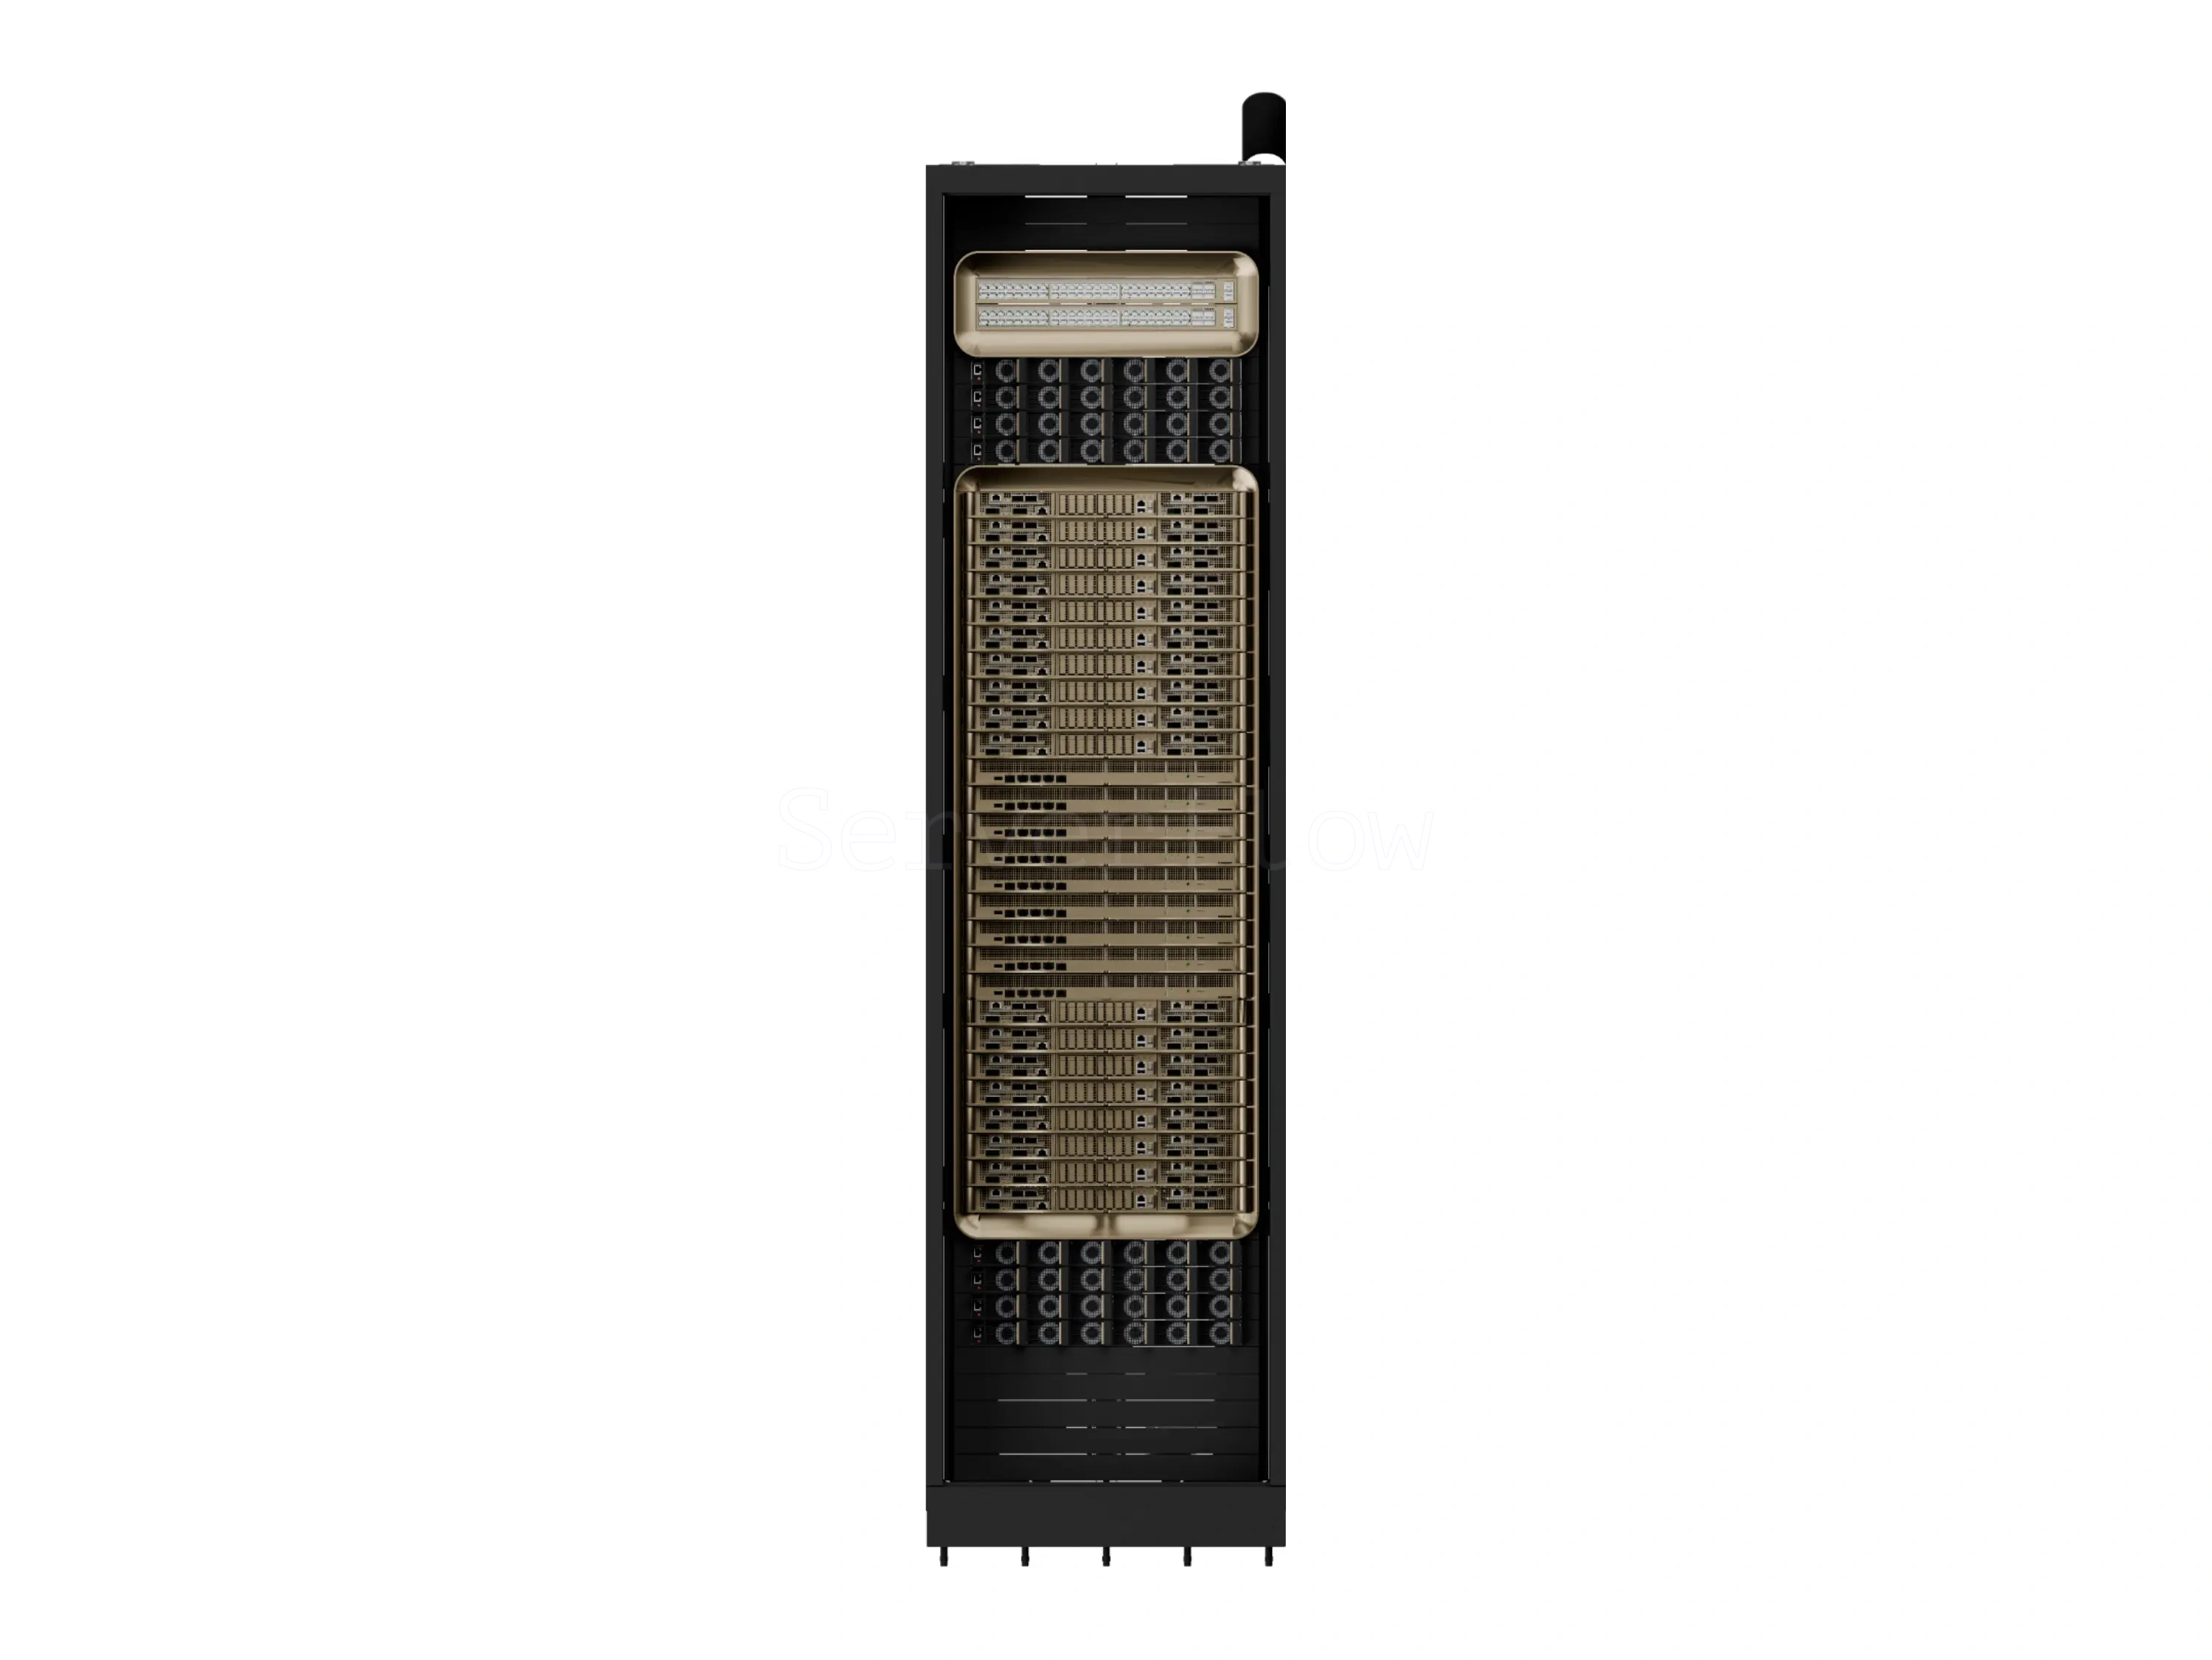
NVIDIA GB300 NVL72 (36x GB300 Grace Blackwell Ultra)
913 344 500 ₽
Цена ориентировочная. Информация в каталоге не является публичной офертой.
- Артикул
- SF-24508
- Наличие
- Уточняется
- Обновлено
- 12.11.2026
Поставки организациям и ИП для бизнеса. Для оформления заказа свяжитесь с менеджером и согласуйте итоговую цену, комплектацию и наличие. Контакты менеджера
Характеристики
- Тип
- Новые
- Основная задача
- Обучение моделей / Инференс / Дообучение моделей / RAG-системы / Анализ данных / Научные расчеты (HPC) / Визуализация и рендеринг
- Процессор (CPU)
- NVIDIA GB300 (Grace)
- Видеокарта (GPU)
- NVIDIA GB300 (Blackwell Ultra)
- Количество GPU, шт
- 72
- Общий объем видеопамяти (VRAM), ГБ
- 20088
- Тип памяти GPU
- HBM3e
- Объем оперативной памяти (RAM), ГБ
- 17856
- Тип оперативной памяти
- LPDDR5x
- Форм-фактор
- 48U
- Тип точности Совокупная мощность системы
- Совокупная мощность системы
- FP4 Tensor core
- 1440 PFLOPS
- FP8 Tensor core
- 720 PFLOPS
- FP6 Tensor core
- 720 PFLOPS
- FP16 Tensor core
- 360 PFLOPS
- BF16 Tensor core
- 360 PFLOPS
- FP32
- 6 PFLOPS
- TF32 Tensor core
- 180 PFLOPS
- FP64 Tensor core
- 100 TFLOPS
- INT8
- 24 POPS
Описание
NVIDIA GB300 NVL72 - это стоечная AI-система нового поколения для Обучения моделей (Training), Дообучения моделей (Fine-tuning), Инференса / Развертывания (Inference), RAG-систем (Retrieval-Augmented Generation), Анализа данных (Data Science) и HPC / Научных расчётов. Платформа объединяет 72 ускорителя NVIDIA Blackwell Ultra и 36 процессоров NVIDIA Grace в единую rack-scale архитектуру, ориентированную на reasoning-модели, большие агентные системы и тяжёлые корпоративные AI-нагрузки.
Система располагает 20 ТБ HBM3e VRAM с пропускной способностью до 576 ТБ/с и 17 ТБ LPDDR5X, а общий объём быстрой памяти достигает 37 ТБ. Между GPU используется NVLink 5 с суммарной полосой до 130 ТБ/с, что позволяет эффективно масштабировать многомодельный инференс, обучение и работу с очень длинным контекстом.
Архитектура Blackwell Ultra поддерживает FP4, FP8/FP6, FP16/BF16, INT8, а также оптимизирована под современные CUDA-фреймворки, включая vLLM, TensorRT-LLM и SGLang. В сравнении с предыдущим поколением Blackwell GB300 NVL72 предлагает 1,5× больше плотной FP4-производительности и 2× более высокую производительность attention-слоёв. Это платформа прежде всего для AI-фабрик и крупных вычислительных центров, а не для классических задач рендеринга или рабочей визуализации.
Производительность GPU
| Тип точности | Совокупная мощность системы |
| FP4 Tensor core | 1440 PFLOPS |
| FP8 Tensor core | 720 PFLOPS |
| FP6 Tensor core | 720 PFLOPS |
| FP16 Tensor core | 360 PFLOPS |
| BF16 Tensor core | 360 PFLOPS |
| FP32 | 6 PFLOPS |
| TF32 Tensor core | 180 PFLOPS |
| FP64 Tensor core | 100 TFLOPS |
| INT8 | 24 POPS |
Совместимость с LLM-моделями
| Модель | Тип квантизации | Требуется VRAM | Совместимость | Примечание |
| DeepSeek-V4-Pro | Нет | Примерно 865GB | ✅ | GB300 NVL72 уверенно запускает модель с огромным запасом под длинный контекст, KV-cache, большие батчи и высокий параллелизм запросов. |
| Qwen3.8-2.4T-A95B | Нет | Примерно 4.89TB | ✅ | Крупная MoE-модель для серверов с большим объёмом GPU-памяти; подходит для сложных reasoning-задач, RAG, агентных сценариев и production-инференса. Для стабильной работы требуется распределение по нескольким GPU и достаточный запас памяти под KV-cache, длинный контекст и параллельные запросы. |
| Gpt-oss:120b | Нет | Примерно 196GB | ✅ | Для такой модели система имеет колоссальный запас по памяти и вычислениям, что полезно для длинного контекста, высокой concurrency и плотного размещения инстансов. |
| GigaChat3.5-432B-A28B-bf16 | Нет | Примерно 868GB | ✅ | GB300 NVL72 подходит для крупномасштабного инференса этой модели, включая длинный контекст, большие батчи и параллельное обслуживание множества пользователей. |
| Mistral-Large-3-675B-Instruct-251 | Нет | Примерно 682GB | ✅ | Платформа даёт большой резерв для длинных контекстных окон, крупных батчей, корпоративного serving и высокой плотности одновременных запросов. |
| GLM-5.3 | Нет | Примерно 756GB | ✅ | GB300 NVL72 рассчитан на модели такого класса и сохраняет крупный запас под KV-cache, параллельные сессии, большие контексты и масштабный инференс. |
| Gemma-4-31B-IT-NVFP4 | NVFP4 (FP4 для NVIDIA) | Примерно 32.7GB | ✅ | Для GB300 NVL72 это крайне лёгкая модель, которую удобно масштабировать на большое число параллельных инстансов с длинным контекстом и очень высокой плотностью запросов. |
| NVIDIA-Nemotron-3-Super-120B-A12B-NVFP4 | NVFP4 (FP4 для NVIDIA) | Примерно 80.4GB | ✅ | GB300 NVL72 запускает такую модель с огромным запасом по памяти и производительности, что удобно для большого числа одновременных инстансов, длинного контекста и высоконагруженного serving. |
| Kimi-K3 | Нет | Примерно 1.56TB | ✅ | Полноразмерная версия для мощных GPU-серверов; подходит для reasoning-задач, RAG, агентных рабочих процессов и производственного инференса с высоким запасом качества. |
| MiniMax-M3 | Нет | Примерно 854GB | ✅ | Полноразмерная версия для серверов с большим запасом памяти; подходит для reasoning-задач, RAG, агентных сценариев и стабильного production-инференса без агрессивной квантизации. |
| MiMo-V2.5-Pro | Нет | Примерно 1.03TB | ✅ | Крупная Pro-версия для серверов с большим объёмом GPU-памяти; подходит для сложных reasoning-задач, RAG, агентных сценариев и production-инференса с высоким запасом качества. |
Совместимость с диффузионными моделями
| Модель | Тип | Совместимость | Примечание |
| Stable Diffusion XL 1.0 | Текст в изображение | ✅ | GB300 NVL72 легко справляется с high-res генерацией, крупными батчами и массовым параллельным запуском графических пайплайнов. |
| Flux.2-dev | Текст в изображение | ✅ | Масштаб системы позволяет повышать разрешение, ускорять обработку и одновременно обслуживать большое число генеративных очередей. |
| SD Turbo | Быстрые предпросмотры | ✅ | Подходит для экстремально высокой параллельности и быстрого создания большого количества превью в продуктивных рабочих потоках. |
| Kandinsky-5.0-T2I-Lite-sft-Diffusers | Текст в изображение | ✅ | Можно одновременно запускать множество независимых генеративных пайплайнов с большим запасом по памяти и вычислительным ресурсам. |
| Kandinsky-6.0-Pro-distill-5s-Diffusers | Текст/изображение в видео со звуком | ✅ | Платформа хорошо подходит для параллельной генерации коротких видеороликов и ускорения тяжёлых видеодиффузионных сценариев. | NVIDIA-Cosmos3-Super | Генерации, анализа и симуляции физического мира, которая может работать с текстом, изображениями, видео и действиями | ✅ | Модель объёмом 133 GB для генерации, анализа и симуляции физического мира. Работает с текстом, изображениями, видео и действиями, поэтому подходит для сложных мультимодальных сценариев. Требует высокой производительности и большого объёма видеопамяти, а стабильность запуска зависит от конкретной конфигурации и настроек оптимизации. |