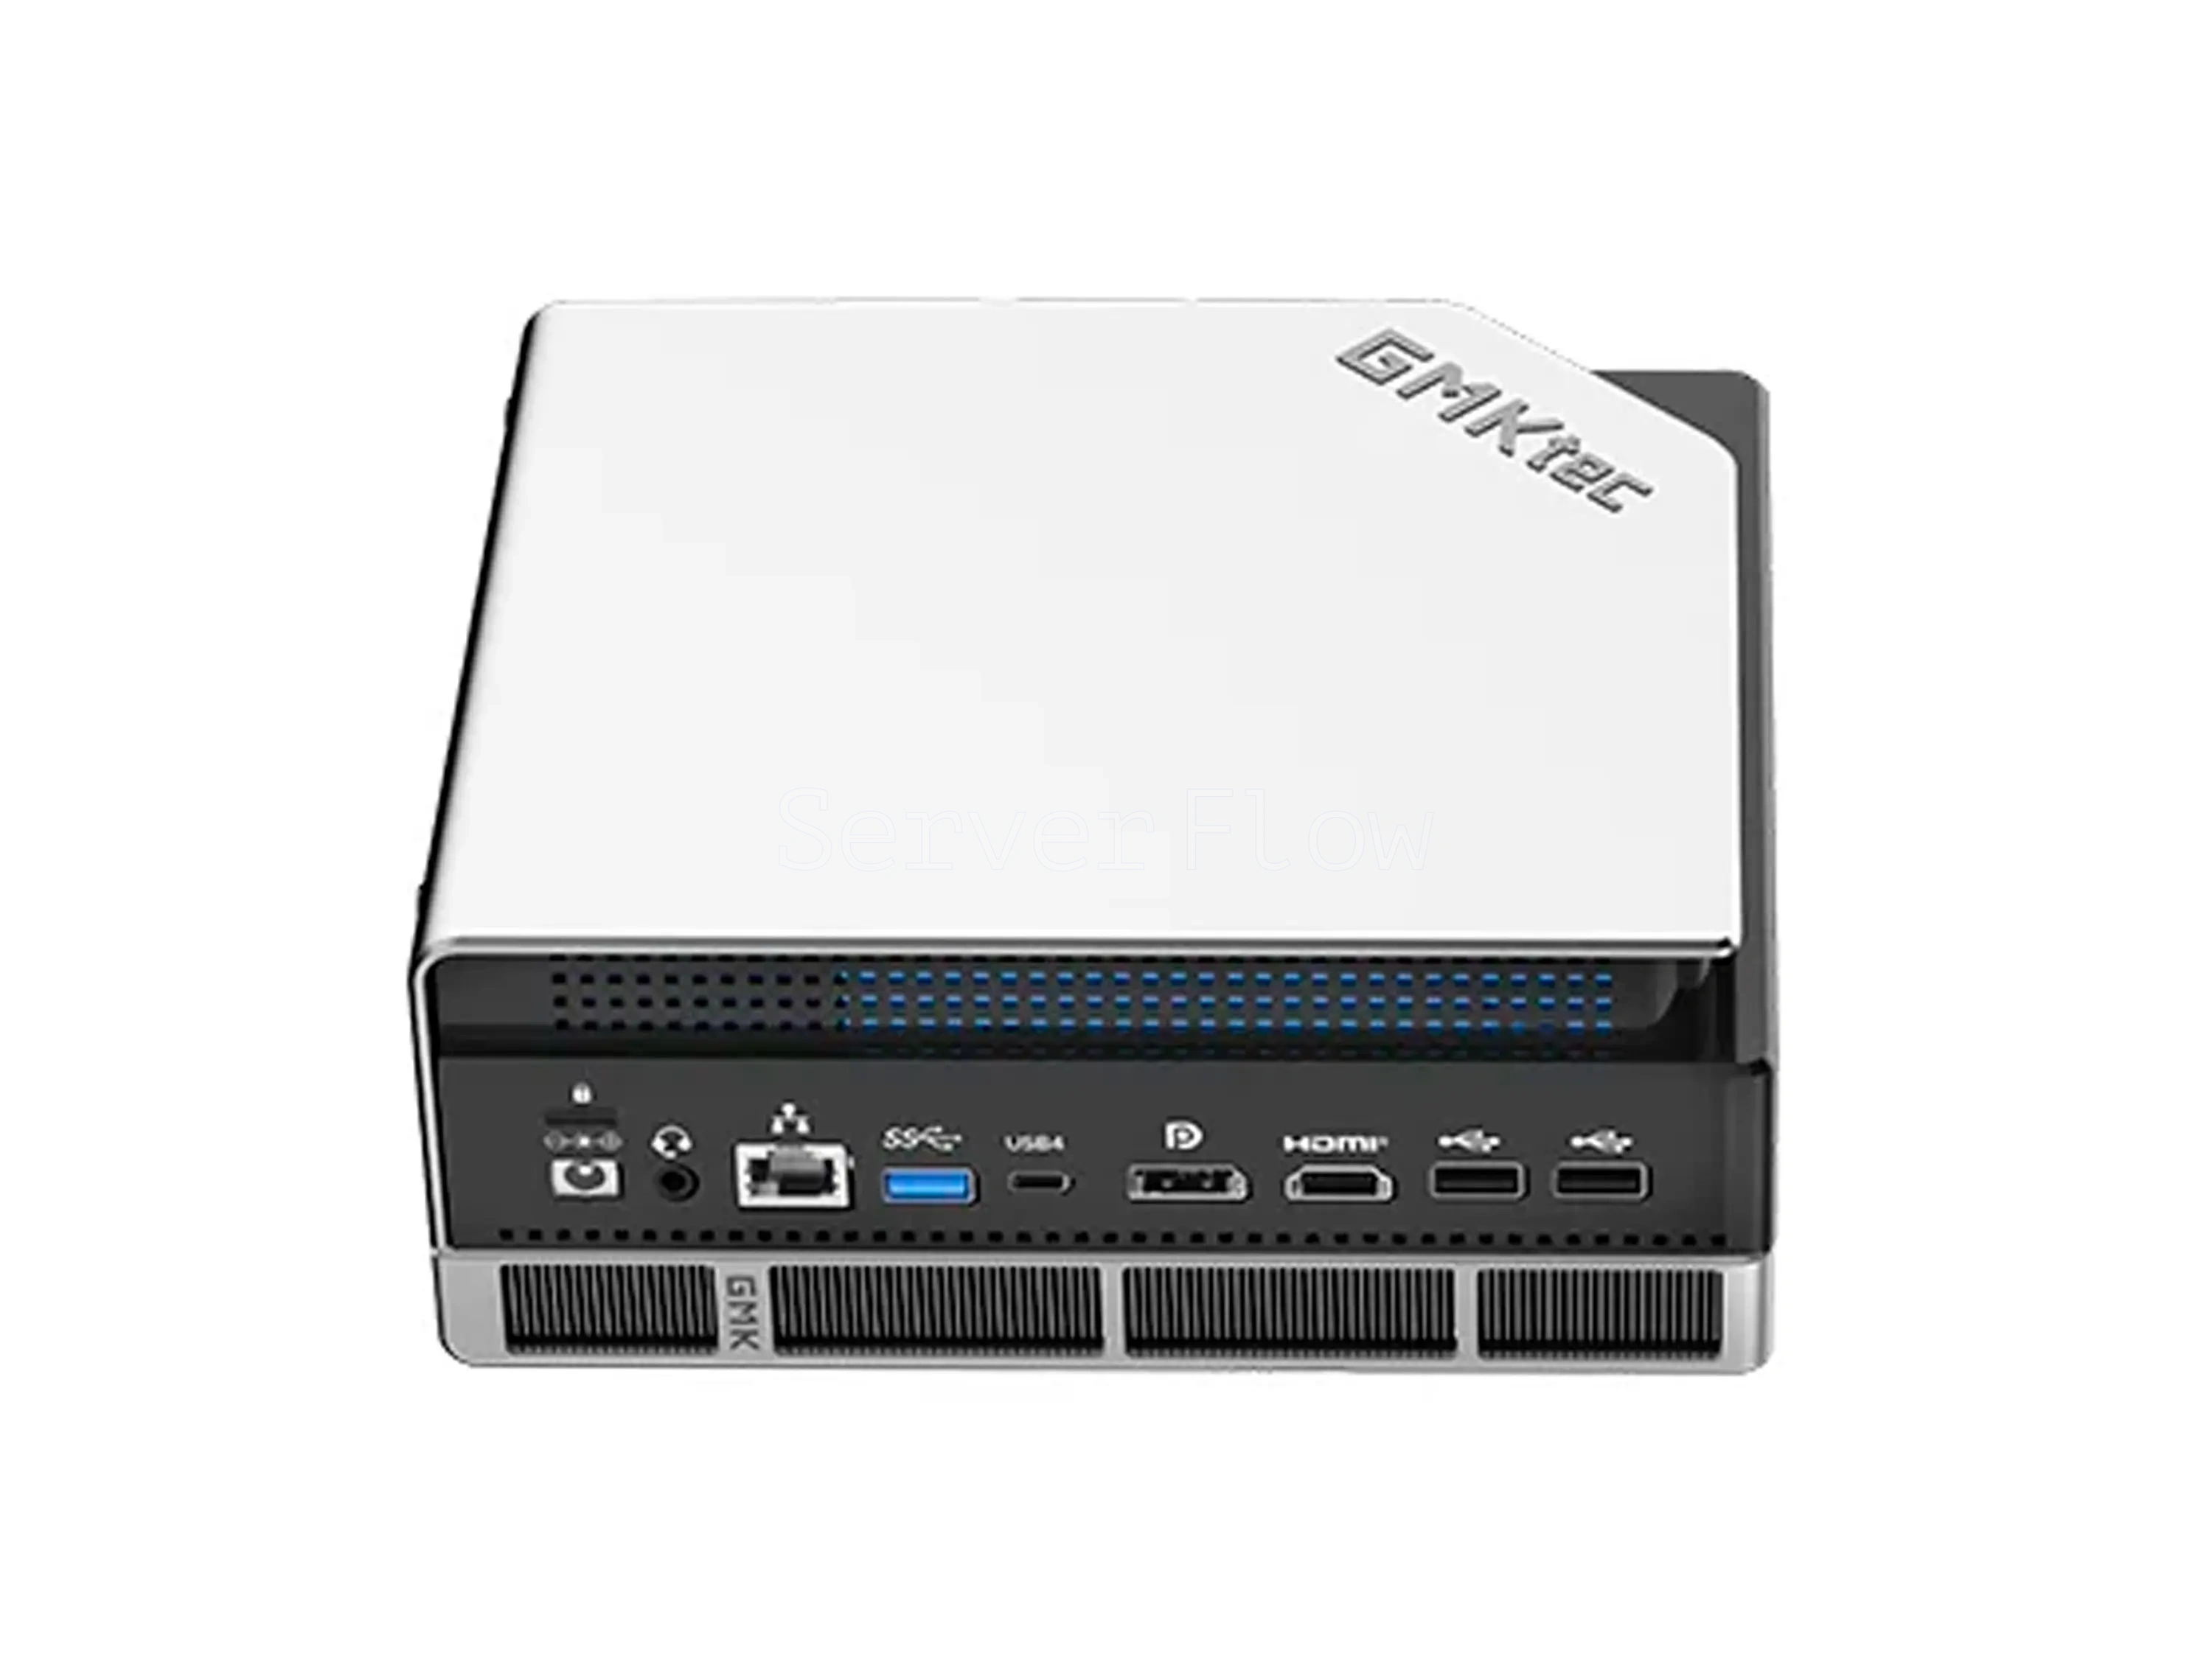
GMKtec EVO-X2 (Radeon 8060S, Ryzen AI Max+ 395, RAM 128GB)
905 200 ₽
Цена ориентировочная. Информация в каталоге не является публичной офертой.
- Артикул
- SF-21854
- Наличие
- Уточняется
- Обновлено
- 12.11.2026
Поставки организациям и ИП для бизнеса. Для оформления заказа свяжитесь с менеджером и согласуйте итоговую цену, комплектацию и наличие. Контакты менеджера
Характеристики
- Тип
- Новые
- Основная задача
- Инференс / Дообучение моделей / RAG-системы / Анализ данных / Визуализация и рендеринг
- Процессор (CPU)
- AMD Ryzen AI Max+ 395
- Видеокарта (GPU)
- AMD Radeon 8060S (Встроенная)
- Количество GPU, шт
- 1
- Общий объем видеопамяти (VRAM), ГБ
- 128
- Тип памяти GPU
- LPDDR5x
- Объем оперативной памяти (RAM), ГБ
- 128
- Тип оперативной памяти
- LPDDR5x
- Форм-фактор
- SFF
- Категория
- Мощность
- Overall
- 126 TOPS
- NPU
- 50 TOPS
Описание
GMKtec EVO-X2 - компактный мини компьютер для задач Инференс / Развертывание (Inference), RAG-системы (Retrieval-Augmented Generation), Анализ данных (Data Science) и Визуализация и рендеринг. Он подходит для локальных ассистентов, работы с базами знаний и прототипирования AI-сценариев без дискретной видеокарты.
Внутри установлен APU AMD Ryzen AI Max+ 395 - это один чип, который объединяет CPU и встроенную графику, а также NPU для AI-ускорения. Встроенная AMD Radeon 8060S использует общую память, поэтому вместо отдельной VRAM применяется 128GB LPDDR5x как unified memory, что удобно для больших моделей и длинного контекста при правильных настройках.
По накопителям предусмотрен SSD объёмом 2TB, чего достаточно для локальных моделей, кэшей и баз данных для RAG.
Производительность
| Категория | Мощность |
| Overall | 126 TOPS |
| NPU | 50 TOPS |
Совместимость с LLM-моделями
| Модель | Тип квантизации | Требуется VRAM | Совместимость | Примечание |
| Qwen3.6-35B-A3B | Нет | Примерно 71.9GB | ✅ | На GMKtec EVO-X2 с 128GB unified memory запускается при достаточном выделении памяти под iGPU. Для стабильности держать умеренный контекст и использовать оптимизированный рантайм. |
| DeepSeek-R1-Distill-Qwen-32B | Нет | Примерно 65.5 | ✅ | Подходит для локального чат-бота и RAG, на iGPU лучше работают квантованные сборки и умеренный контекст. |
| gpt-oss-120b-GGUF | Q4_K_M | Примерно 62.8GB | ✅ | В Q4 помещается в 128GB unified memory, но скорость зависит от бэкенда. Для комфорта ограничивать контекст и включать потоковый вывод. |
| GLM-4.7-Flash | Нет | Примерно 62.5GB | ✅ | По памяти проходит на EVO-X2, для лучшей отзывчивости выбирать оптимизированные сборки и не завышать batch и контекст. |
| Gemma-4-31B-it | Нет | Примерно 62.6GB | ✅ | Подходит для локального запуска модели и оставляет достаточно памяти под контекст, служебные данные и повседневные сценарии. |
| NVIDIA-Nemotron-3-Super-120B-A12B-GGUF | UD-Q4_K_M | Примерно 82.5GB | ✅ | Удобна для параллельного запуска нескольких инстансов, работы с длинным контекстом и высокой плотности запросов. |
Совместимость с диффузионными моделями
| Модель | Тип | Совместимость | Примечание |
| Stable Diffusion 3 Medium (SD3-M) | Текст в изображение | ✅ | Работает на Radeon 8060S, комфортнее умеренные разрешения и batch. High-res заметно увеличивает время генерации. |
| FLUX.2-klein-9B | Текст в изображение | ✅ | Хороша для быстрых генераций, удобнее запускать через ComfyUI или ONNX сборки, если доступны. |
| Stable Video Diffusion 1.1 (SVD 1.1) | Видео (img2vid) | ✅ | Unified memory помогает по буферам, но iGPU ограничивает скорость. Лучше короткие ролики и умеренное разрешение. |
| Kandinsky-5.0-T2I-Lite-sft-Diffusers | Текст в изображение | ✅ | Лёгкая модель, можно держать дополнительные узлы пайплайна без жёстких упоров в память. |
| Kandinsky-6.0-Pro-distill-5s-Diffusers | Текст/изображение в видео со звуком | ✅ | Удобно для коротких роликов, для стабильной скорости лучше не завышать длину и разрешение. |