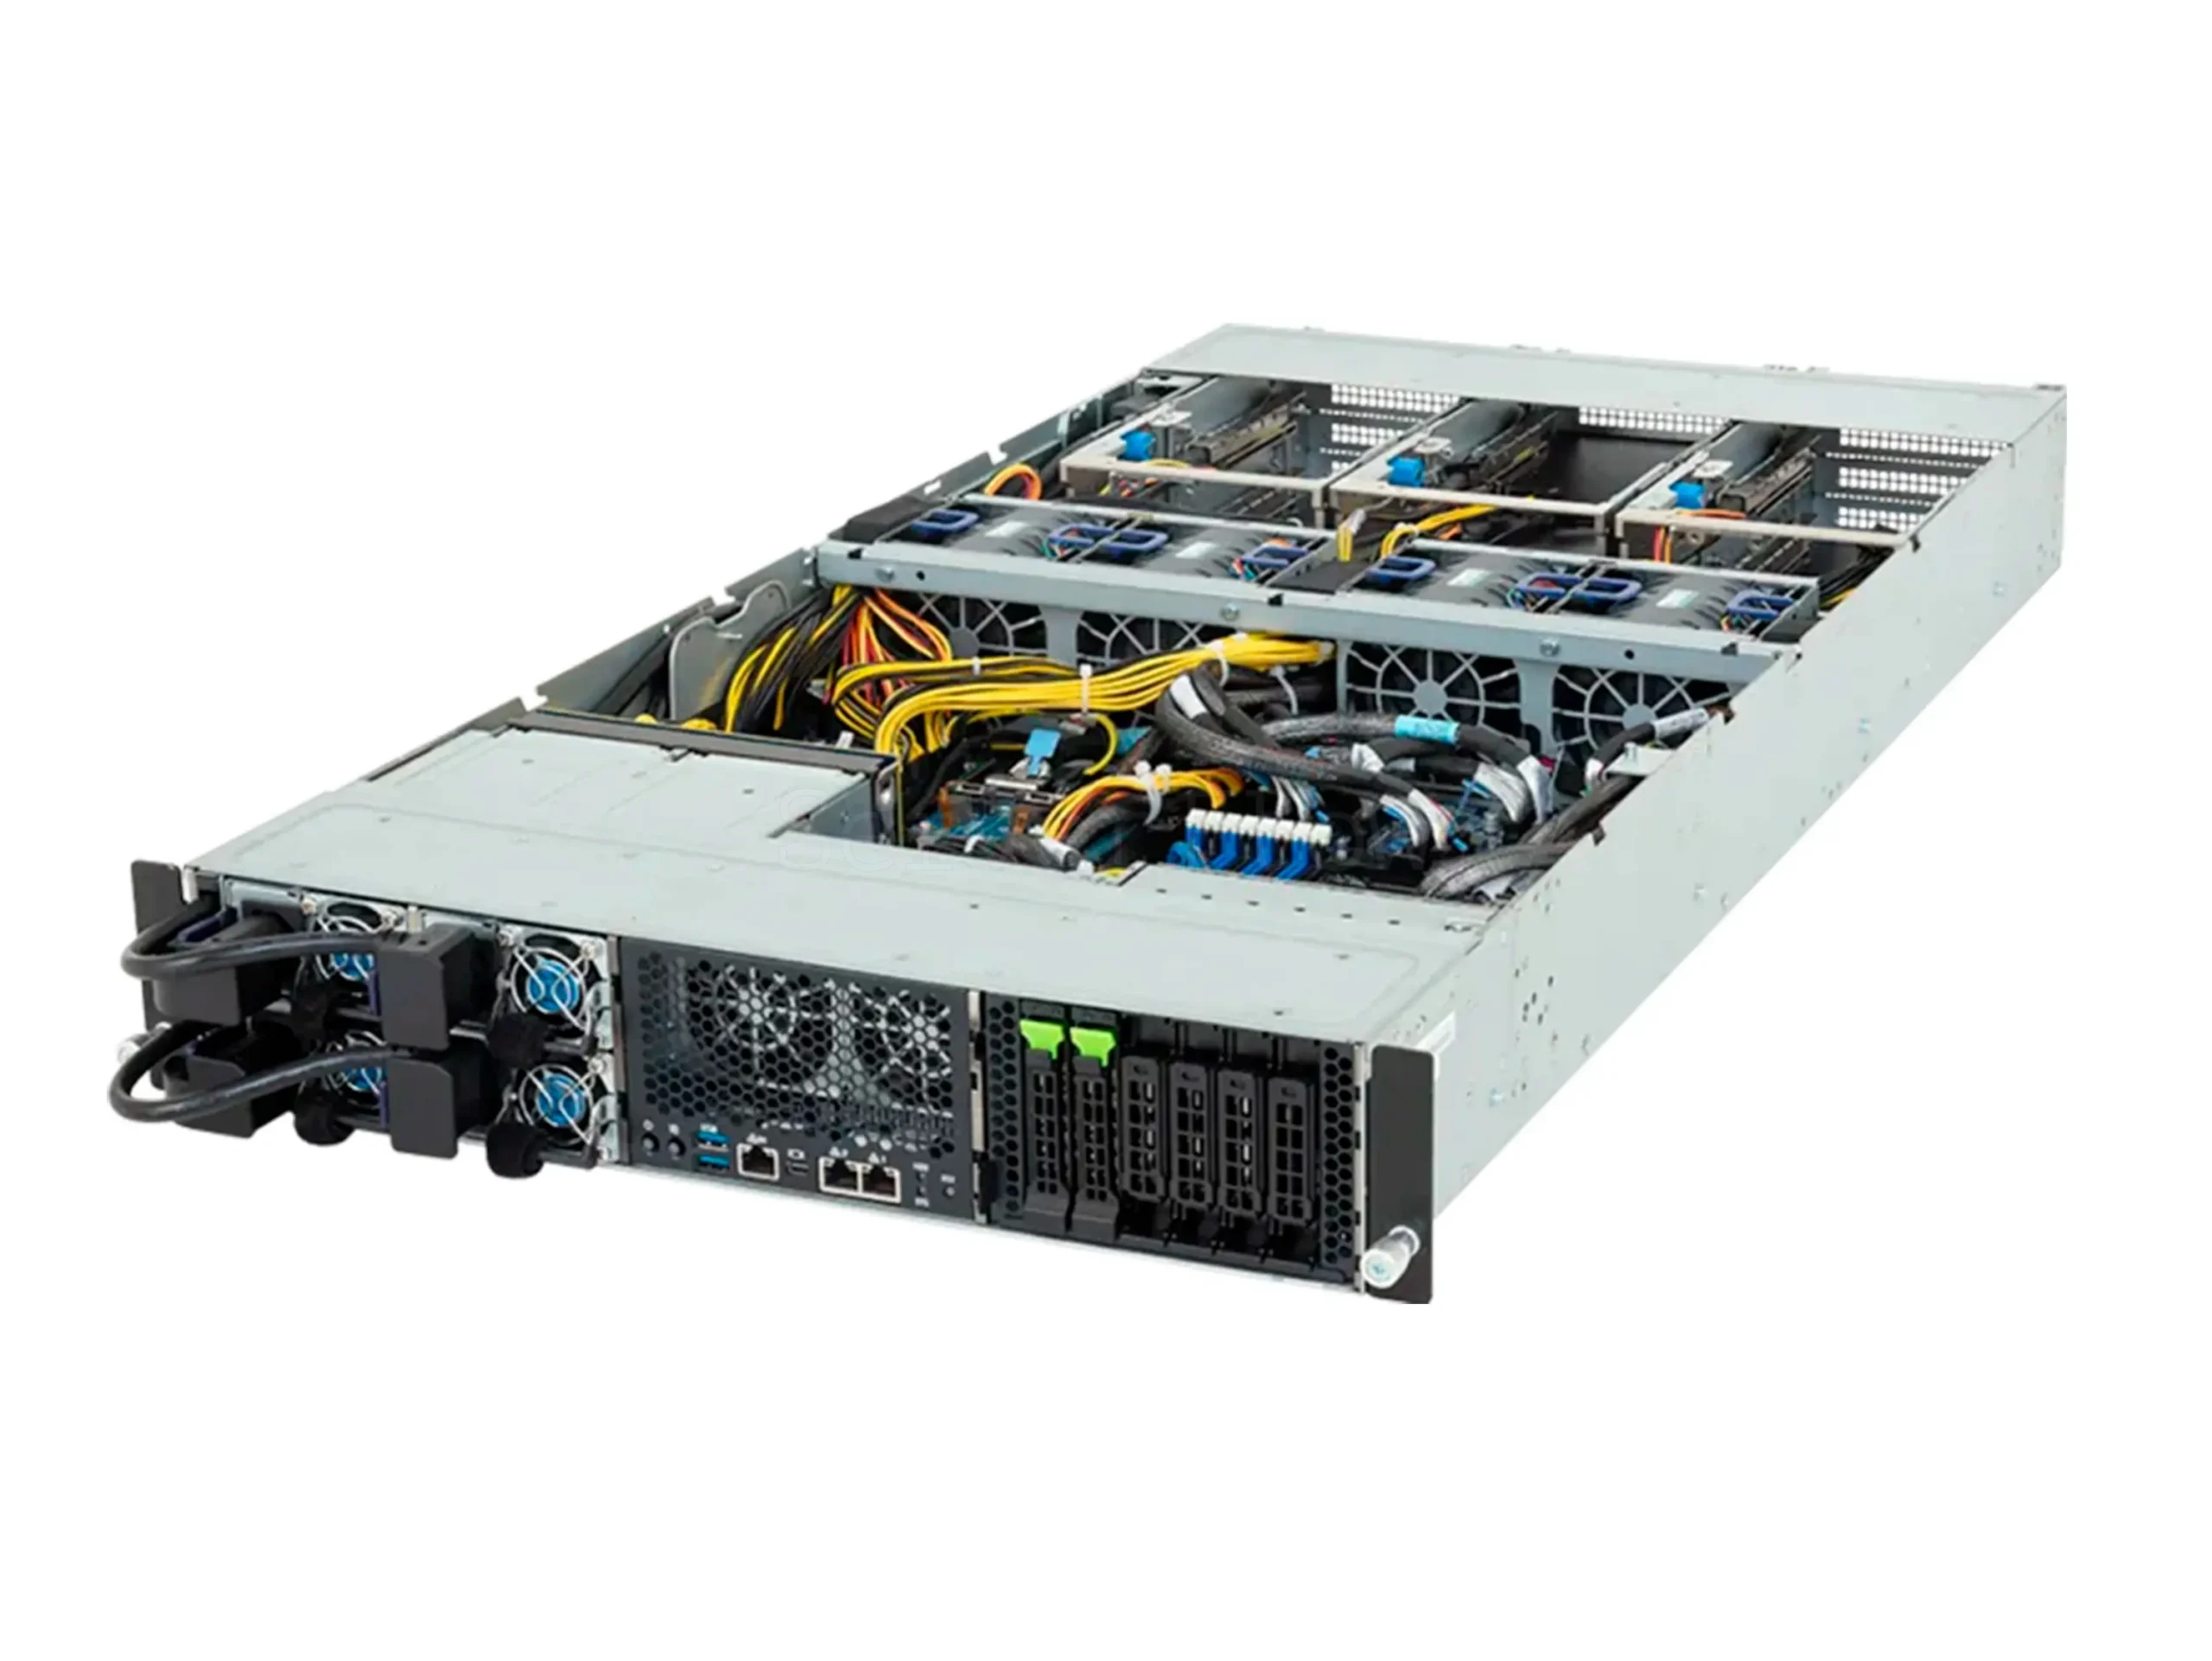
GIGABYTE XV24-SU0-AAJ1 (4× RTX PRO 6000 BSE 96GB, 1× Xeon 6737P, RAM 768GB)
30 753 100 ₽
Цена ориентировочная. Информация в каталоге не является публичной офертой.
- Артикул
- SF-19740
- Наличие
- Уточняется
- Обновлено
- 12.11.2026
Поставки организациям и ИП для бизнеса. Для оформления заказа свяжитесь с менеджером и согласуйте итоговую цену, комплектацию и наличие. Контакты менеджера
Характеристики
- Тип
- Новые
- Основная задача
- Обучение моделей / Инференс / Дообучение моделей / RAG-системы / Визуализация и рендеринг
- Процессор (CPU)
- Intel Xeon 6-series
- Видеокарта (GPU)
- NVIDIA RTX PRO 6000 Blackwell
- Количество GPU, шт
- 4
- Общий объем видеопамяти (VRAM), ГБ
- 384
- Тип памяти GPU
- GDDR7
- Объем оперативной памяти (RAM), ГБ
- 768
- Тип оперативной памяти
- DDR5 ECC REG
- Форм-фактор
- 2U
- Тип точности Совокупная мощность четырех RTX PRO 6000 BSE
- Совокупная мощность четырех RTX PRO 6000 BSE
- FP32
- 480 TFLOPS
- FP4
- 16 PFLOPS
- RT Core performance*
- 1420 TFLOPS
- Платформа
- GIGABYTE XV24-SU0-AAJ1
- Видеокарта
- 4x NVIDIA RTX PRO 6000 Blackwell Server Edition 96GB GDDR7
- Процессор
- 1x Intel Xeon 6737P (32c/64t, 2.9GHz-4.0GHz, 270W)
- Оперативная память
- 6x 128GB DDR5 ECC REG Micron 6400Mhz 2Rx4
- SSD накопитель
- 1x Solidigm D7-PS1030 6.4TB 2.5" U.2
- Сетевая карта
- 2x NVIDIA MCX713106AC-VEAT (2x QSFP112 200GBE)
Описание
Это наша сборка на Северной платформе Gigabyte XV24-SU0-AAJ1: компактный высокоплотный узел под 4 GPU, рассчитанный на продакшн-нагрузки и масштабирование по сети. Конфигурация отлично закрывает Инференс / Развертывание (Inference) и RAG-системы (Retrieval-Augmented Generation) - можно держать длинный контекст, несколько реплик и параллельные пайплайны без постоянной борьбы за память.
4× NVIDIA RTX PRO 6000 Blackwell Server Edition 96GB GDDR7 дают 384GB суммарной VRAM - этого хватает для запуска больших LLM в multi-GPU режиме (tensor/pipeline parallel) и для тяжёлых генеративных пайплайнов. Сервер также подходит для Дообучение моделей (Fine-tuning) и Обучение моделей (Training) (особенно когда важен большой batch/градиенты и стабильная работа на FP16/FP8 в современном стеке CUDA).
Сильная сторона именно этой конфигурации - баланс GPU + память + сеть: 768GB DDR5 ECC REG позволяют держать крупные датасеты/индексы RAG в RAM, а 2× NVIDIA MCX713106AC-VEAT (итого 4 порта 200GbE QSFP112) - удобно для распределённых сценариев (несколько узлов, внешние хранилища, высокие QPS-кластеры).
Производительность GPU
| Тип точности | Совокупная мощность четырех RTX PRO 6000 BSE |
| FP32 | 480 TFLOPS |
| FP4 | 16 PFLOPS |
| RT Core performance* | 1420 TFLOPS |
*-RT Core performance - это пиковая производительность специализированных RT-ядер (Ray Tracing Cores), которые аппаратно ускоряют операции трассировки лучей (поиск пересечений луча с геометрией и обход BVH). Показатель важен для визуализации/рендеринга и некоторых графических/3D-пайплайнов, но не является прямым аналогом FP32/AI-производительности.
Совместимость с LLM-моделями
| Модель | Тип квантизации | Требуется VRAM | Совместимость | Примечание |
| DeepSeek-R1-Distill-Llama-70B | Нет | Примерно 141GB | ✅ | Запускается на одном сервере в multi-GPU режиме (обычно 2–4 GPU) через tensor/pipeline parallel (vLLM/TensorRT-LLM). Хорош для reasoning и длинного контекста; запас общей VRAM можно отдать под KV-cache и высокий QPS. |
| Qwen3.8-27B | Нет | Примерно 55.6GB | ✅ | Хороший кандидат для “большой модели на одном узле”: запускается с распределением по 4 GPU, остаётся запас под KV-cache и несколько параллельных запросов. Подходит для агентов, продакшн-чатов и RAG с высоким QPS. |
| gpt-oss:120b | Нет (FP16) | Примерно 260GB | ✅ | Комфортно работает на одном узле при распределении по 4 GPU. Хороший баланс “размер модели ↔ пропускная способность”: можно держать модель без квантизации и при этом оставить ресурс под несколько потоков инференса и увеличенный KV-cache. |
| Mistral-Large-3-675B-Instruct-2512-GGUF | IQ4_XS | Примерно 360GB | ⚠️ | Запуск возможен в рамках 4×96GB, но “впритык”: потребуется аккуратная настройка контекста и batch size. Рекомендуется vLLM и контроль KV-cache, чтобы сохранить стабильную латентность. |
| GLM-5.3-Flash | Нет | Примерно 328GB | ✅ | Для стабильной работы рекомендуются умеренный контекст, грамотное распределение по 4 GPU и продакшн-движок (TensorRT-LLM/vLLM). |
| GigaChat3.5-432B-A28B-GGUF | Q4_K_M | Примерно 262GB | ✅ | Отлично подходит для reasoning, кода, анализа текста и ассистентских задач. |
| NVIDIA-Nemotron-3-Super-120B-A12B-NVFP4 | NVFP4 (FP4 для NVIDIA) | Примерно 80.4GB | ✅ | Удобна для параллельного запуска нескольких инстансов, работы с длинным контекстом и высокой плотности запросов. |
| MiniMax-M3 | UD-Q4_K_M | Примерно 264GB | ✅ | Квантизированная версия с заметно меньшим объёмом; удобна для серверов с ограниченным запасом памяти, RAG-сценариев, ассистентов и локальных LLM-сервисов. |
| MiMo-V2.5 | Нет | Примерно 316GB | ✅ | Базовая версия среднего объёма для серверов с хорошим запасом памяти; подходит для RAG, корпоративных ассистентов, генерации текста и стабильного инференса без квантизации. |
Совместимость с диффузионными моделями
| Модель | Тип | Совместимость | Примечание |
| Stable Diffusion XL 1.0 | Текст в изображение | ✅ | На 4× RTX PRO 6000 BSE удобно параллелить пайплайны (несколько пользователей/очередей), держать большие batch и стабильно генерировать high-res. 96GB на GPU дают большой запас под upscalers и постобработку. |
| Flux.2-dev | Текст в изображение | ✅ | Требовательна к VRAM, но 96GB на GPU позволяют комфортно работать с высоким разрешением и батчами. Можно масштабировать throughput по нескольким GPU внутри одного сервера для стабильной high-res генерации. |
| SD Turbo | Быстрые предпросмотры | ✅ | Максимальная скорость итераций: легко держать много параллельных задач предпросмотра/серийных кадров на одном узле и обслуживать несколько потоков одновременно с низкой задержкой. |
| Kandinsky-5.0-T2I-Lite-sft-Diffusers | Текст в изображение | ✅ | Лёгкая модель: остаётся большой запас VRAM под высокое разрешение, батчи и одновременную работу нескольких пайплайнов на 4 GPU — удобно для многопользовательских сценариев. |
| Kandinsky-6.0-Pro-distill-5s-Diffusers | Текст/изображение в видео со звуком | ✅ | Для коротких роликов удобно распараллеливать генерацию по GPU: один сервер ускоряет пакетную обработку, держит несколько очередей и стабильно обслуживает серию задач на CUDA-стеке. |
| NVIDIA-Cosmos3-Super | Генерации, анализа и симуляции физического мира, которая может работать с текстом, изображениями, видео и действиями | ✅ | Модель объёмом 133 GB для генерации, анализа и симуляции физического мира. Работает с текстом, изображениями, видео и действиями, поэтому подходит для сложных мультимодальных сценариев. Требует высокой производительности и большого объёма видеопамяти, а стабильность запуска зависит от конкретной конфигурации и настроек оптимизации. |
Технические характеристики
| Платформа | GIGABYTE XV24-SU0-AAJ1 |
| Видеокарта | 4x NVIDIA RTX PRO 6000 Blackwell Server Edition 96GB GDDR7 |
| Процессор | 1x Intel Xeon 6737P (32c/64t, 2.9GHz-4.0GHz, 270W) |
| Оперативная память | 6x 128GB DDR5 ECC REG Micron 6400Mhz 2Rx4 |
| SSD накопитель | 1x Solidigm D7-PS1030 6.4TB 2.5" U.2 |
| Сетевая карта | 2x NVIDIA MCX713106AC-VEAT (2x QSFP112 200GBE) |