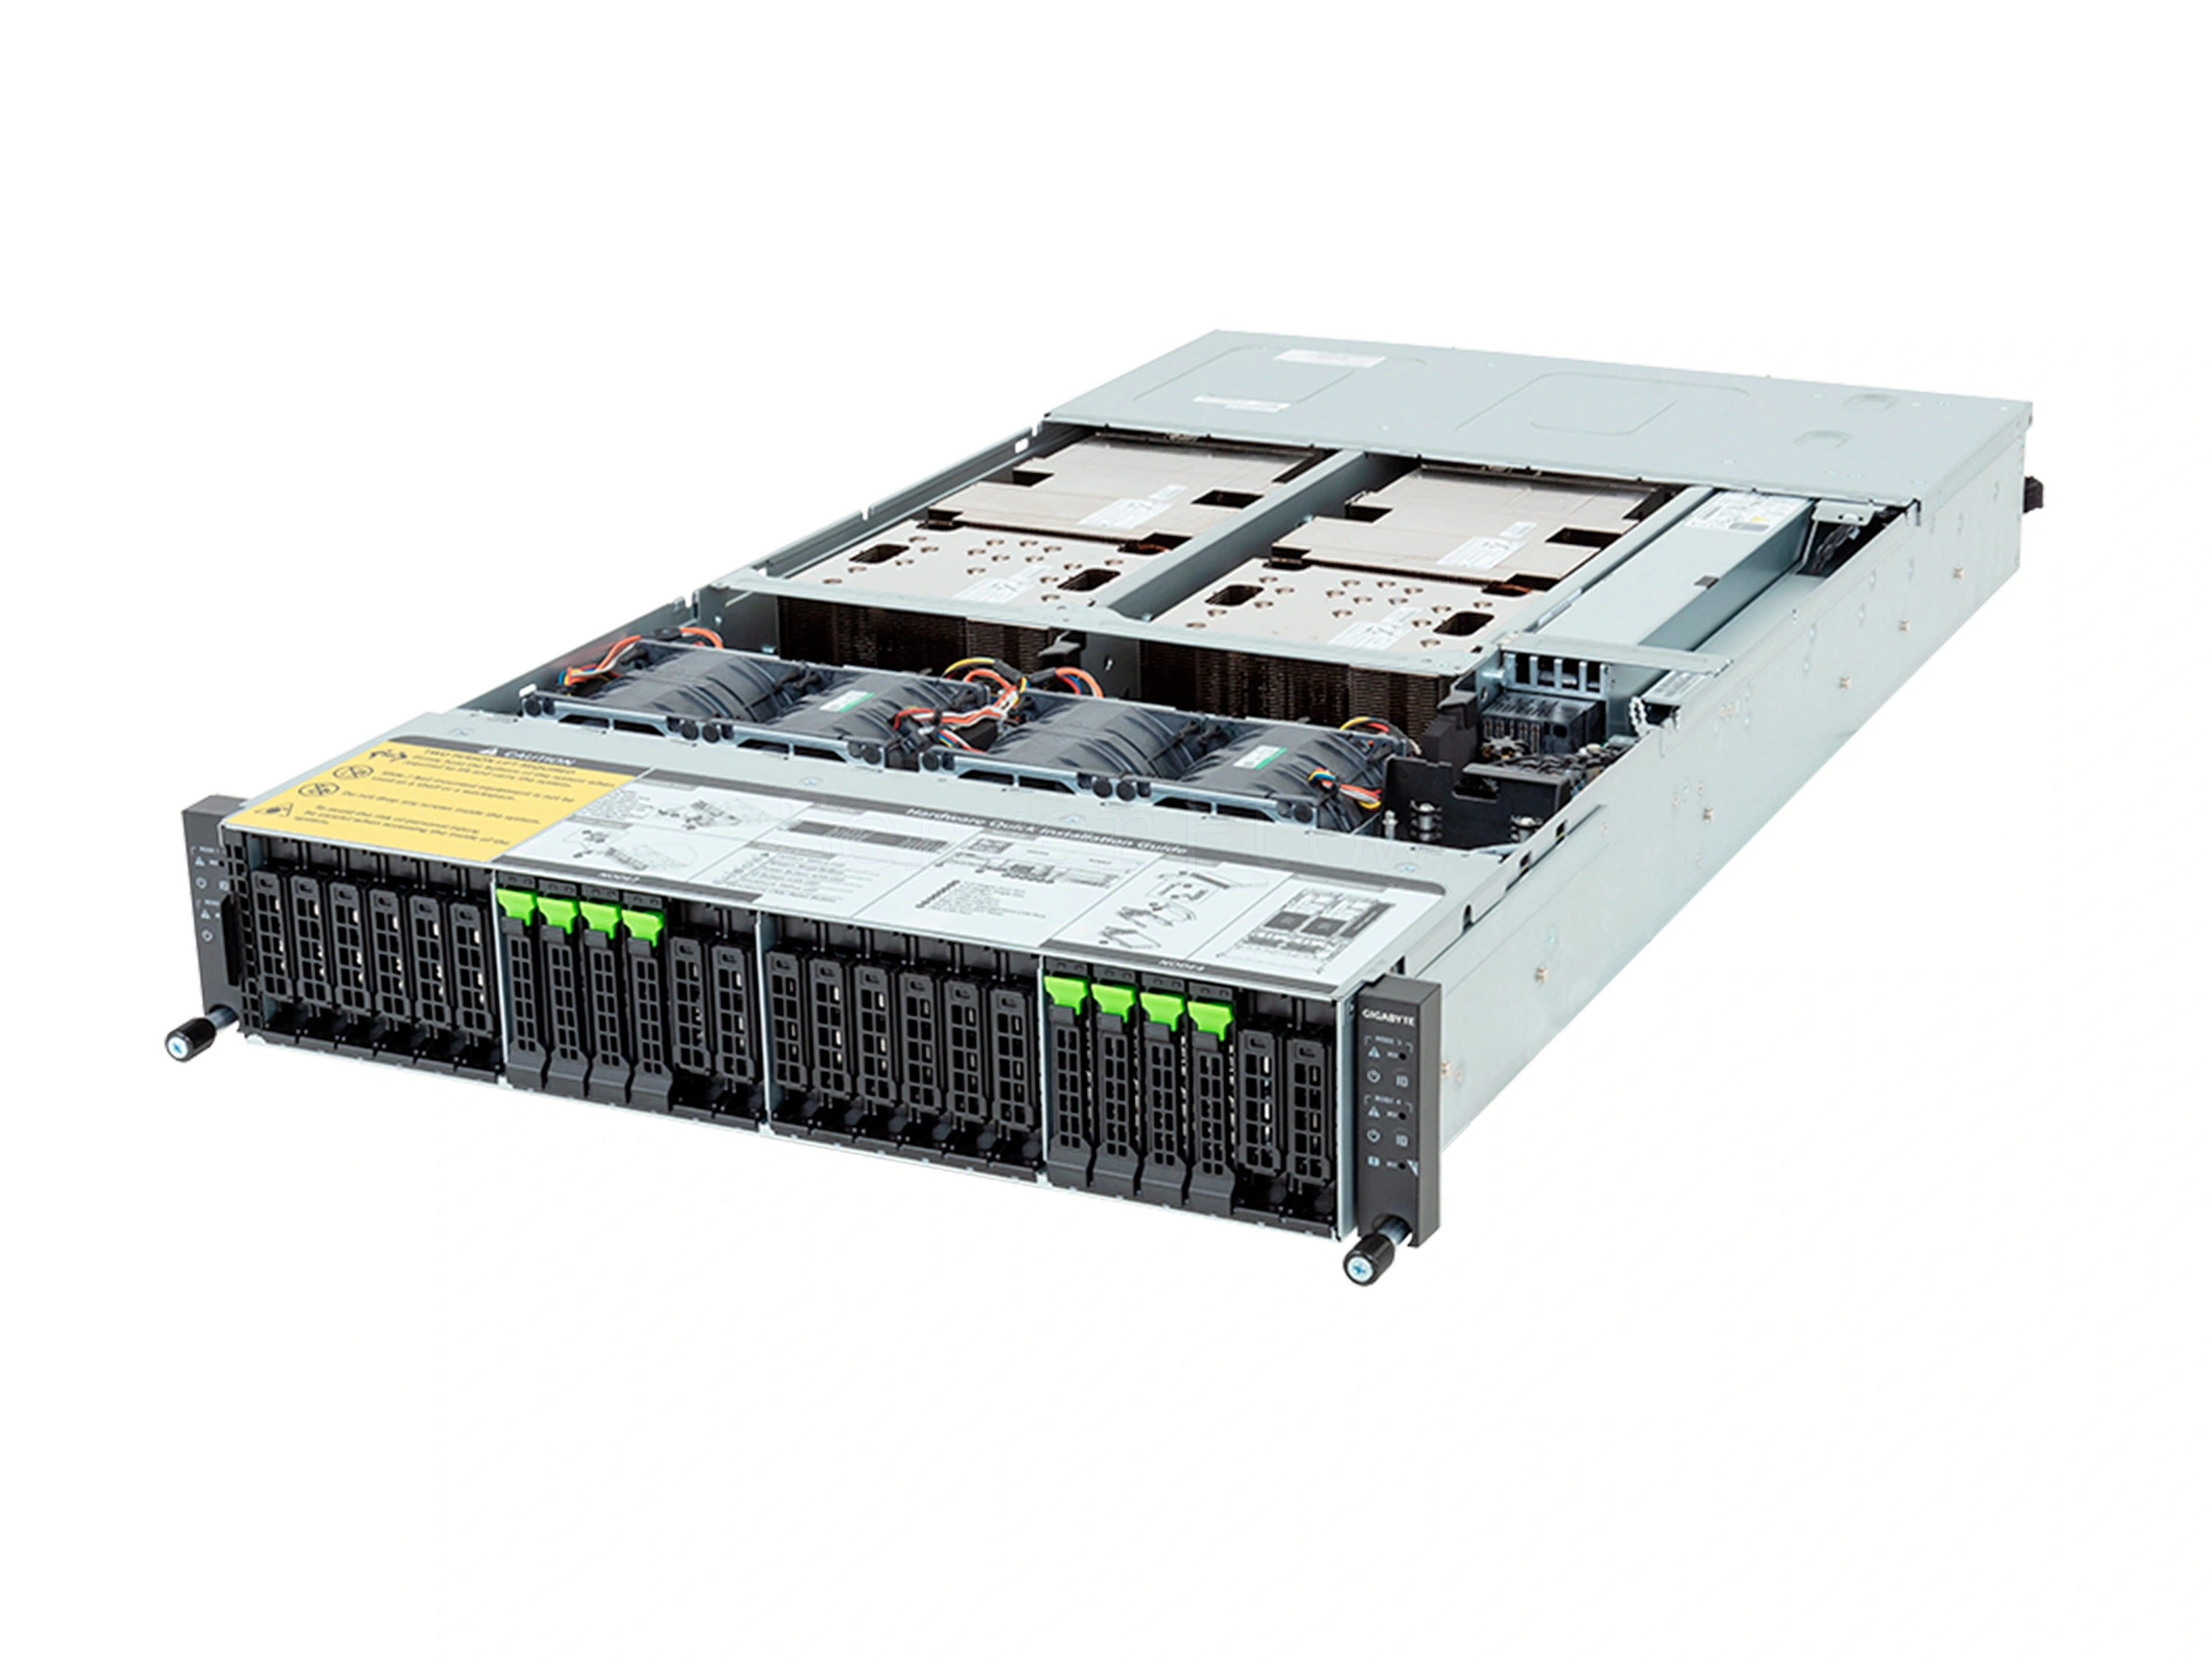
GIGABYTE H223-V10-AAW1 (2× GH200 144GB, RAM 960GB)
20 333 500 ₽
Цена ориентировочная. Информация в каталоге не является публичной офертой.
- Артикул
- SF-22824
- Партномер
- 6NH223V10MR000ABW1
- Наличие
- Уточняется
- Обновлено
- 12.11.2026
Поставки организациям и ИП для бизнеса. Для оформления заказа свяжитесь с менеджером и согласуйте итоговую цену, комплектацию и наличие. Контакты менеджера
Характеристики
- Тип
- Новые
- Парт.№
- 6NH223V10MR000ABW1
- Основная задача
- Инференс / Дообучение моделей / RAG-системы / Анализ данных / Научные расчеты (HPC)
- Процессор (CPU)
- NVIDIA GH200 (Grace)
- Видеокарта (GPU)
- NVIDIA GH200 (Hopper)
- Количество GPU, шт
- 2
- Общий объем видеопамяти (VRAM), ГБ
- 288
- Тип памяти GPU
- HBM3e
- Объем оперативной памяти (RAM), ГБ
- 960
- Тип оперативной памяти
- LPDDR5x
- Форм-фактор
- 2U
- Тип точности Совокупная мощность двух GH200
- Совокупная мощность двух GH200
- FP8 Tensor Core
- 7916 TFLOPS
- BF16 / FP16 Tensor Core
- 3958 TFLOPS
- TF32 Tensor Core
- 1979 TFLOPS
- FP32
- 134 TFLOPS
- FP64 Tensor Core
- 134 TFLOPS
- INT8 Tensor Core
- 7916 TOPS
- Платформа
- GIGABYTE H223-V10-AAW1
- Видеокарта / Процессор
- 2x NVIDIA GH200 (Grace Hopper) 288GB HBM3e
- Оперативная память
- 960GB ECC LPDDR5X
- SSD накопитель
- 8x 2.5" Gen5 NVMe (4x 2.5" Gen5 NVMe) 4x M.2 NVMe (2280/22110)
Описание
GIGABYTE H223-V10-AAW1 - это 2U-платформа для инференса / развертывания, RAG-систем, дообучения моделей и научных расчётов. Внутри находятся два независимых узла с собственными модулями NVIDIA GH200, поэтому по своей идее сервер напоминает блейд-систему - в одном корпусе размещены сразу две отдельные вычислительные платформы. Суммарно система получает 288GB HBM3e и 960GB ECC LPDDR5X, что хорошо подходит для крупных моделей, длинного контекста и задач с большим объёмом памяти.
Преимущество такой схемы в том, что два узла можно использовать независимо друг от друга. Например, один GH200 можно выделить под инференс или RAG, а второй - под дообучение, тестирование или отдельный сервис. По сравнению с обычным сервером на двух GPU здесь проще разделять нагрузку между командами и задачами, а также эффективнее использовать место в стойке, питание и охлаждение, потому что фактически вы получаете два отдельных AI-сервера в одном 2U-корпусе.
Производительность GPU
| Тип точности | Совокупная мощность двух GH200 |
| FP8 Tensor Core | 7916 TFLOPS |
| BF16 / FP16 Tensor Core | 3958 TFLOPS |
| TF32 Tensor Core | 1979 TFLOPS |
| FP32 | 134 TFLOPS |
| FP64 Tensor Core | 134 TFLOPS |
| INT8 Tensor Core | 7916 TOPS |
Совместимость с LLM-моделями
| Модель | Тип квантизации | Требуется VRAM | Совместимость | Примечание |
| DeepSeek-R1-Distill-Llama*-70B | Нет | Примерно 141GB | ✅ | Уверенно работает на этой конфигурации и оставляет хороший запас памяти под длинный контекст и несколько запросов. *LLAMA - проект Meta Platforms Inc.**, деятельность которой в России признана экстремистской и запрещена **Деятельность Meta Platforms Inc. в России признана экстремистской и запрещена |
| Qwen3.5-397B-A17B-GGUF | Q4_K_M | Примерно 241GB | ✅ | В 4-битном формате подходит для этой системы, но для стабильной работы лучше держать умеренный контекст и размер батча. |
| gpt-oss:120b | Нет (FP16) | Примерно 260GB | ✅ | Подходит для этой конфигурации, но запас памяти уже небольшой, поэтому лучше не завышать контекст и параллельную нагрузку. |
| GLM-4.7-GGUF | Q4_K_M | Примерно 216GB | ✅ | Хорошо подходит для повседневного запуска, агентных сценариев и обслуживания нескольких пользовательских сессий. |
| Gemma-4-31B-it | Нет | Примерно 62.6GB | ✅ | Уверенно работает на этой системе и оставляет хороший запас памяти под длинный контекст и несколько одновременных запросов. |
| MiniMax-M3 | UD-Q4_K_M | Примерно 264GB | ✅ | Квантизированная версия с заметно меньшим объёмом; удобна для серверов с ограниченным запасом памяти, RAG-сценариев, ассистентов и локальных LLM-сервисов. |
| MiMo-V2.5-GGUF | UD_Q4_K_M | Примерно 191GB | ✅ | Компактная GGUF-версия для более доступного развёртывания; подходит для серверов с ограниченным объёмом памяти, RAG-сценариев, ассистентов и локального инференса. |
Совместимость с диффузионными моделями
| Модель | Тип | Совместимость | Примечание |
| Stable Diffusion XL 1.0 | Текст в изображение | ✅ | Подходит для генерации изображений в высоком разрешении и параллельной работы с несколькими задачами. |
| Flux.2-dev | Текст в изображение | ✅ | Тяжёлая модель, но на этой системе можно держать стабильную генерацию при аккуратных настройках качества и батча. |
| SD Turbo | Быстрые предпросмотры | ✅ | Удобна для быстрых предпросмотров, серийной генерации и интенсивной ежедневной работы. |
| Kandinsky-5.0-T2I-Lite-sft-Diffusers | Текст в изображение | ✅ | Лёгкий вариант для этой платформы - можно без проблем повышать разрешение и запускать несколько процессов одновременно. |
| Kandinsky-6.0-Pro-distill-5s-Diffusers | Текст/изображение в видео со звуком | ✅ | Подходит для коротких роликов и пакетной обработки без жёстких ограничений по памяти. |
| NVIDIA-Cosmos3-Super | Генерации, анализа и симуляции физического мира, которая может работать с текстом, изображениями, видео и действиями | ✅ | Модель объёмом 133 GB для генерации, анализа и симуляции физического мира. Работает с текстом, изображениями, видео и действиями, поэтому подходит для сложных мультимодальных сценариев. Требует высокой производительности и большого объёма видеопамяти, а стабильность запуска зависит от конкретной конфигурации и настроек оптимизации. |
Технические характеристики
| Платформа | GIGABYTE H223-V10-AAW1 |
| Видеокарта / Процессор | 2x NVIDIA GH200 (Grace Hopper) 288GB HBM3e |
| Оперативная память | 960GB ECC LPDDR5X |
| SSD накопитель | 8x 2.5" Gen5 NVMe (4x 2.5" Gen5 NVMe)
4x M.2 NVMe (2280/22110) |
Если нужна конфигурация на эту платформу под ваши задачи - свяжитесь с менеджером, и мы предложим подходящий вариант под бюджет и требования.