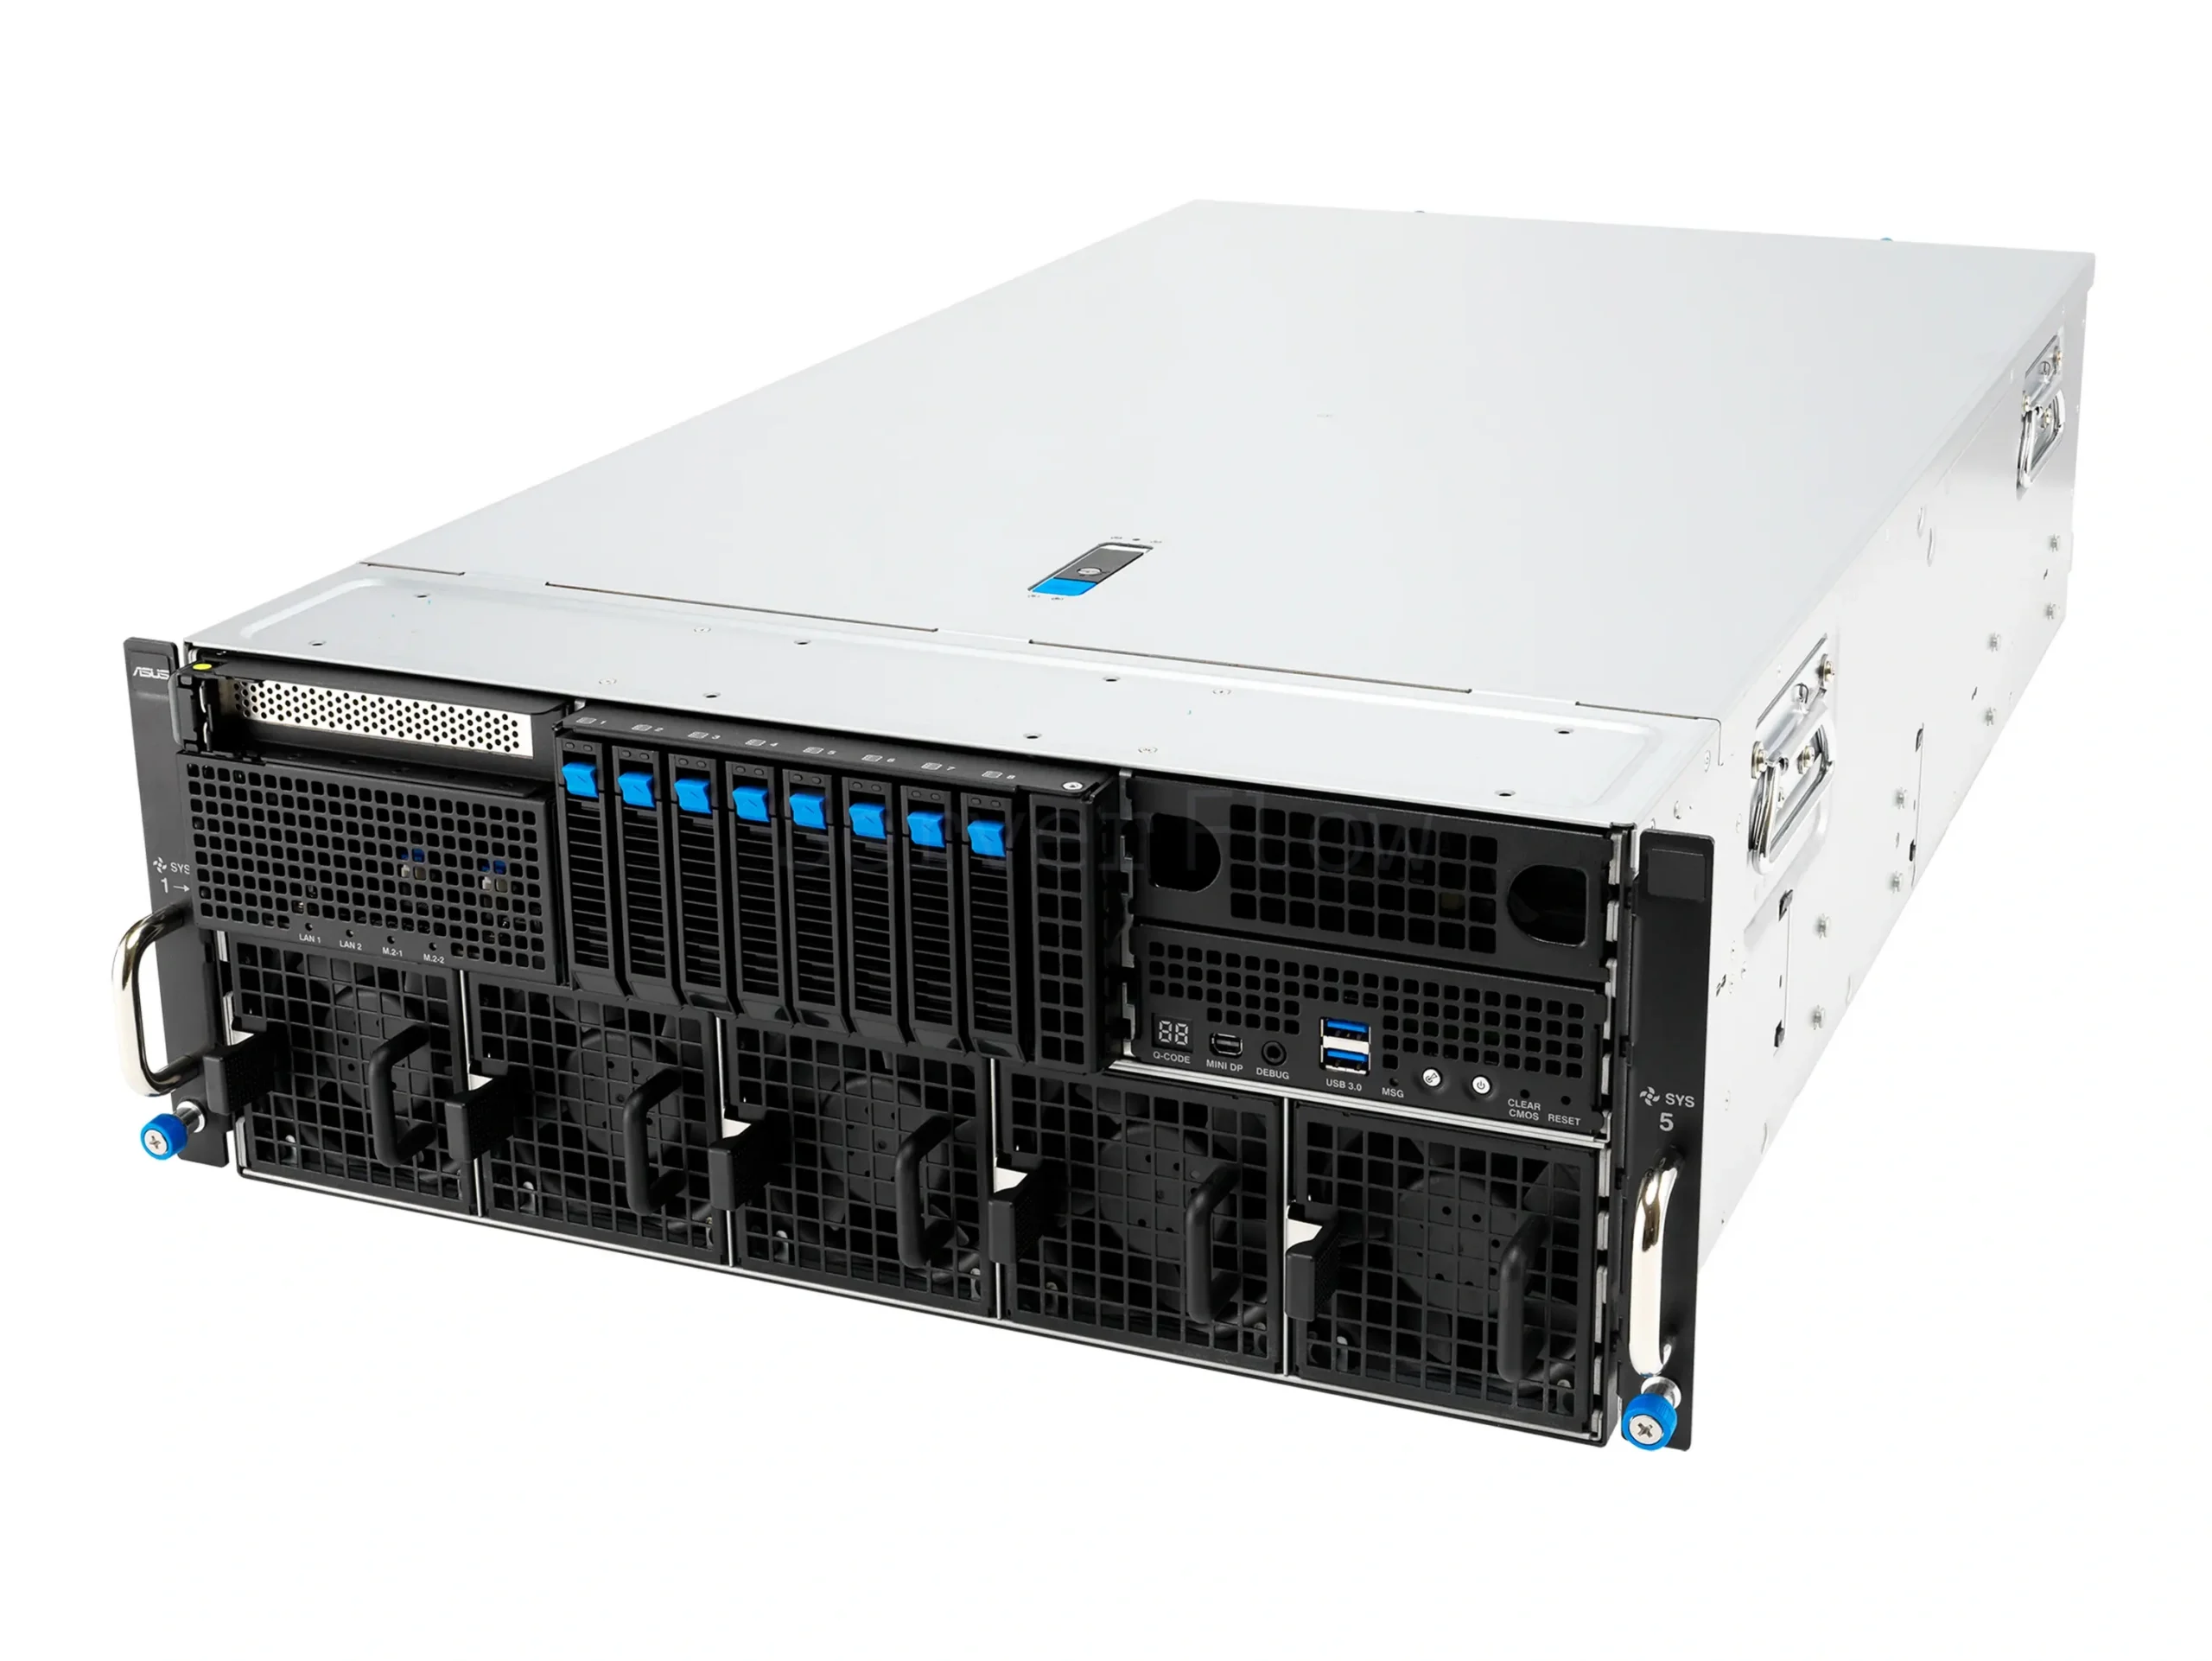
ASUS ESC8000A-E13X (8× RTX PRO 6000 BSE 96GB, 2× EPYC 9965, RAM 1.5TB)
43 028 700 ₽
Цена ориентировочная. Информация в каталоге не является публичной офертой.
- Артикул
- SF-19939
- Наличие
- Уточняется
- Обновлено
- 12.11.2026
Поставки организациям и ИП для бизнеса. Для оформления заказа свяжитесь с менеджером и согласуйте итоговую цену, комплектацию и наличие. Контакты менеджера
Характеристики
- Тип
- Новые
- Основная задача
- Обучение моделей / Инференс / Дообучение моделей / RAG-системы / Визуализация и рендеринг
- Процессор (CPU)
- AMD EPYC
- Видеокарта (GPU)
- NVIDIA RTX PRO 6000 Blackwell
- Количество GPU, шт
- 8
- Общий объем видеопамяти (VRAM), ГБ
- 768
- Тип памяти GPU
- GDDR7
- Объем оперативной памяти (RAM), ГБ
- 1536
- Тип оперативной памяти
- DDR5 ECC REG
- Форм-фактор
- 4U
- Тип точности Совокупная мощность восьми RTX PRO 6000 BSE
- Совокупная мощность восьми RTX PRO 6000 BSE
- FP32
- 960 TFLOPS
- FP4
- 32 PFLOPS
- RT Core performance*
- 2840 TFLOPS
- Платформа
- Asus ESC8000A-E13X
- Видеокарта
- 8x NVIDIA RTX PRO 6000 Blackwell Server Edition 96GB GDDR7
- Процессор
- 2x AMD EPYC 9965 (192c/384t, 2.25GHz-3.7GHz, 500W)
- Оперативная память
- 12x 128GB DDR5 ECC REG Micron 6400Mhz 2Rx4
- SSD накопитель
- 4x Solidigm D7-P5620 12.8TB 2.5" U.2
Описание
Asus ESC8000A-E13X — это 4U GPU-сервер под enterprise AI-инфраструктуру: Обучение моделей (Training), Дообучение моделей (Fine-tuning), Инференс / Развертывание (Inference) и RAG-системы (Retrieval-Augmented Generation). Конфигурация с 8× RTX PRO 6000 Blackwell Server Edition даёт 768 GB суммарной VRAM (8×96 GB), что удобно для больших LLM, параллельных пайплайнов и множества одновременных запросов.
GPU-профиль - NVIDIA Blackwell + 96GB GDDR7 с ECC на карту, Tensor Cores 5-го поколения с акцентом на FP4 (а значит, эффективные INT4/FP4 сценарии для LLM), плюс поддержка MIG (разделение одной GPU на изолированные инстансы - удобно для мультиарендного инференса). За счёт RT-блоков и медиа-движков платформа также подходит для Визуализация и рендеринг и Видеоаналитика / Видеонаблюдение
Ограничение, которое важно учитывать: NVLink нет, поэтому масштабирование по нескольким GPU опирается на PCIe и сетевую связность. В этой модели сервер это компенсирует: ConnectX-8 SuperNIC switch board, 8× 400Gb/s QSFP, и встроенный PCIe Gen6 switch для ускорения GPU-to-GPU коммуникаций
Производительность GPU
| Тип точности | Совокупная мощность восьми RTX PRO 6000 BSE |
| FP32 | 960 TFLOPS |
| FP4 | 32 PFLOPS |
| RT Core performance* | 2840 TFLOPS |
*-RT Core performance - это пиковая производительность специализированных RT-ядер (Ray Tracing Cores), которые аппаратно ускоряют операции трассировки лучей (поиск пересечений луча с геометрией и обход BVH). Показатель важен для визуализации/рендеринга и некоторых графических/3D-пайплайнов, но не является прямым аналогом FP32/AI-производительности.
Совместимость с LLM-моделями
| Модель | Тип квантизации | Требуется VRAM | Совместимость | Примечание |
| DeepSeek-R1 685B | Нет | Примерно 689GB | ✅ | Запуск на одном узле 8×96GB через multi-GPU (tensor/pipeline) в vLLM/TensorRT-LLM; для reasoning и длинного контекста. |
| Qwen3.5-397B-A17B-FP8 / Qwen3.6-35B-A3B | FP8 / Нет | Примерно 406GB / 71.9 GB | ✅ | Масштабируется на 8 GPU в одном сервере; удобно для чатов, агентов и RAG при высокой нагрузке. |
| Gpt-oss:120b | Нет | Примерно 196GB | ✅ | Работает без квантизации; можно держать несколько реплик/сервисов благодаря 768GB суммарной VRAM. |
| GigaChat3.5-432B-A28B | Нет | Примерно 438GB | ✅ | Помещается на 8×96GB и запускается в multi-GPU; для больших ассистентов и длинных диалогов. |
| Mistral-Large-3-675B-Instruct-251 | Нет | Примерно 682GB | ✅ | Запуск на одном узле в multi-GPU; для аналитики, reasoning, RAG и агентных пайплайнов. |
| GLM-5.3 | Нет | Примерно 756GB | ✅ | FP8 снижает VRAM и ускоряет инференс; подходит для LLM-сервисов и RAG. |
| NVIDIA-Nemotron-3-Super-120B-A12B-NVFP4 | NVFP4 (FP4 для NVIDIA) | Примерно 80.4GB | ✅ | Удобна для параллельного запуска нескольких инстансов, работы с длинным контекстом и высокой плотности запросов. |
| Kimi-K2.7-Code | Нет | Примерно 595GB | ✅ | Полноразмерная версия для мощных GPU-серверов; подходит для reasoning-задач, RAG, агентных рабочих процессов и производственного инференса с высоким запасом качества. |
| MiniMax-M3 | UD-Q4_K_M | Примерно 264GB | ✅ | Квантизированная версия с заметно меньшим объёмом; удобна для серверов с ограниченным запасом памяти, RAG-сценариев, ассистентов и локальных LLM-сервисов. |
| MiMo-V2.5-Pro-GGUF | UD_Q4_K_M | Примерно 630GB | ✅ | Квантизированная Pro-версия для более гибкого размещения на серверных конфигурациях с разным объёмом памяти; подходит для RAG, reasoning-задач и производственных LLM-сервисов. |
Совместимость с диффузионными моделями
| Модель | Тип | Совместимость | Примечание |
| Stable Diffusion XL 1.0 | Текст в изображение | ✅ | Стабильная high-res генерация; легко параллелить пайплайны и батчи на нескольких GPU (CUDA). |
| Flux.2-dev | Текст в изображение | ✅ | Требовательна к VRAM: удобно распределять очередь по GPU; уверенная high-res генерация на CUDA. |
| SD Turbo | Быстрые предпросмотры | ✅ | Очень быстрые итерации; несколько параллельных задач для предпросмотров и массовой генерации. |
| Kandinsky-5.0-T2I-Lite-sft-Diffusers | Текст в изображение | ✅ | Лёгкая модель: большой запас VRAM под high-res, батчи и нескольких пользователей. |
| Kandinsky-6.0-Pro-distill-5s-Diffusers | Текст/изображение в видео со звуком | ✅ | Короткие ролики: масштабируется по GPU, ускоряя пакетную генерацию видео и кадров. |
Технические характеристики
| Платформа | Asus ESC8000A-E13X |
| Видеокарта | 8x NVIDIA RTX PRO 6000 Blackwell Server Edition 96GB GDDR7 |
| Процессор | 2x AMD EPYC 9965 (192c/384t, 2.25GHz-3.7GHz, 500W) |
| Оперативная память | 12x 128GB DDR5 ECC REG Micron 6400Mhz 2Rx4 |
| SSD накопитель | 4x Solidigm D7-P5620 12.8TB 2.5" U.2 |