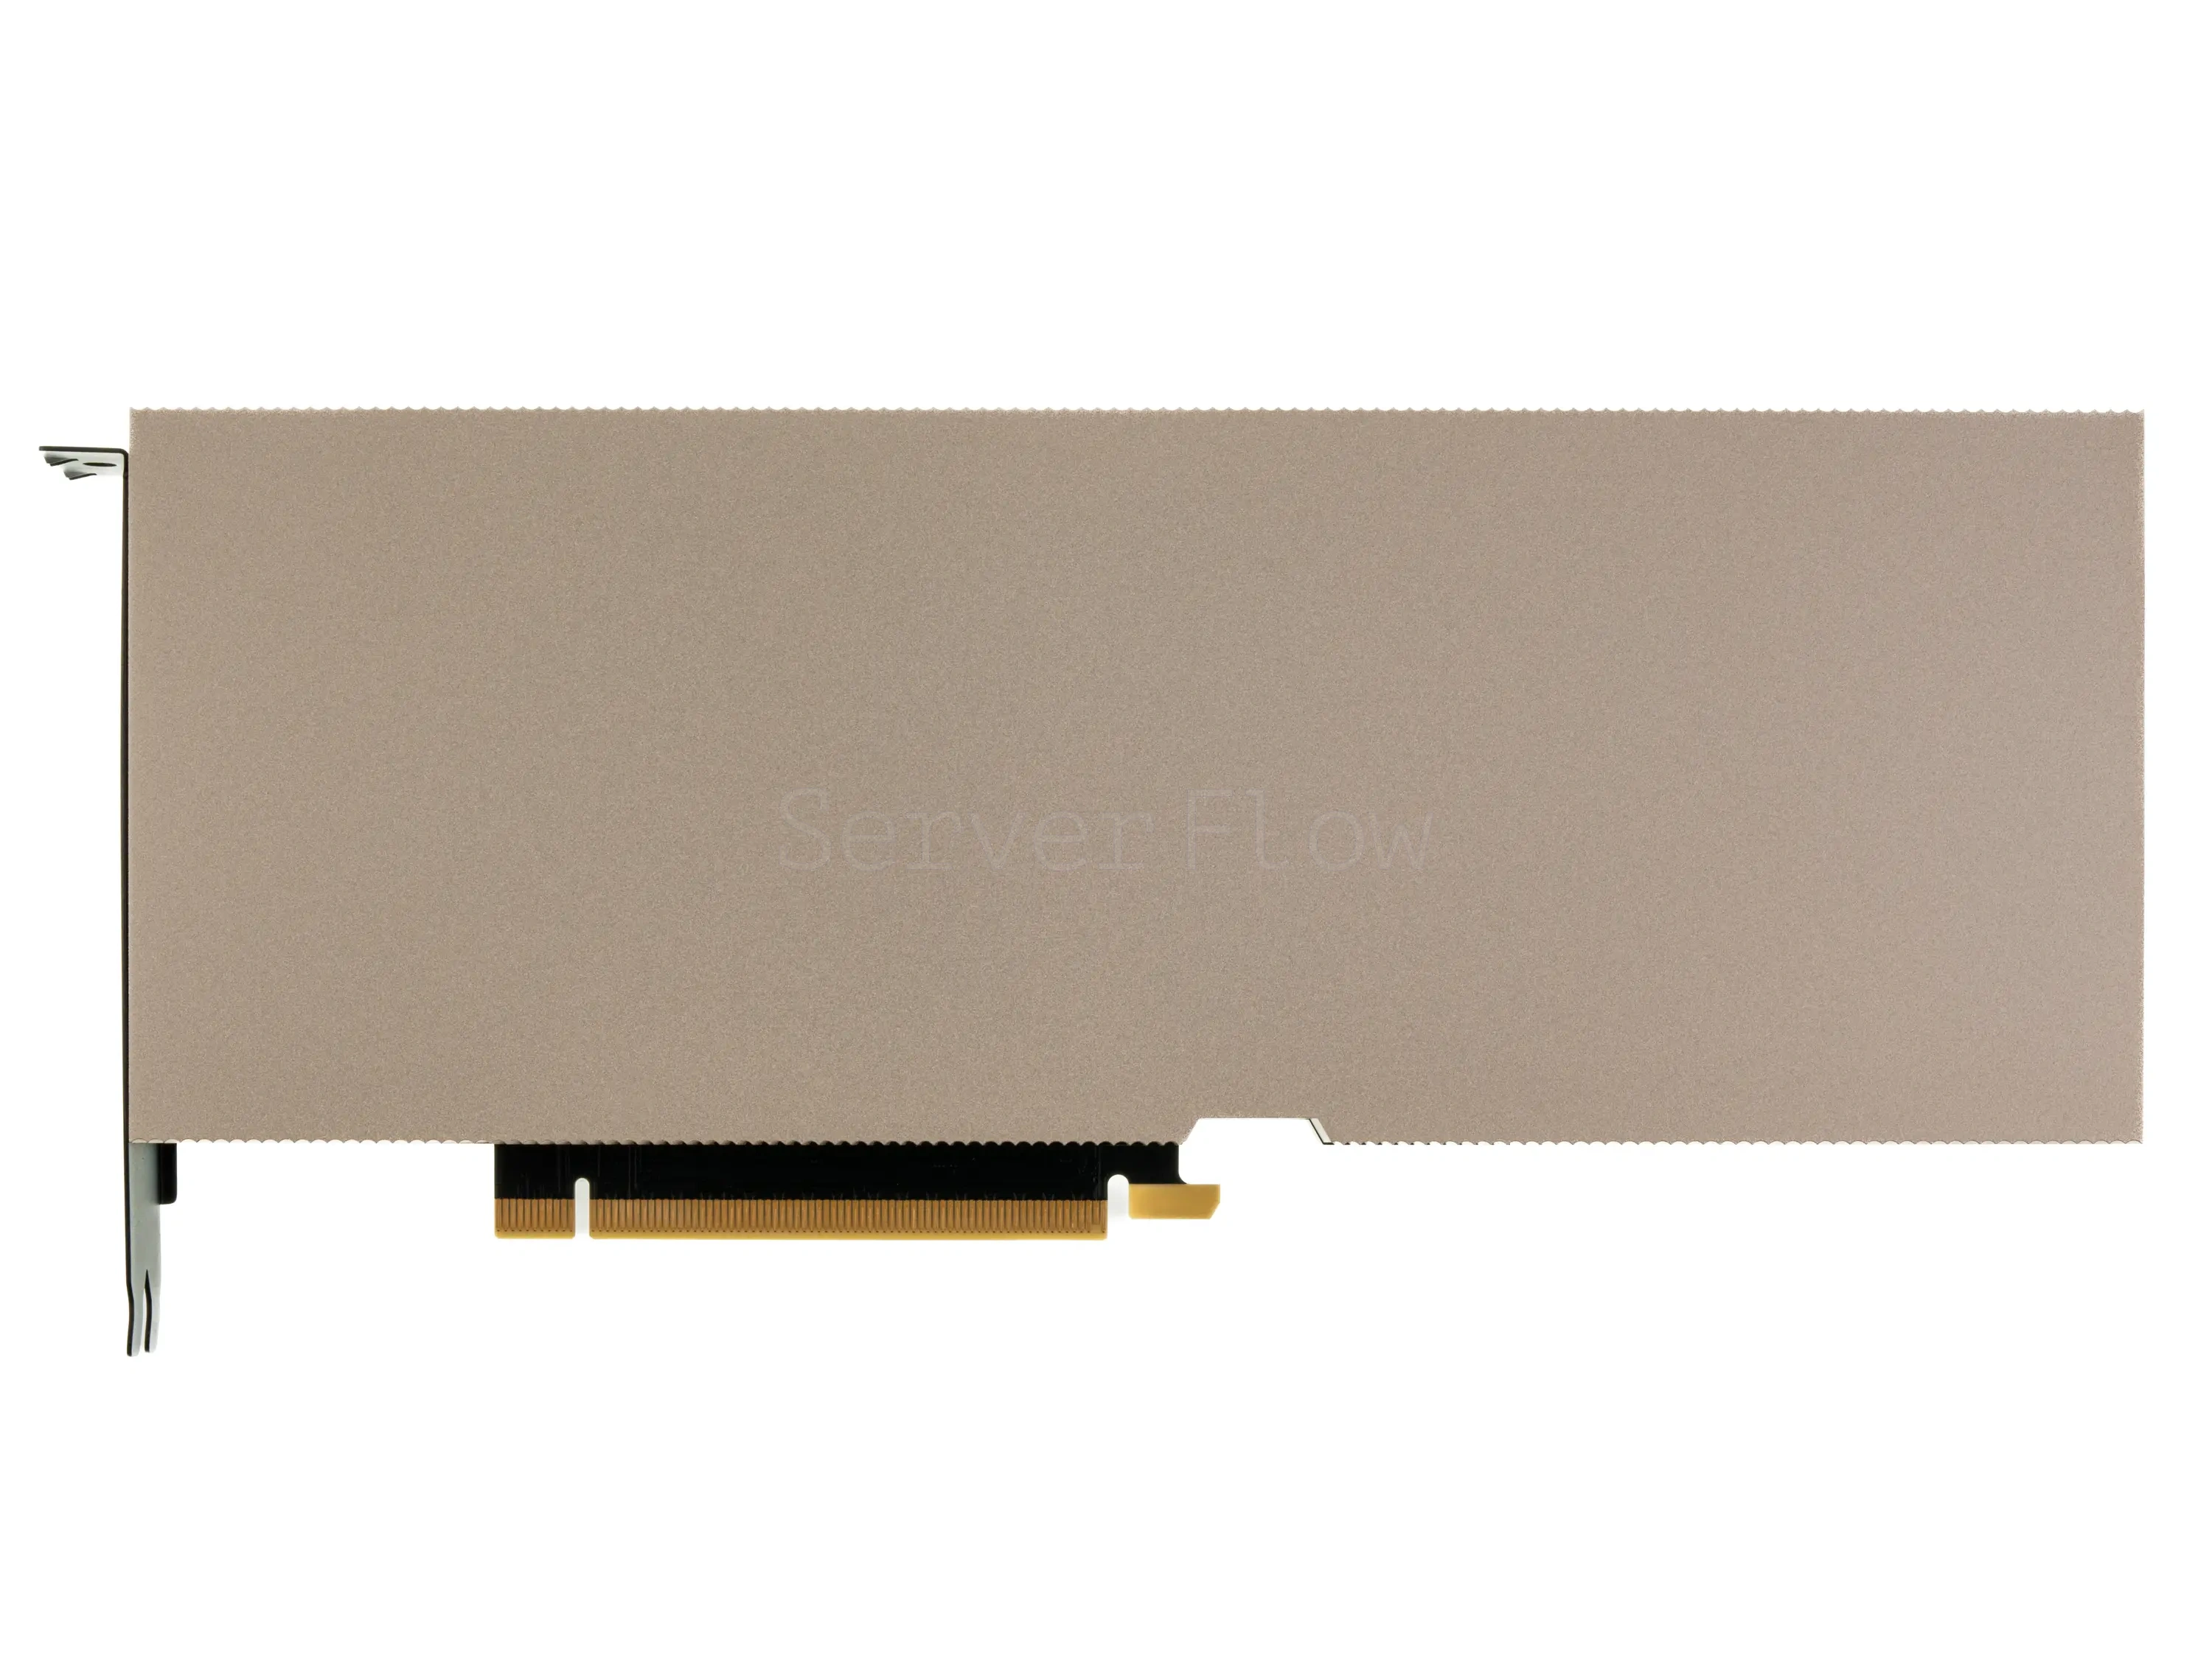
Видеокарта NVIDIA A100 OEM 80GB HBM2e [900-21001-0000-000]
25 900 ₽
Цена ориентировочная. Информация в каталоге не является публичной офертой.
- Артикул
- SF-00003024
- Партномер
- 900-21001-0000-000 / 900-21001-0020-100 / 900-21001-0120-030
- Наличие
- Уточняется
- Обновлено
- 12.11.2026
Поставки организациям и ИП для бизнеса. Для оформления заказа свяжитесь с менеджером и согласуйте итоговую цену, комплектацию и наличие. Контакты менеджера
Характеристики
- Тип
- Новые
- Парт.№
- 900-21001-0000-000 / 900-21001-0020-100 / 900-21001-0120-030
- Тип видеокарты
- Для вычислений
- Количество видеовыходов
- 0
- Видеовыходы
- Нет
- Объем видеопамяти
- 80GB
- Тип видеопамяти
- HBM2e
- Разрядность шины памяти
- 5120 bit
- Наличие памяти с коррекцией ошибок(ECC)
- Да
- Частота графического процессора Base Frequency, MHz
- 1065
- Максимальная частота графического процессора Turbo Frequency, MHz
- 1410
- Количество вычислительных ядер
- 6912
- Интерфейс подключения
- PCIe 4.0 x16
- Количество занимаемых слотов
- 2
- Совместимость с низкопрофильными решениями
- Нет
- TDP ускорителя, W
- 300
- Тип охлаждения
- Пассивное
- Наличие NVLink
- Поддерживается
- Поддержка ПО vGPU
- Нет
- Архитектура графического процессора
- Ampere
- Наличие кодировщиков NVENC | NVDEC
- NVDEC: 4th Gen
- Разъемы питания
- 1x 8-pin EPS
- Длина видеокарты, mm
- 267
- Тип операций
- Производительность
- FP16
- 78 TFLOPS
- FP16 Tensor Core
- 312 TFLOPS
- BF16 Tensor Core
- 312 TFLOPS
- FP32
- 19.5 TFLOPS
- TF32 Tensor Core
- 156 TFLOPS
- FP64
- 9.7 TFLOPS
- FP64 Tensor Core
- 19.5 TFLOPS
- INT8 Tensor Core
- 624 TOPS
- INT4 Tensor Core
- 1248 TOPS
Описание
Видеокарта NVIDIA A100 OEM 80 GB HBM2e представляет собой серверный ИИ‑ускоритель профессионального класса на базе архитектуры Ampere с третьим поколением Tensor Core, оптимизированный для обучения и инференса крупных нейросетевых моделей, включая LLM‑решения вроде deepseek‑r1:70b и Mistral‑Large‑Instruct‑2411‑GGUF. Благодаря HBM2e‑памяти объёмом 80 ГБ и пропускной способности до 2 039 ГБ/с обеспечивается эффективная загрузка и обслуживание моделей объёмом порядка 73 ГБ
Карта допускает объединение нескольких экземпляров с помощью NVLink 3.0 пропускная способность до 600 ГБ/с и масштабирование до 16 карт и поддерживает технологию Multi‑Instance GPU (MIG) с делением до семи полностью изолированных инстансов, что совместимо с виртуализацией vGPU и NVIDIA AI Enterprise. Отсутствие видеовыходов подчёркивает её роль ИИ‑сопроцессора, не предназначенного для визуального вывода.
А100 базируется на GA100, имеет мощные Tensor Core третьего поколения, поддержку NVENC/NVDEC (5 декодеров) и охлаждение пассивного типа, что требует размещения в сервере с хорошо организованным направленным воздушным потоком. Питание осуществляется через один 8‑pin EPS-коннектор, соответствующий TDP до 300 Вт.
| Тип операций | Производительность |
| FP16 | 78 TFLOPS |
| FP16 Tensor Core | 312 TFLOPS |
| BF16 Tensor Core | 312 TFLOPS |
| FP32 | 19.5 TFLOPS |
| TF32 Tensor Core | 156 TFLOPS |
| FP64 | 9.7 TFLOPS |
| FP64 Tensor Core | 19.5 TFLOPS |
| INT8 Tensor Core | 624 TOPS |
| INT4 Tensor Core | 1248 TOPS |
Эти показатели обеспечивают отличную эффективность при обучении LLM и generative AI, а также при инференсе благодаря режимам INT8 и FP8. Пассивное охлаждение и возможность масштабирования через NVLink и MIG делают эту карту надёжным выбором для дата‑центров и масштабных ИИ‑узлов.