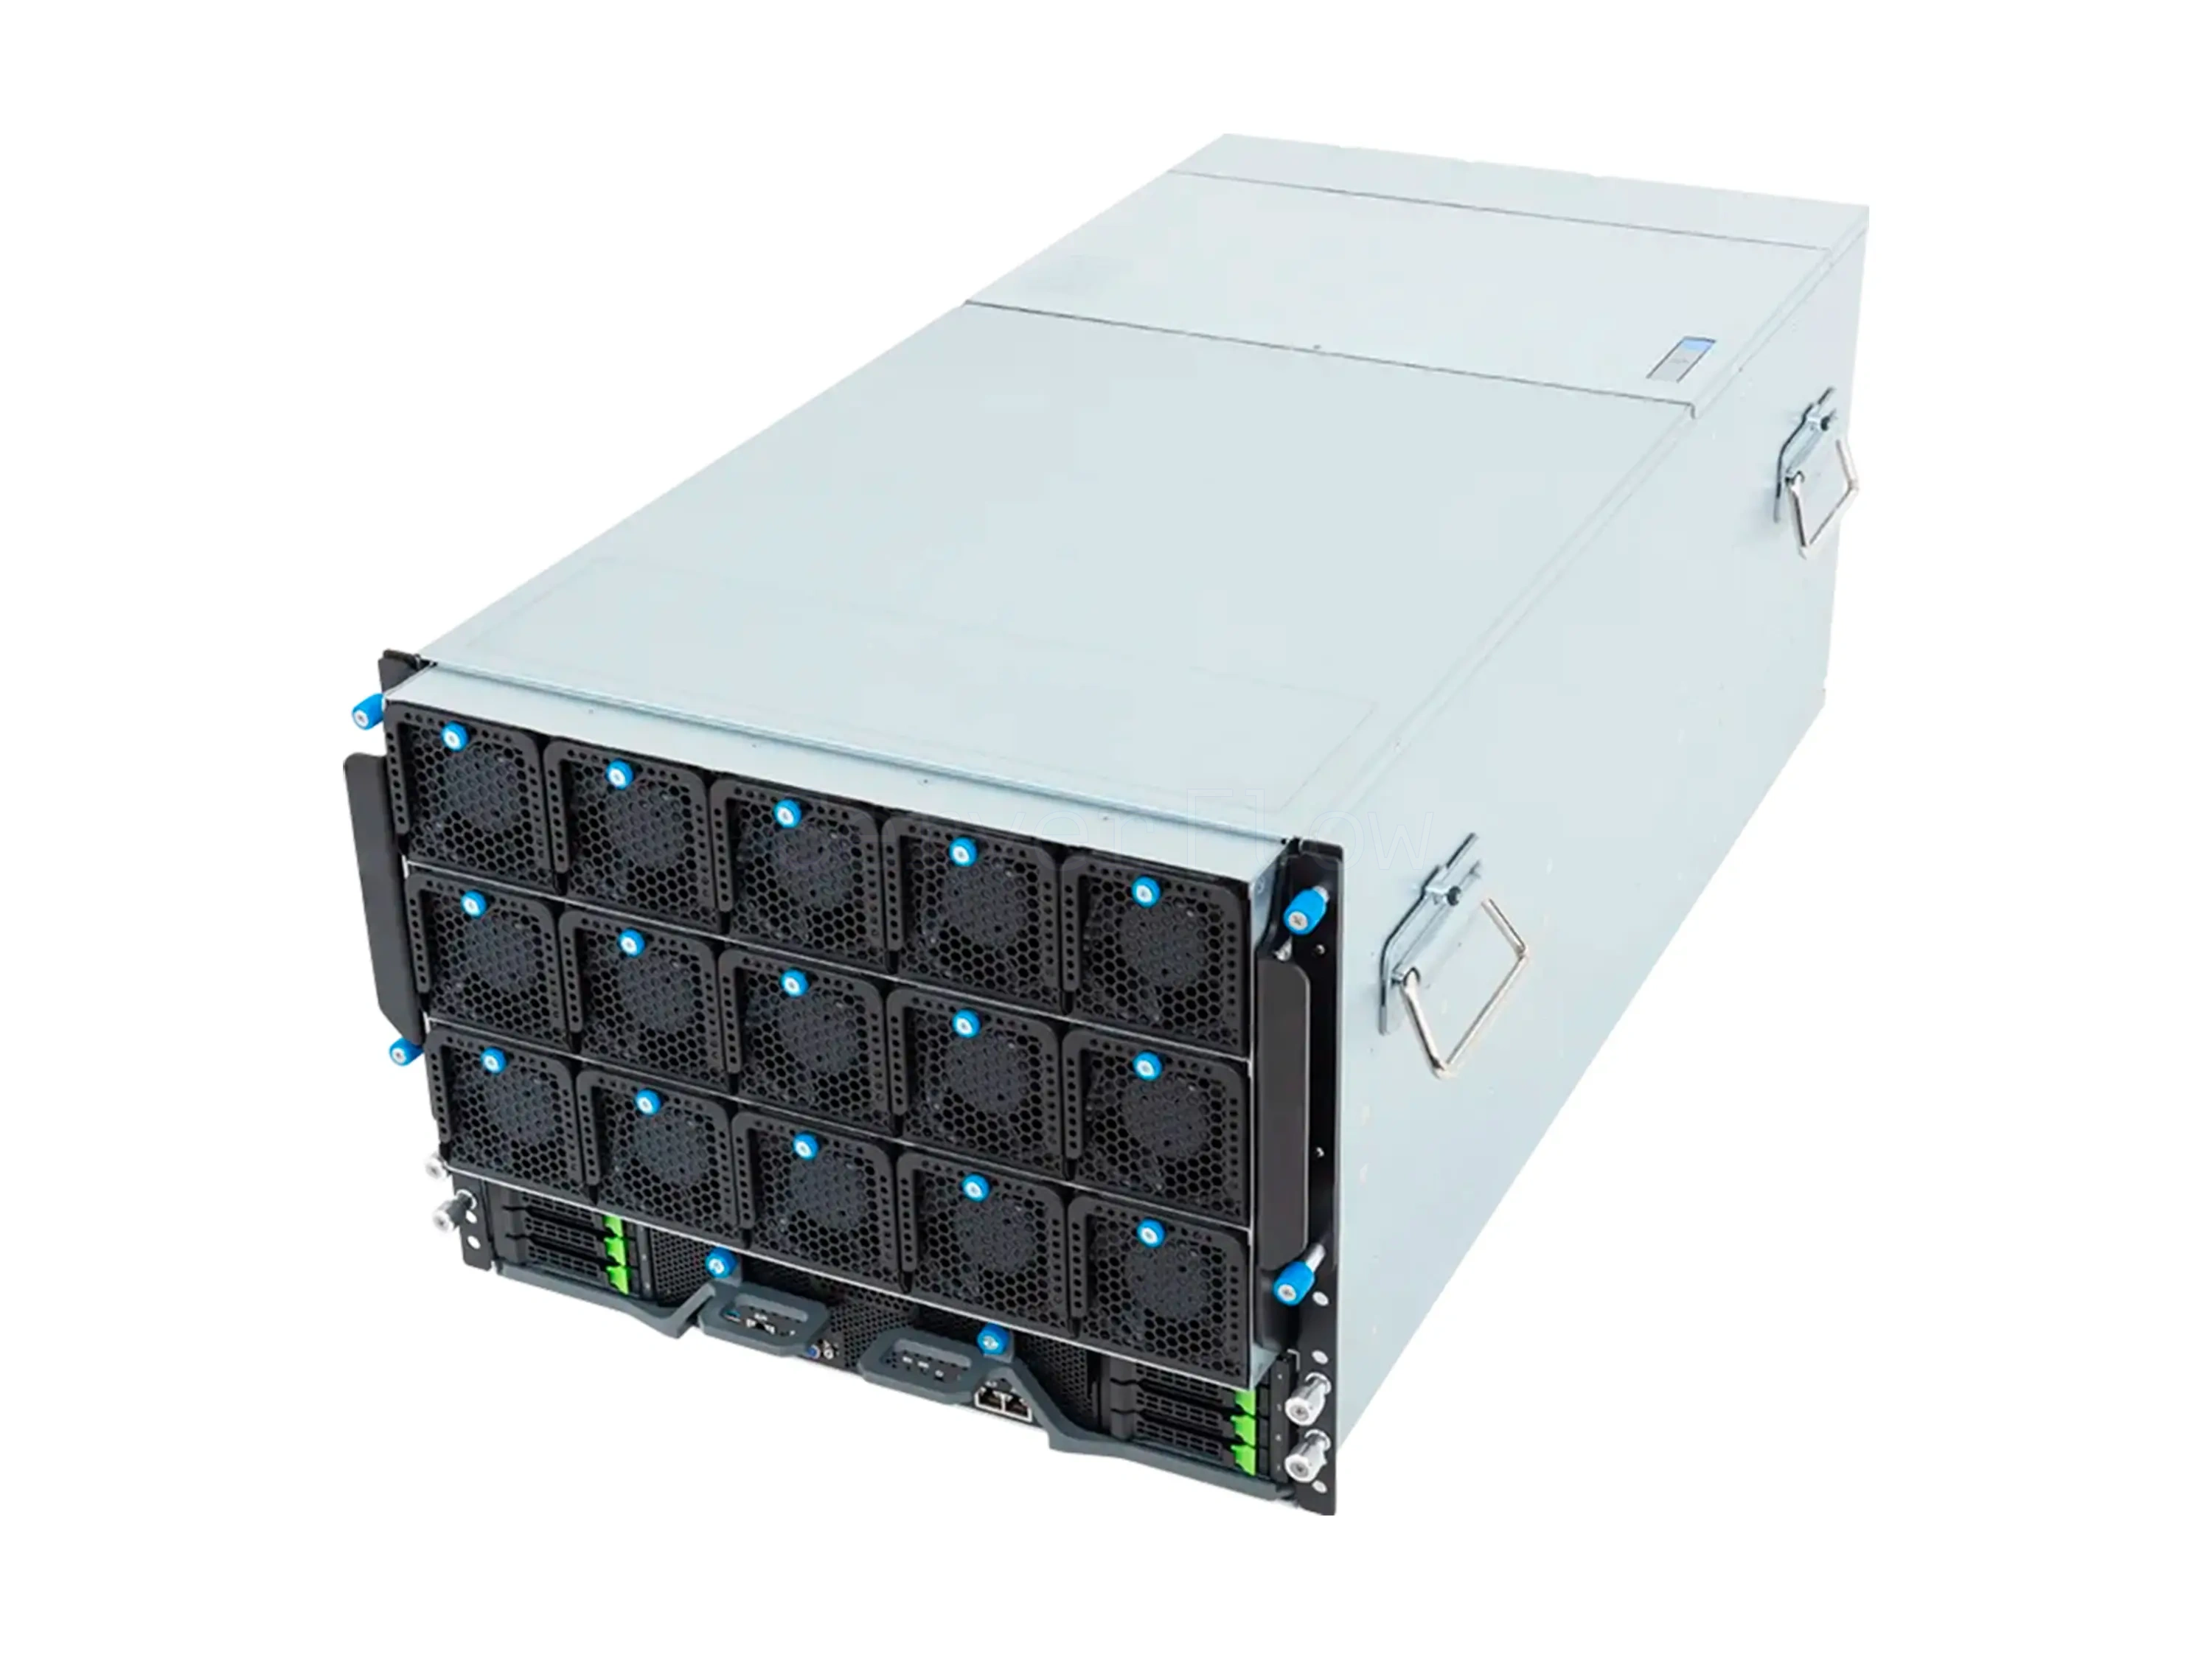
GIGABYTE G893-ZX1-AAX1 (8× Instinct MI300X 192GB)
25 559 600 ₽
Цена ориентировочная. Информация в каталоге не является публичной офертой.
- Артикул
- SF-21464
- Наличие
- Уточняется
- Обновлено
- 12.11.2026
Поставки организациям и ИП для бизнеса. Для оформления заказа свяжитесь с менеджером и согласуйте итоговую цену, комплектацию и наличие. Контакты менеджера
Характеристики
- Тип
- Новые
- Основная задача
- Обучение моделей / Инференс / Дообучение моделей / RAG-системы / Анализ данных / Научные расчеты (HPC)
- Процессор (CPU)
- AMD EPYC
- Видеокарта (GPU)
- AMD Instinct MI300X
- Количество GPU, шт
- 8
- Общий объем видеопамяти (VRAM), ГБ
- 1536
- Тип памяти GPU
- HBM3
- Объем оперативной памяти (RAM), ГБ
- 6144
- Тип оперативной памяти
- DDR5 ECC REG
- Форм-фактор
- 8U
- Тип точности Совокупная мощность восьми Instinct MI300X OAM
- Совокупная мощность восьми Instinct MI300X OAM
- FP8*
- 41.76 PFLOPS
- FP16*
- 20.88 PFLOPS
- TF32*
- 10.4 PFLOPS
- FP32 Matrix
- 1304 TFLOPS
- FP32
- 1304 TFLOPS
- FP64 Matrix
- 1304 TFLOPS
- FP64
- 653.6 TFLOPS
- INT8*
- 41.76 POPS
- BF16*
- 20.88 PFLOPS
- Видеокарта
- 8x AMD Instinct MI300X OAM 192GB HBM3
- Процессор
- 2× AMD EPYC 9005/9004 (SP5 (LGA 6096))
- Оперативная память
- до 6TB DDR5 ECC RDIMM, 24 слота
- SSD накопители
- 8× 2.5" NVMe, 1× M.2 (2280/22110), PCIe Gen3 x4, 1× M.2 (2280/22110), PCIe Gen3 x1
Описание
Сервер под тяжёлые AI-нагрузки и большие модели, где важны Обучение моделей (Training), Дообучение моделей (Fine-tuning), Инференс / Развертывание (Inference), RAG-системы (Retrieval-Augmented Generation) и HPC (Высокопроизводительные вычисления). Конфигурация на 8 ускорителях позволяет держать крупные LLM без жёстких компромиссов по контексту и KV-cache, а также повышать QPS за счёт параллельного обслуживания запросов.
Ключевая фишка платформы - 8 × AMD Instinct MI300X по 192 GB HBM3, суммарно 1536 GB HBM3 (1.5 TB). Такой объём памяти удобно использовать для очень больших моделей, длинных контекстов и одновременной работы нескольких пайплайнов, включая раздельные очереди под разные сервисы.
Стек ориентирован на ROCm, и в продакшн сценариях часто используются оптимизированные окружения под vLLM и PyTorch ROCm. Для MI300X отдельно отмечают поддержку FP8-квантования в vLLM как способ снизить потребление памяти и поднять throughput, если нужна максимальная плотность моделей на узле.
Производительность GPU
| Тип точности | Совокупная мощность восьми Instinct MI300X OAM |
| FP8 | 20.88 PFLOPS |
| FP8* | 41.76 PFLOPS |
| FP16 | 10.4 PFLOPS |
| FP16* | 20.88 PFLOPS |
| TF32 | 5229.6 TFLOPS |
| TF32* | 10.4 PFLOPS |
| FP32 Matrix | 1304 TFLOPS |
| FP32 | 1304 TFLOPS |
| FP64 Matrix | 1304 TFLOPS |
| FP64 | 653.6 TFLOPS |
| INT8 | 20.8 POPS |
| INT8* | 41.76 POPS |
| BF16 | 10.4 PFLOPS |
| BF16* | 20.88 PFLOPS |
* C структурированной разреженностью
Совместимость с LLM-моделями
| Модель | Тип квантизации | Требуется VRAM | Совместимость | Примечание |
| DeepSeek-R1 685B | Нет | Примерно 689GB | ✅ | Уверенно запускается без квантизации в распределённом режиме на 8 × AMD Instinct MI300X и даёт большой запас под длинный контекст, KV-cache и батчи. 1.5 TB HBM3 удобно использовать для высоких нагрузок inference и стабильного обслуживания нескольких очередей. | Qwen3.5-397B-A17B | Нет | Примерно 807GB | ✅ | Хорошо масштабируется по 5-8 GPU и подходит для продакшн serving и агентных сценариев. На 8 × MI300X можно держать повышенный concurrency и длинный контекст, а также разделять ресурсы между RAG и генерацией. |
| Gpt-oss:120b | Нет | Примерно 196GB | ✅ | Комфортный вариант для 2 GPU в полной точности, при этом остальная VRAM остаётся под высокий QPS и крупный KV-cache. При необходимости можно уплотнять размещение через FP8 режимы, чтобы запускать больше сервисов на одном узле. |
| GigaChat3-702B-A36B-preview | Нет | Примерно 720GB | ✅ | Эффективно использует 8 × AMD Instinct MI300X и 1.5 TB HBM3 для длинных контекстов и высокой пропускной способности. Удобна для крупных чат сервисов, суммаризации и RAG с параллельными запросами. |
| Mistral-Large-3-675B-Instruct-251 | Нет | Примерно 682GB | ✅ | Удобна для больших аналитических задач на 8 × MI300X, особенно при длинном контексте и высоких батчах. Большой запас VRAM позволяет держать расширенный KV-cache и несколько рабочих профилей serving. | GLM-5-FP8 | FP8 | Примерно 756GB | ✅ | FP8 режим хорошо ложится на MI300X и помогает снизить требования к памяти при сохранении качества. На 8 GPU удобно поднимать QPS, держать длинные контексты и распределять нагрузку между несколькими продакшн LLM сервисами. |
Совместимость с диффузионными моделями
| Модель | Тип | Совместимость | Примечание |
| Stable Diffusion XL 1.0 | Текст в изображение | ✅ | Легко держит high-res и большие батчи, генерацию удобно распараллеливать по нескольким GPU. На 8 × MI300X можно одновременно крутить несколько очередей и профилей качества без упора в память. |
| Flux.2-dev | Текст в изображение | ✅ | Большая VRAM позволяет уверенно работать с high-res и повышать throughput через параллельные пайплайны. На MI300X удобно разделять задачи по GPU для стабильной пакетной генерации. |
| SD Turbo | Быстрые предпросмотры | ✅ | Идеален для быстрых итераций и высокой параллельности предпросмотров. Можно выделить отдельные GPU под превью, а остальные оставить под финальный high-res рендер. |
| Kandinsky-5.0-T2I-Lite-sft-Diffusers | Текст в изображение | ✅ | Лёгкая модель, можно запускать много пайплайнов параллельно и повышать разрешение без упора в память. 192 GB HBM3 на GPU дают удобный запас под буферы и дополнительную постобработку. |
| Kandinsky-5.0-T2V-Lite-sft-5s-Diffusers | Текст в видео | ✅ | Удобно распределять задачи по GPU для пакетной генерации коротких роликов и очередей. На 8 × MI300X можно параллелить стадии пайплайна и держать несколько проектов одновременно. |
Технические характеристики
| Видеокарта | 8x AMD Instinct MI300X OAM 192GB HBM3 |
| Процессор | 2× AMD EPYC 9005/9004 (SP5 (LGA 6096)) |
| Оперативная память | до 6TB DDR5 ECC RDIMM, 24 слота |
| SSD накопители | 8× 2.5" NVMe, 1× M.2 (2280/22110), PCIe Gen3 x4, 1× M.2 (2280/22110), PCIe Gen3 x1 |
Если нужна конфигурация на эту платформу под ваши задачи - свяжитесь с менеджером, и мы предложим подходящий вариант под бюджет и требования.