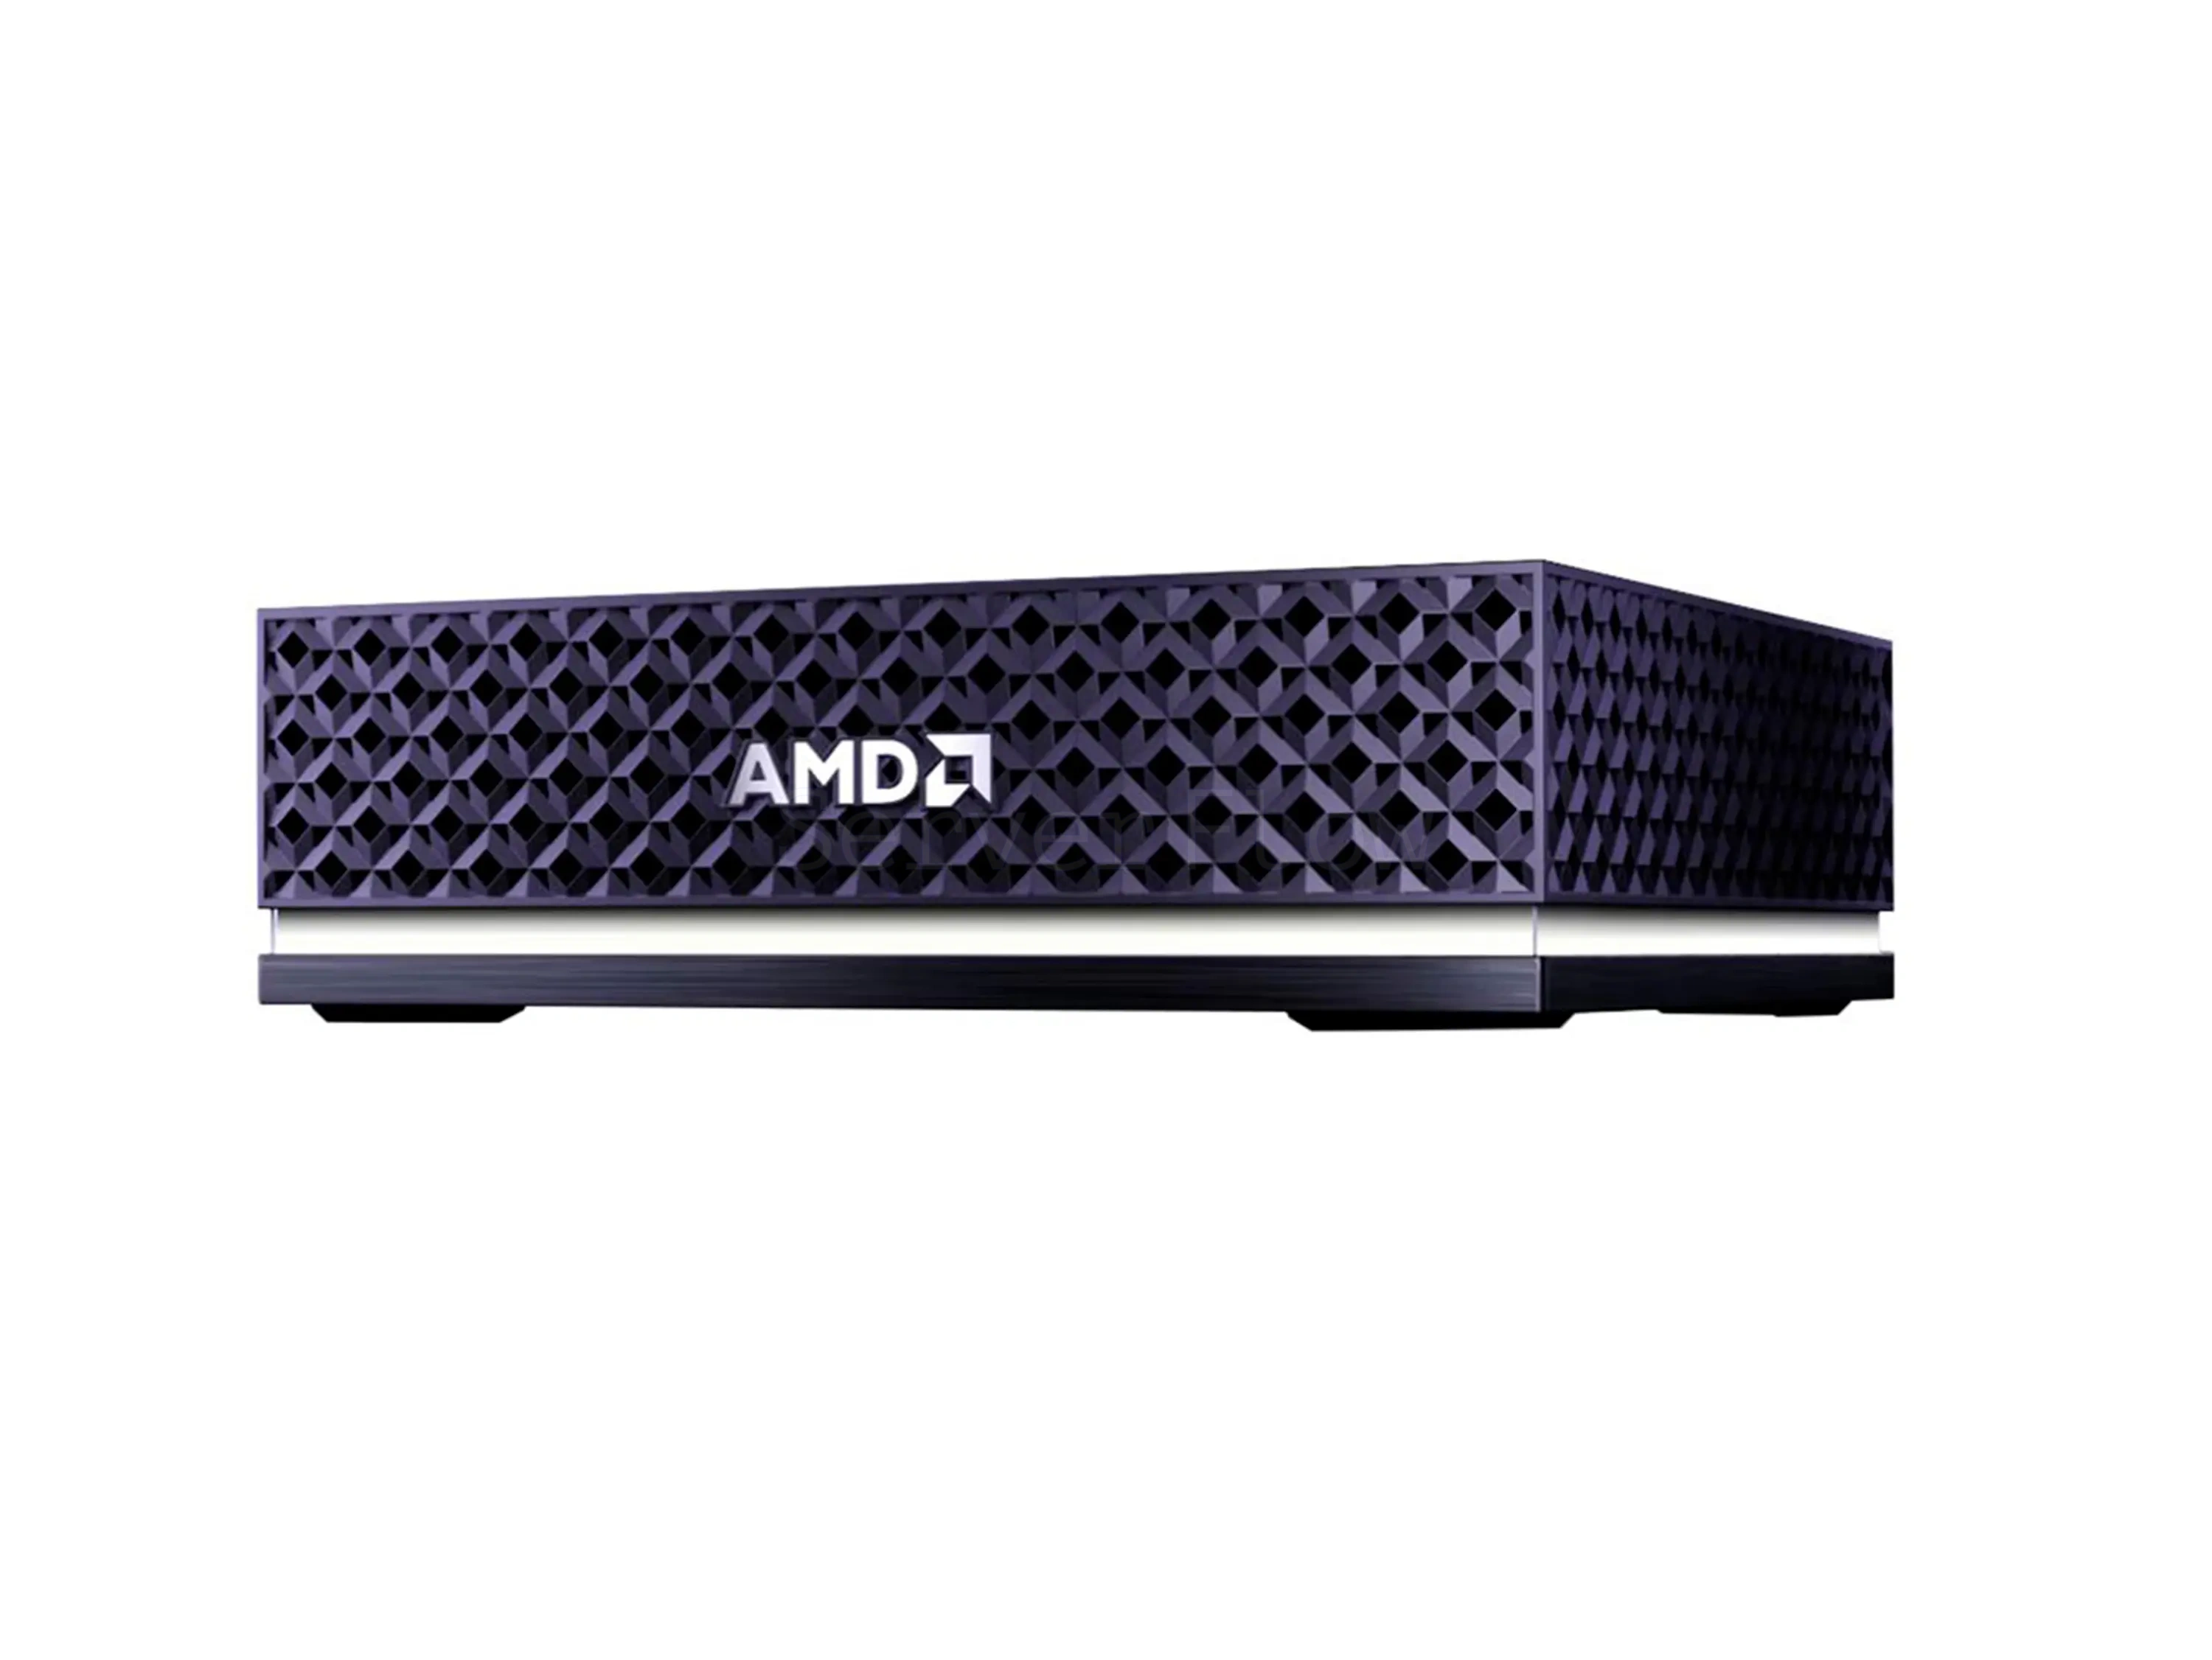
AMD Ryzen AI Halo (Radeon 8060S, Ryzen AI Max+ 395, RAM 128GB, OS Linux)
905 300 ₽
Цена ориентировочная. Информация в каталоге не является публичной офертой.
- Артикул
- SF-25464
- Наличие
- Уточняется
- Обновлено
- 12.11.2026
Поставки организациям и ИП для бизнеса. Для оформления заказа свяжитесь с менеджером и согласуйте итоговую цену, комплектацию и наличие. Контакты менеджера
Характеристики
- Тип
- Новые
- Основная задача
- Инференс / Дообучение моделей / RAG-системы / Анализ данных / Визуализация и рендеринг
- Процессор (CPU)
- AMD Ryzen AI Max+ 395
- Видеокарта (GPU)
- AMD Radeon 8060S (Встроенная)
- Количество GPU, шт
- 1
- Общий объем видеопамяти (VRAM), ГБ
- 128
- Тип памяти GPU
- LPDDR5x
- Объем оперативной памяти (RAM), ГБ
- 128
- Тип оперативной памяти
- LPDDR5x
- Форм-фактор
- SFF
- Категория
- Мощность
- FP16
- 60 TFLOPS
- NPU
- 50 TOPS
Описание
AMD Ryzen AI Halo - это компактный AI-микросуперкомпьютер на базе Ryzen AI Max+ 395, встроенной графики Radeon 8060S, 128 GB LPDDR5x-памяти и операционной системы Linux OS. Система подходит для Инференса / Развертывания (Inference), RAG-систем (Retrieval-Augmented Generation), Анализа данных (Data Science), Визуализации и рендеринга, а также для локальной разработки AI-приложений.
Ключевая особенность платформы - связка CPU + GPU + NPU в одном энергоэффективном кристалле. 16-ядерный CPU Zen 5 отвечает за общие вычисления, обработку данных, логику приложений и многозадачность. Radeon 8060S с 40 графическими ядрами RDNA 3.5 берёт на себя графику, параллельные вычисления, локальный инференс и генеративные задачи. Отдельный NPU AMD Ryzen AI ускоряет нейросетевые операции с низким энергопотреблением и помогает разгружать CPU и GPU в совместимых AI-сценариях.
В конфигурации с 128 GB RAM система использует общую память, доступную CPU и встроенной Radeon 8060S. Это не выделенная HBM/GDDR VRAM, как в серверных ускорителях, но большой объём общей памяти делает платформу удобной для локального запуска LLM, тестирования RAG-пайплайнов, работы с эмбеддингами, небольшого дообучения LoRA/QLoRA и прототипирования AI-сервисов без отдельной дискретной видеокарты.
Для подключения периферии предусмотрен современный набор интерфейсов: 1x HDMI 2.1, 4× USB Type-C (1 порт для питания, 1 порт USB-C с DisplayPort для вывода изображений и 2 обычных USB Type-C), 1x RJ-45 10GbE, Wi-Fi 7 и Bluetooth 5.4
В Linux OS платформа особенно интересна как локальный AI-сервер для LLM, компактная рабочая станция для Ollama, llama.cpp, PyTorch, ONNX Runtime, ROCm-совместимых сценариев, контейнеров и RAG-разработки.
Производительность
| Категория | Мощность |
| FP16 | 60 TFLOPS |
| NPU | 50 TOPS |
Совместимость с LLM-моделями
| Модель | Тип квантизации | Требуется VRAM | Совместимость | Примечание |
| Qwen3.6-35B-A3B | Нет | Примерно 71.9GB | ✅ | Для AMD Ryzen AI Halo с 128GB unified memory модель подходит для локального инференса при достаточном выделении памяти под Radeon 8060S. Связка CPU + GPU + NPU помогает распределять системные, графические и AI-задачи, но для стабильности лучше использовать умеренный контекст и оптимизированный рантайм. |
| DeepSeek-R1-Distill-Qwen-32B | Нет | Примерно 65.5 | ✅ | Хороший вариант для локального чат-бота, RAG и reasoning-задач на компактном AI-суперкомпьютере. Radeon 8060S берёт на себя графическое и параллельное ускорение, CPU Zen 5 обслуживает логику приложения, а NPU полезен для энергоэффективных AI-сценариев в совместимых задачах. |
| gpt-oss-120b-GGUF | Q4_K_M | Примерно 62.8GB | ✅ | В формате Q4 модель помещается в 128GB unified memory и подходит для локального запуска без дискретной видеокарты. Скорость будет зависеть от backend, настроек offload и выделения памяти под iGPU, поэтому для комфортной работы лучше ограничивать контекст и использовать потоковый вывод. |
| GLM-4.7-Flash | Нет | Примерно 62.5GB | ✅ | Модель проходит по памяти и хорошо подходит для локального инференса, RAG и тестирования AI-приложений. Для лучшей отзывчивости на Ryzen AI Max+ 395 стоит выбирать оптимизированные сборки, не завышать batch и учитывать, что unified memory делится между CPU, Radeon 8060S и системными задачами. |
| Gemma-4-31B-it | Нет | Примерно 62.6GB | ✅ | Подходит для локального запуска на AMD Ryzen AI Halo и оставляет запас под контекст, служебные данные и рабочие приложения. Такая модель хорошо раскрывает формат AI-микросуперкомпьютера, где CPU, Radeon 8060S и NPU работают как единая платформа для повседневного инференса. |
| NVIDIA-Nemotron-3-Super-120B-A12B-GGUF | UD-Q4_K_M | Примерно 82.5GB | ✅ | Запуск возможен благодаря большому объёму unified memory, но это уже тяжёлая модель для компактной APU-платформы. Лучше использовать один основной инстанс, умеренный контекст и оптимизированный GGUF-рантайм, поскольку память и пропускная способность делятся между CPU, iGPU и системными процессами. |
Совместимость с диффузионными моделями
| Модель | Тип | Совместимость | Примечание |
| Stable Diffusion 3 Medium (SD3-M) | Текст в изображение | ✅ | Работает на Radeon 8060S и подходит для локальной генерации изображений без дискретной видеокарты. Unified memory помогает с буферами и рабочими данными, но для комфортной скорости лучше использовать умеренное разрешение, небольшой batch и оптимизированный backend. |
| FLUX.2-klein-9B | Текст в изображение | ✅ | Хороший вариант для локальной генерации на AMD Ryzen AI Halo. Модель удобно запускать через ComfyUI, ONNX или другие оптимизированные сборки, а связка CPU + GPU + NPU делает платформу универсальной для creative- и AI-задач. |
| Stable Video Diffusion 1.1 (SVD 1.1) | Видео (img2vid) | ✅ | Unified memory помогает размещать видеобуферы и промежуточные данные, но Radeon 8060S остаётся интегрированной графикой, поэтому скорость будет ниже, чем у дискретных серверных GPU. Лучше использовать короткие ролики, умеренное разрешение и аккуратные настройки генерации. |
| Kandinsky-5.0-T2I-Lite-sft-Diffusers | Текст в изображение | ✅ | Лёгкая модель для этой конфигурации, подходящая для локальных генеративных пайплайнов. На Ryzen AI Halo можно держать дополнительные узлы обработки и рабочие приложения, не упираясь слишком жёстко в объём памяти. |
| Kandinsky-5.0-T2V-Lite-sft-5s-Diffusers | Текст в видео | ✅ | Подходит для коротких локальных видеогенераций и тестирования T2V-сценариев на компактной AI-станции. Для стабильной скорости лучше не завышать длину ролика, разрешение и число параллельных задач. |