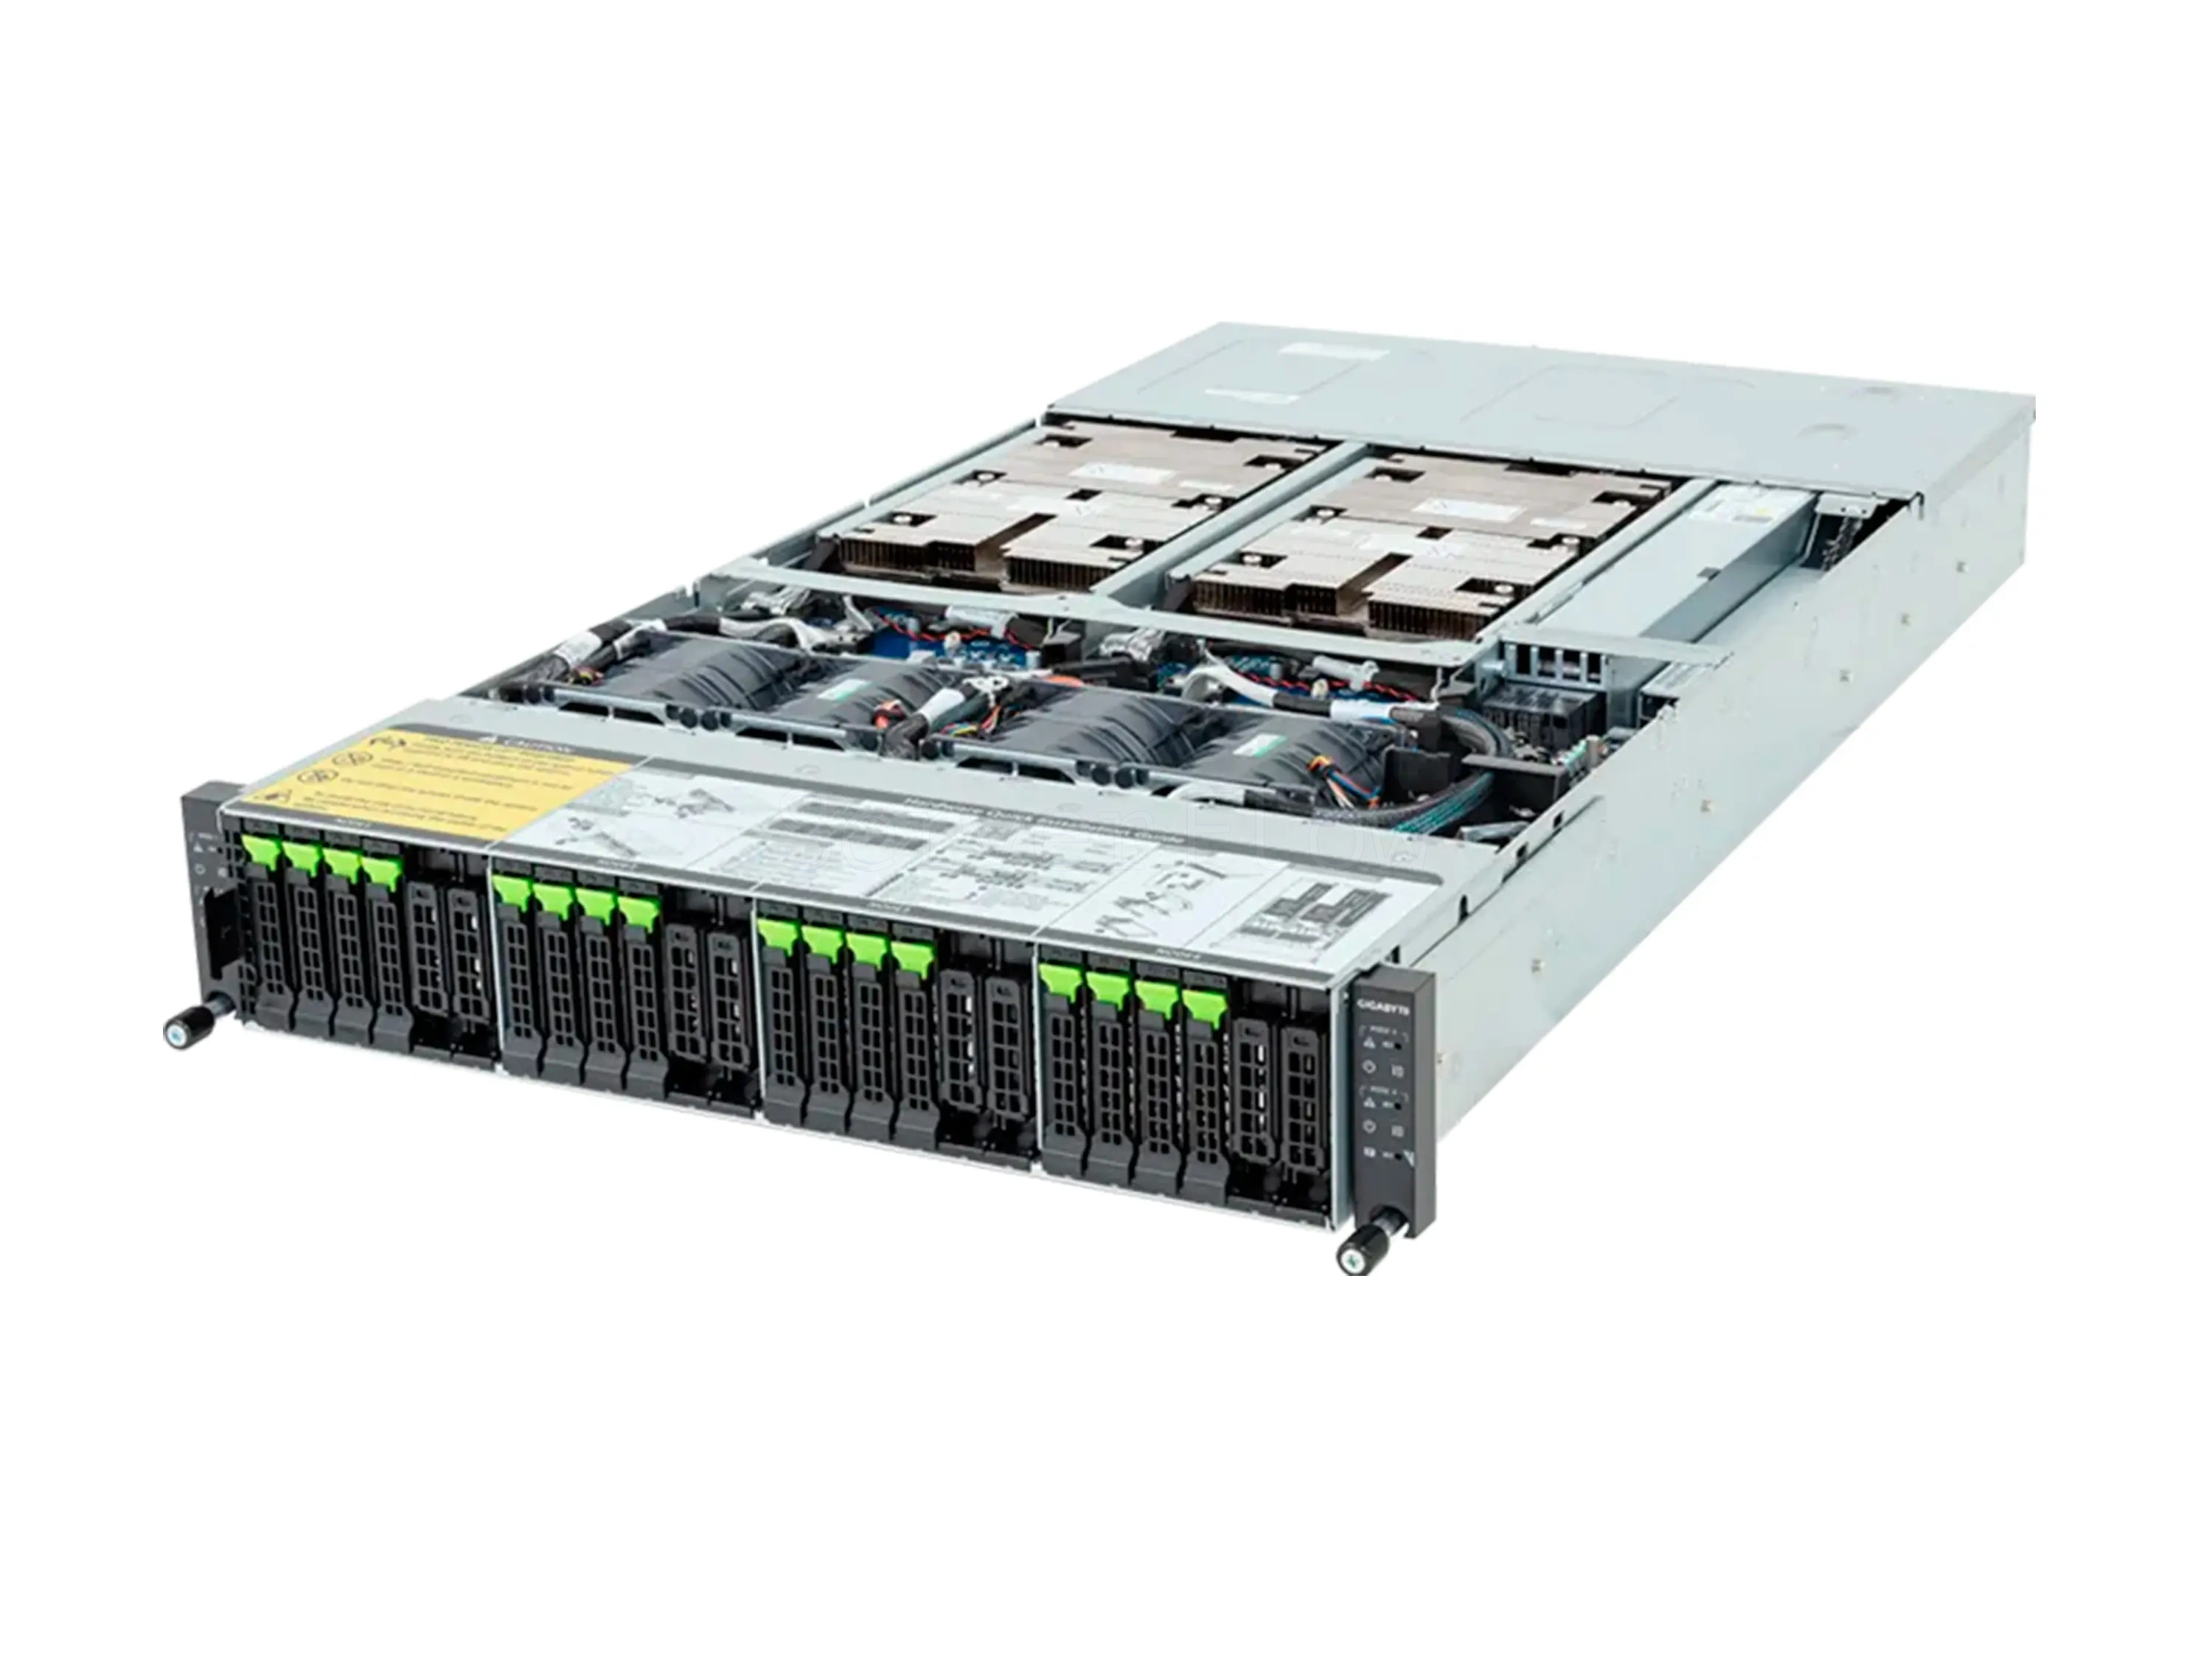
GIGABYTE H263-V60-AAW1 (8x RTX PRO 4500 BSE 32GB, 8x Grace, RAM 3.8TB)
16 961 800 ₽
Цена ориентировочная. Информация в каталоге не является публичной офертой.
- Артикул
- SF-23758
- Наличие
- Уточняется
- Обновлено
- 12.11.2026
Поставки организациям и ИП для бизнеса. Для оформления заказа свяжитесь с менеджером и согласуйте итоговую цену, комплектацию и наличие. Контакты менеджера
Характеристики
- Тип
- Новые
- Основная задача
- Обучение моделей / Инференс / Дообучение моделей / RAG-системы / Визуализация и рендеринг
- Процессор (CPU)
- NVIDIA Grace
- Видеокарта (GPU)
- NVIDIA RTX PRO 4500 Blackwell
- Количество GPU, шт
- 8
- Общий объем видеопамяти (VRAM), ГБ
- 256
- Тип памяти GPU
- GDDR7
- Объем оперативной памяти (RAM), ГБ
- 3840
- Тип оперативной памяти
- LPDDR5x
- Форм-фактор
- 2U
- Тип точности Совокупная мощность восьми RTX PRO 4500 BSE
- Совокупная мощность восьми RTX PRO 4500 BSE
- FP4 Tensor Core
- 1.6 PFLOPS
- FP8 Tensor Core
- 811 TFLOPS
- BF16 / FP16 Tensor Core
- 406 TFLOPS
- TF32 Tensor Core
- 203 TFLOPS
- FP32 Tensor Core
- 51 TFLOPS
- RT Core performance*
- 154 TFLOPS
- Платформа
- GIGABYTE H263-V60-AAW1
- Видеокарта
- 4x NVIDIA H100 NVL 94GB HBM3
- Процессор
- 8x NVIDIA Grace
- Оперативная память
- 3.8TB ECC LPDDR5X
- SSD накопитель
- 16x 2.5" Gen5 NVMe 2x M.2 (2280/22110)
Описание
GIGABYTE H263-V60-AAW1 - это не обычный односистемный сервер, а 2U 4-узловой блейд-сервер с задним доступом. У этой платформы официально заявлены 4 независимых узла, и на каждый узел приходится собственный NVIDIA Grace CPU Superchip, локальная память и свои PCIe-слоты. GIGABYTE указывает для модели форм-фактор 2U 4-node rear access server system, до 960GB LPDDR5X ECC на модуль, а также 8 low-profile PCIe Gen5 x16 slots на всю платформу.
Если разложить вашу конфигурацию по этим четырём системам, то получается так. 1 отдельная система - 2x RTX PRO 4500 BSE 32GB, 2x Grace CPU, 64GB GDDR7 VRAM и примерно 960GB RAM. 2 системы вместе - 4x RTX PRO 4500 BSE, 4x Grace CPU, 128GB VRAM и примерно 1.92TB RAM. Весь блейд целиком - 8x RTX PRO 4500 BSE, 8x Grace CPU, 256GB VRAM и примерно 3.84TB RAM. Это прямое арифметическое разложение вашей полной конфигурации на официальные 4 узла платформы.
По профилю нагрузки такая система особенно хороша для Инференса / Развертывания (Inference), RAG-систем, Анализа данных, Визуализации и рендеринга и Видеоаналитики / Видеонаблюдения. NVIDIA указывает для RTX PRO 4500 Blackwell Server Edition 32GB GDDR7, поддержку до двух MIG-инстансов по 16GB, ускорение видео через новые NVENC/NVDEC, а также прямое позиционирование под big data analytics, machine learning, graph processing и vector search. Это делает конфигурацию особенно удобной для плотного multi-tenant размещения, когда четыре узла можно использовать как четыре независимых сервера под разные команды или сервисы.
Важное ограничение здесь тоже есть. Эта конфигурация хорошо подходит для inference, средних и лёгких LLM, мультимодальных пайплайнов и графических задач, но это не замена системам на H100/H200 для максимально тяжёлого обучения больших моделей с нуля. Сильная сторона H263-V60-AAW1 именно в том, что его можно эксплуатировать как 4 отдельные AI-системы, как 2 более мощных объединённых контура, либо как один общий 8-GPU блейд под крупные inference- и reasoning-задачи.
Производительность GPU
| Тип точности | Совокупная мощность восьми RTX PRO 4500 BSE |
| FP4 Tensor Core | 1.6 PFLOPS |
| FP8 Tensor Core | 811 TFLOPS |
| BF16 / FP16 Tensor Core | 406 TFLOPS |
| TF32 Tensor Core | 203 TFLOPS |
| FP32 Tensor Core | 51 TFLOPS |
| RT Core performance* | 154 TFLOPS |
*-RT Core performance - это пиковая производительность специализированных RT-ядер (Ray Tracing Cores), которые аппаратно ускоряют операции трассировки лучей (поиск пересечений луча с геометрией и обход BVH). Показатель важен для визуализации/рендеринга и некоторых графических/3D-пайплайнов, но не является прямым аналогом FP32/AI-производительности.
Совместимость с LLM-моделями
| Модель | Тип квантизации | Требуется VRAM | Совместимость | Примечание |
| DeepSeek-R1-Distill-Llama-70B | Нет | Примерно 141GB | ✅ | Оптимальнее запускать не в одной отдельной системе, а минимум на двух объединённых узлах или на всём блейде, чтобы сохранить запас под контекст, KV-cache и стабильный multi-GPU serving. |
| Qwen3.6-35B-A3B-FP8 | FP8 | Примерно 37.5GB | ✅ | Хорошо подходит даже для одной отдельной системы с 2 GPU и оставляет запас под длинный контекст, стабильную нагрузку и параллельный inference. |
| gpt-oss-120b | Нет | Примерно 196GB | ✅ | Рациональнее использовать весь блейд целиком, потому что модель уже ориентируется на суммарный ресурс всех 8 GPU и лучше чувствует себя при запуске на общей конфигурации. |
| Gemma-4-31B-it | Нет | Примерно 62.6GB | ✅ | Удобно запускается даже в одной отдельной системе на 2 GPU и хорошо подходит для параллельной работы нескольких независимых сервисов на четырёх узлах. |
| MiMo-V2.5-GGUF | UD_Q4_K_M | Примерно 191GB | ✅ | Компактная GGUF-версия для более доступного развёртывания; подходит для серверов с ограниченным объёмом памяти, RAG-сценариев, ассистентов и локального инференса. |
Совместимость с диффузионными моделями
| Модель | Тип | Совместимость | Примечание |
| stable-diffusion-3.5-medium | Текст в изображение | ✅ | Хорошо подходит даже для одной отдельной системы на 2 GPU, а вся блейд-платформа позволяет параллельно держать до четырёх независимых генеративных контуров. |
| FLUX.2-dev | Текст в изображение | ✅ | Для этой модели удобнее использовать две объединённые системы или весь блейд, чтобы держать более стабильную генерацию, высокий батч и запас под служебные буферы. |
| SD Turbo | Быстрые предпросмотры | ✅ | Очень удачный сценарий для этой платформы - можно распределить быстрые preview-задачи между четырьмя отдельными системами и обслуживать много запросов одновременно. |
| Kandinsky-5.0-T2I-Lite-sft-Diffusers | Текст в изображение | ✅ | Лёгкая модель для этой платформы и хорошо подходит для раздельного запуска на нескольких узлах с высоким разрешением и несколькими параллельными процессами. |
| Kandinsky-6.0-Pro-distill-5s-Diffusers | Текст/изображение в видео со звуком | ✅ | Подходит для коротких роликов и пакетной обработки, при этом нагрузку удобно разносить между четырьмя отдельными системами или собирать в более мощный двухузловой контур. |
| NVIDIA-Cosmos3-Super | Генерации, анализа и симуляции физического мира, которая может работать с текстом, изображениями, видео и действиями | ✅ | Модель объёмом 133 GB для генерации, анализа и симуляции физического мира. Работает с текстом, изображениями, видео и действиями, поэтому подходит для сложных мультимодальных сценариев. Требует высокой производительности и большого объёма видеопамяти, а стабильность запуска зависит от конкретной конфигурации и настроек оптимизации. |
Технические характеристики
| Платформа | GIGABYTE H263-V60-AAW1 |
| Видеокарта | 4x NVIDIA H100 NVL 94GB HBM3 |
| Процессор | 8x NVIDIA Grace |
| Оперативная память | 3.8TB ECC LPDDR5X |
| SSD накопитель | 16x 2.5" Gen5 NVMe
2x M.2 (2280/22110) |