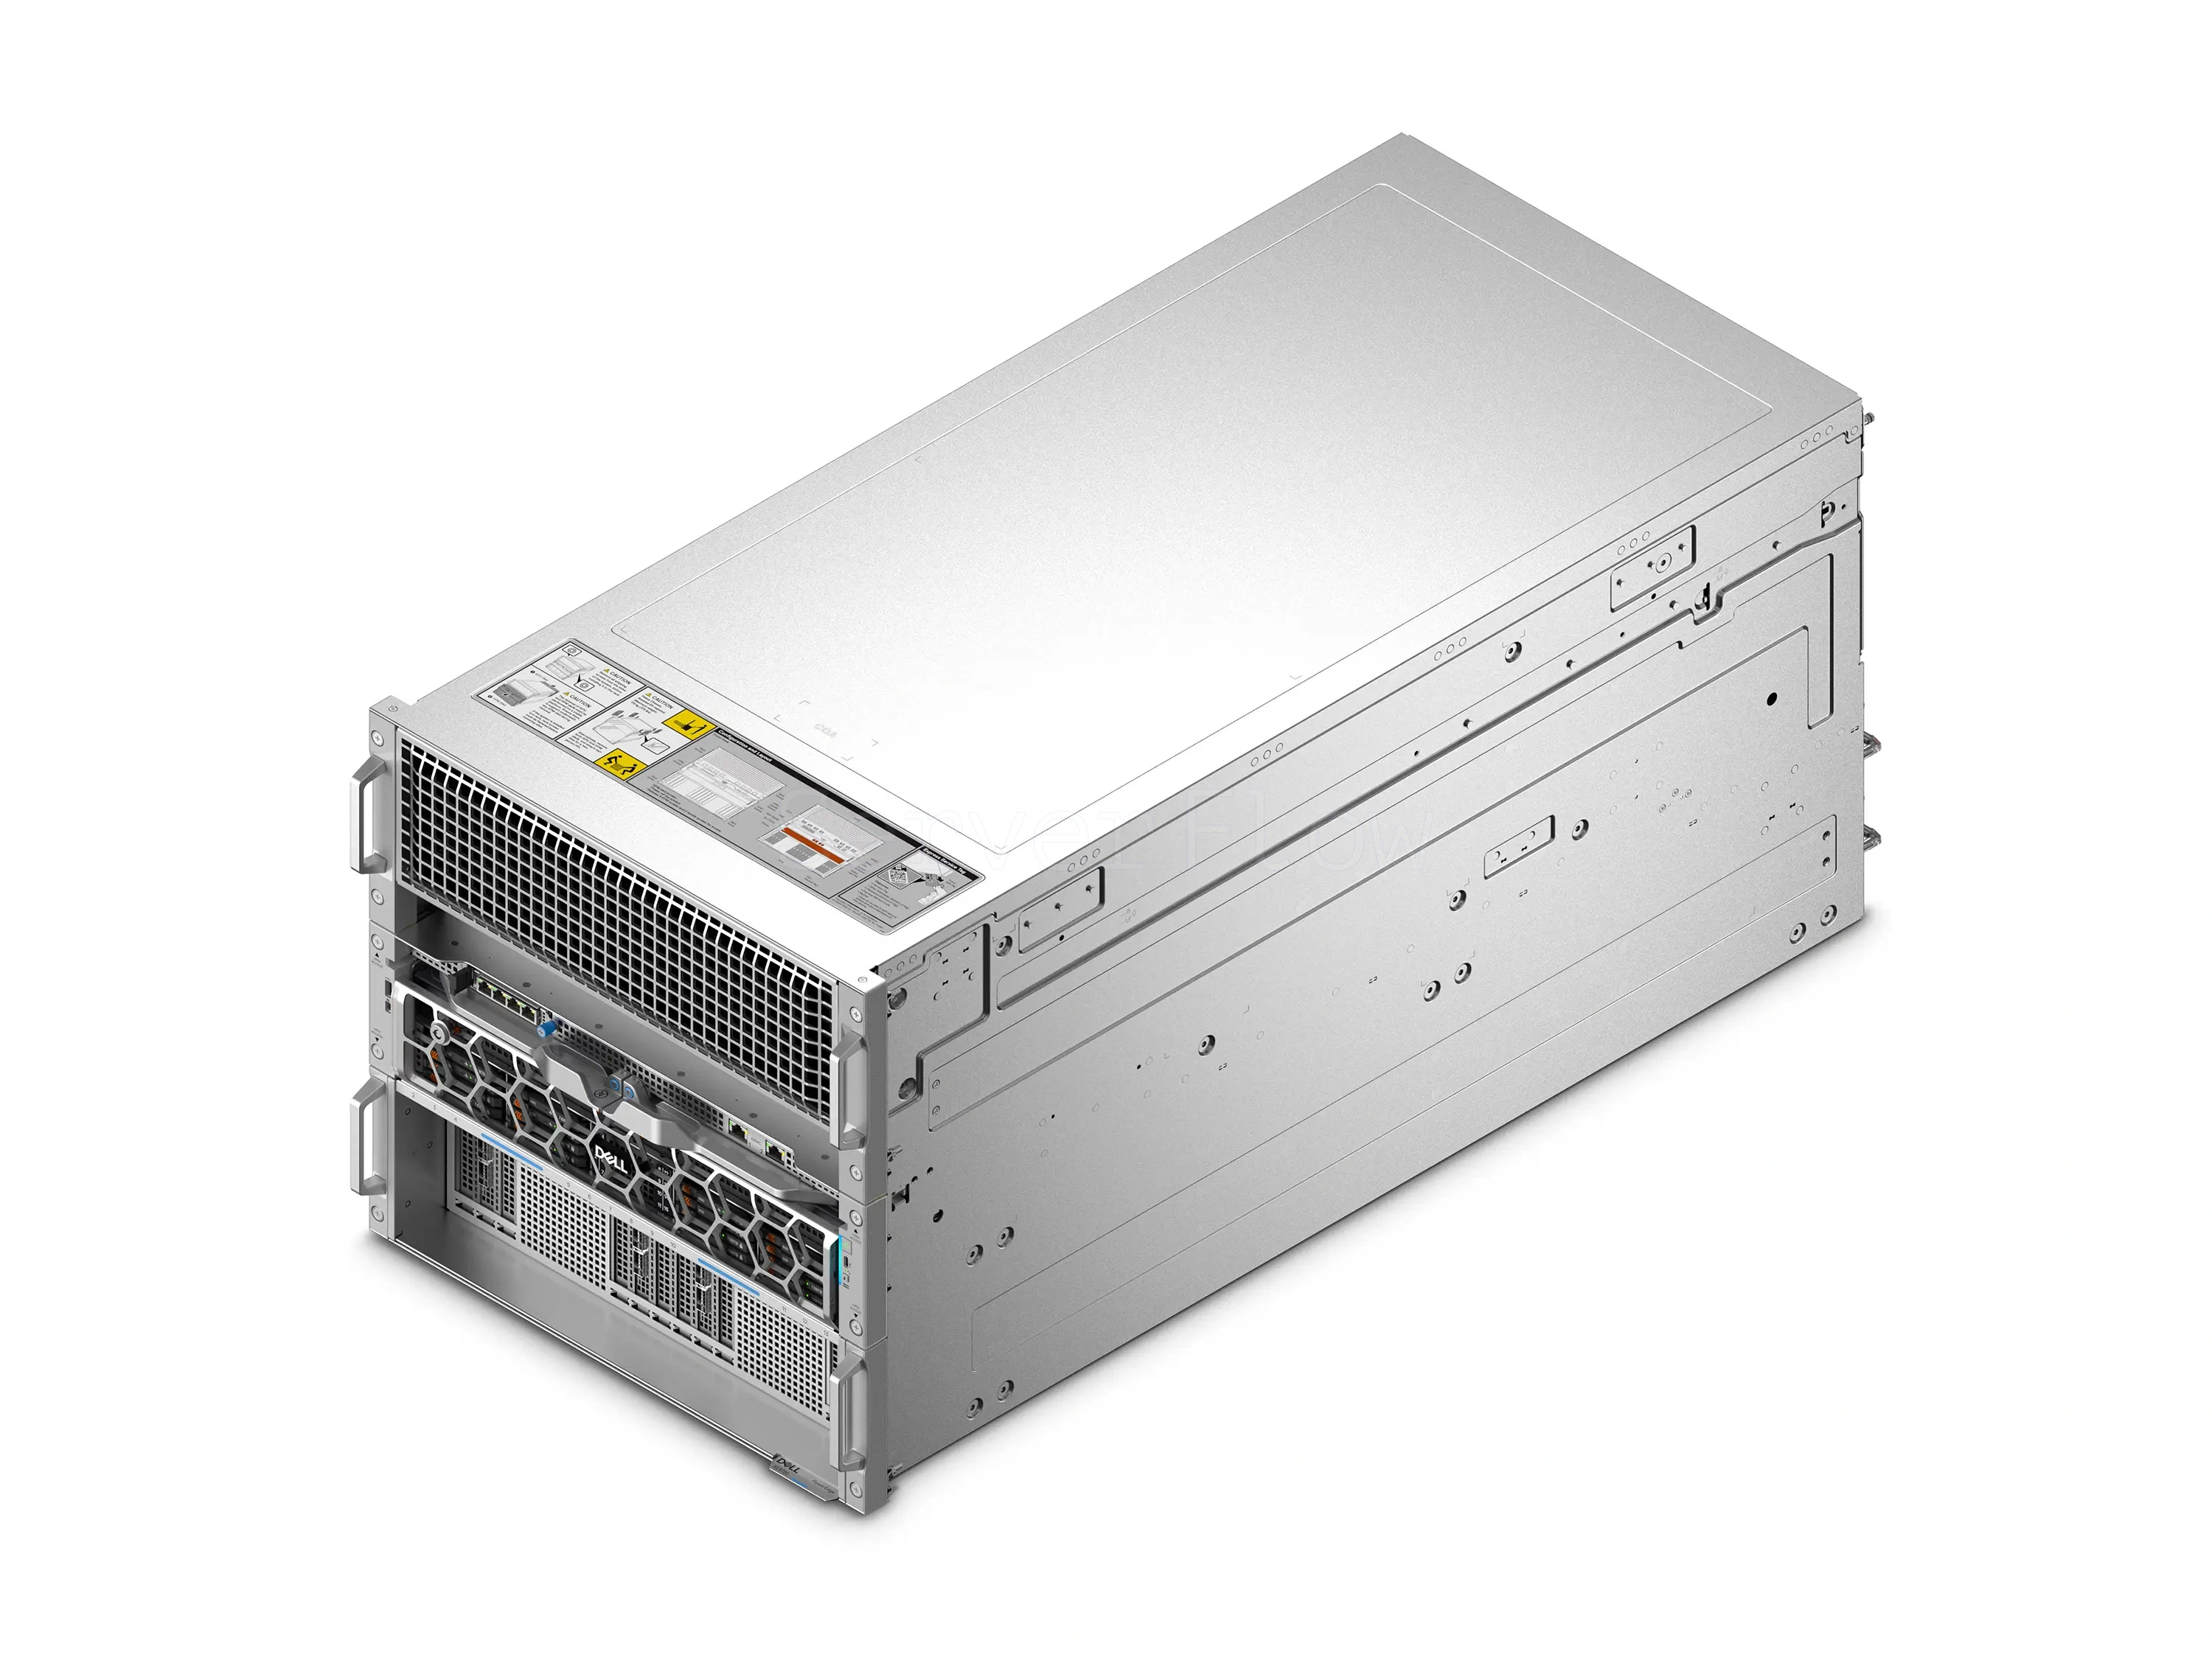
DELL PowerEdge XE9780 (8× B300 SXM 288GB)
103 233 800 ₽
Цена ориентировочная. Информация в каталоге не является публичной офертой.
- Артикул
- SF-20865
- Наличие
- Уточняется
- Обновлено
- 12.11.2026
Поставки организациям и ИП для бизнеса. Для оформления заказа свяжитесь с менеджером и согласуйте итоговую цену, комплектацию и наличие. Контакты менеджера
Характеристики
- Тип
- Новые
- Основная задача
- Обучение моделей / Инференс / Дообучение моделей / RAG-системы / Анализ данных / Научные расчеты (HPC) / Визуализация и рендеринг
- Процессор (CPU)
- Intel Xeon 6-series
- Видеокарта (GPU)
- NVIDIA B300 SXM
- Количество GPU, шт
- 8
- Общий объем видеопамяти (VRAM), ГБ
- 2304
- Тип памяти GPU
- HBM3e
- Объем оперативной памяти (RAM), ГБ
- 4096
- Тип оперативной памяти
- DDR5 ECC REG
- Форм-фактор
- 10U
- Тип точности Совокупная мощность HGX B300 8-GPU
- Совокупная мощность HGX B300 8-GPU
- FP8/FP6 Tensor core (training)
- 72 PFLOPS
- FP4 Tensor core (inference)
- 144 PFLOPS
- Видеокарта
- 8x Nvidia B300 SXM 288GB HBM3e
- Процессор
- 2× Intel Xeon 6 серии (до 86 ядер на процессор)
- Оперативная память
- до 4TB DDR5 ECC RDIMM, 32 слота
- SSD накопители
- 16x E3.S Gen5 NVMe direct SSD или 10x U.2 Gen5 NVMe SSD, а под загрузочный массив предусмотрен BOSS-N1 с 2x M.2 SSD
Описание
Конфигурация ориентирована на обучение моделей (Training) и дообучение моделей (Fine-tuning), когда важны масштабирование по 8 GPU, высокая пропускная способность и стабильность под длительной нагрузкой. Также платформа отлично подходит для инференса / развертывания (Inference) и RAG-систем, где решают скорость отклика, параллельные запросы и большой запас видеопамяти под KV-cache.
GPU-профиль B300 - это архитектура Blackwell с поддержкой FP16/FP8/INT8 и HBM3e, поэтому сервер подходит как для тяжелого тренинга, так и для production-serving с высоким throughput. В узле используется NVIDIA HGX B300 NVL8 с полной связностью по NVLink, а суммарный объём VRAM в этой сборке - 2304 GB (2.3 TB), что упрощает работу с крупными моделями и длинным контекстом.
В практических сценариях это означает, что можно держать большие батчи и высокий concurrency, а при росте контекста управлять расходом памяти через лимиты контекста и настройки батчинга, чтобы не упираться в KV-cache в пиковых нагрузках.
Платформа поддерживает 2× Intel Xeon Scalable 6-го поколения (в документации указано до 86 ядер на процессор), память DDR5 RDIMM - 32 слота с частотой до 6400 MT/s и максимальным объёмом до 4 TB. Для накопителей доступны фронтальные конфигурации до 16× E3.S NVMe или до 10× U.2 NVMe, а под загрузочный массив предусмотрен BOSS-N1 - 2× M.2 NVMe (HW RAID 1).
Производительность GPU
| Тип точности | Совокупная мощность HGX B300 8-GPU |
| FP8/FP6 Tensor core (training) | 72 PFLOPS |
| FP4 Tensor core (inference) | 144 PFLOPS |
Совместимость с LLM-моделями
| Модель | Тип квантизации | Требуется VRAM | Совместимость | Примечание |
| DeepSeek-V4-Pro | Нет | Примерно 865GB | ✅ | Оптимально распределять на 8 GPU - остаётся большой запас VRAM под длинный контекст и батчи. |
| Qwen3.5-397B-A17B / Qwen3.6-35B-A3B | Нет | Примерно 807GB / 71.9 GB | ✅ | Удобно масштабировать TP на 2-8 GPU - хороший вариант для продакшн-serving и RAG. |
| Gpt-oss:120b | Нет | Примерно 196GB | ✅ | Комфортно держать на 1-2 GPU, повышая QPS батчами и сохраняя запас под KV-cache. |
| GigaChat3.5-432B-A28B-bf16 | Нет | Примерно 868GB | ✅ | Лучше распределять на 8 GPU - стабильный throughput и длинные контексты без дефицита VRAM. |
| Mistral-Large-3-675B-Instruct-251 | Нет | Примерно 682GB | ✅ | Запускается без квантизации на 8 GPU - остаётся запас VRAM под контекст и KV-cache. |
| GLM-5.3 | Нет | Примерно 756GB | ✅ | Стабильный продакшн-запуск на 8 GPU - удобно держать высокий параллелизм запросов. |
| Kimi-K3 | Нет | Примерно 1.56TB | ✅ | Полноразмерная версия для мощных GPU-серверов; подходит для reasoning-задач, RAG, агентных рабочих процессов и производственного инференса с высоким запасом качества. |
| MiniMax-M3 | Нет | Примерно 854GB | ✅ | Полноразмерная версия для серверов с большим запасом памяти; подходит для reasoning-задач, RAG, агентных сценариев и стабильного production-инференса без агрессивной квантизации. |
| MiMo-V2.5-Pro | Нет | Примерно 1.03TB | ✅ | Крупная Pro-версия для серверов с большим объёмом GPU-памяти; подходит для сложных reasoning-задач, RAG, агентных сценариев и production-инференса с высоким запасом качества. |
Совместимость с диффузионными моделями
| Модель | Тип | Совместимость | Примечание |
| Stable Diffusion XL 1.0 | Текст в изображение | ✅ | Высокие разрешения и большие батчи - очереди легко распараллелить по GPU. |
| Flux.2-dev | Текст в изображение | ✅ | Большой запас VRAM под high-res и крупные батчи - распределение задач по GPU повышает throughput. |
| SD Turbo | Быстрые предпросмотры | ✅ | Максимальный throughput для предпросмотров при высокой параллельности на одном узле. |
| Kandinsky-5.0-T2I-Lite-sft-Diffusers | Текст в изображение | ✅ | Несколько пайплайнов одновременно и высокий QPS без упора в видеопамять. |
| Kandinsky-5.0-T2V-Lite-sft-5s-Diffusers | Текст в видео | ✅ | Пакетная генерация коротких роликов - удобно распараллелить по GPU без очередей. |
| NVIDIA-Cosmos3-Super | Генерации, анализа и симуляции физического мира, которая может работать с текстом, изображениями, видео и действиями | ✅ | Модель объёмом 133 GB для генерации, анализа и симуляции физического мира. Работает с текстом, изображениями, видео и действиями, поэтому подходит для сложных мультимодальных сценариев. Требует высокой производительности и большого объёма видеопамяти, а стабильность запуска зависит от конкретной конфигурации и настроек оптимизации. |
Технические характеристики
| Видеокарта | 8x Nvidia B300 SXM 288GB HBM3e |
| Процессор | 2× Intel Xeon 6 серии (до 86 ядер на процессор) |
| Оперативная память | до 4TB DDR5 ECC RDIMM, 32 слота |
| SSD накопители | 16x E3.S Gen5 NVMe direct SSD или 10x U.2 Gen5 NVMe SSD, а под загрузочный массив предусмотрен BOSS-N1 с 2x M.2 SSD |
Если нужна конфигурация на эту платформу под ваши задачи - свяжитесь с менеджером, и мы предложим подходящий вариант под бюджет и требования.