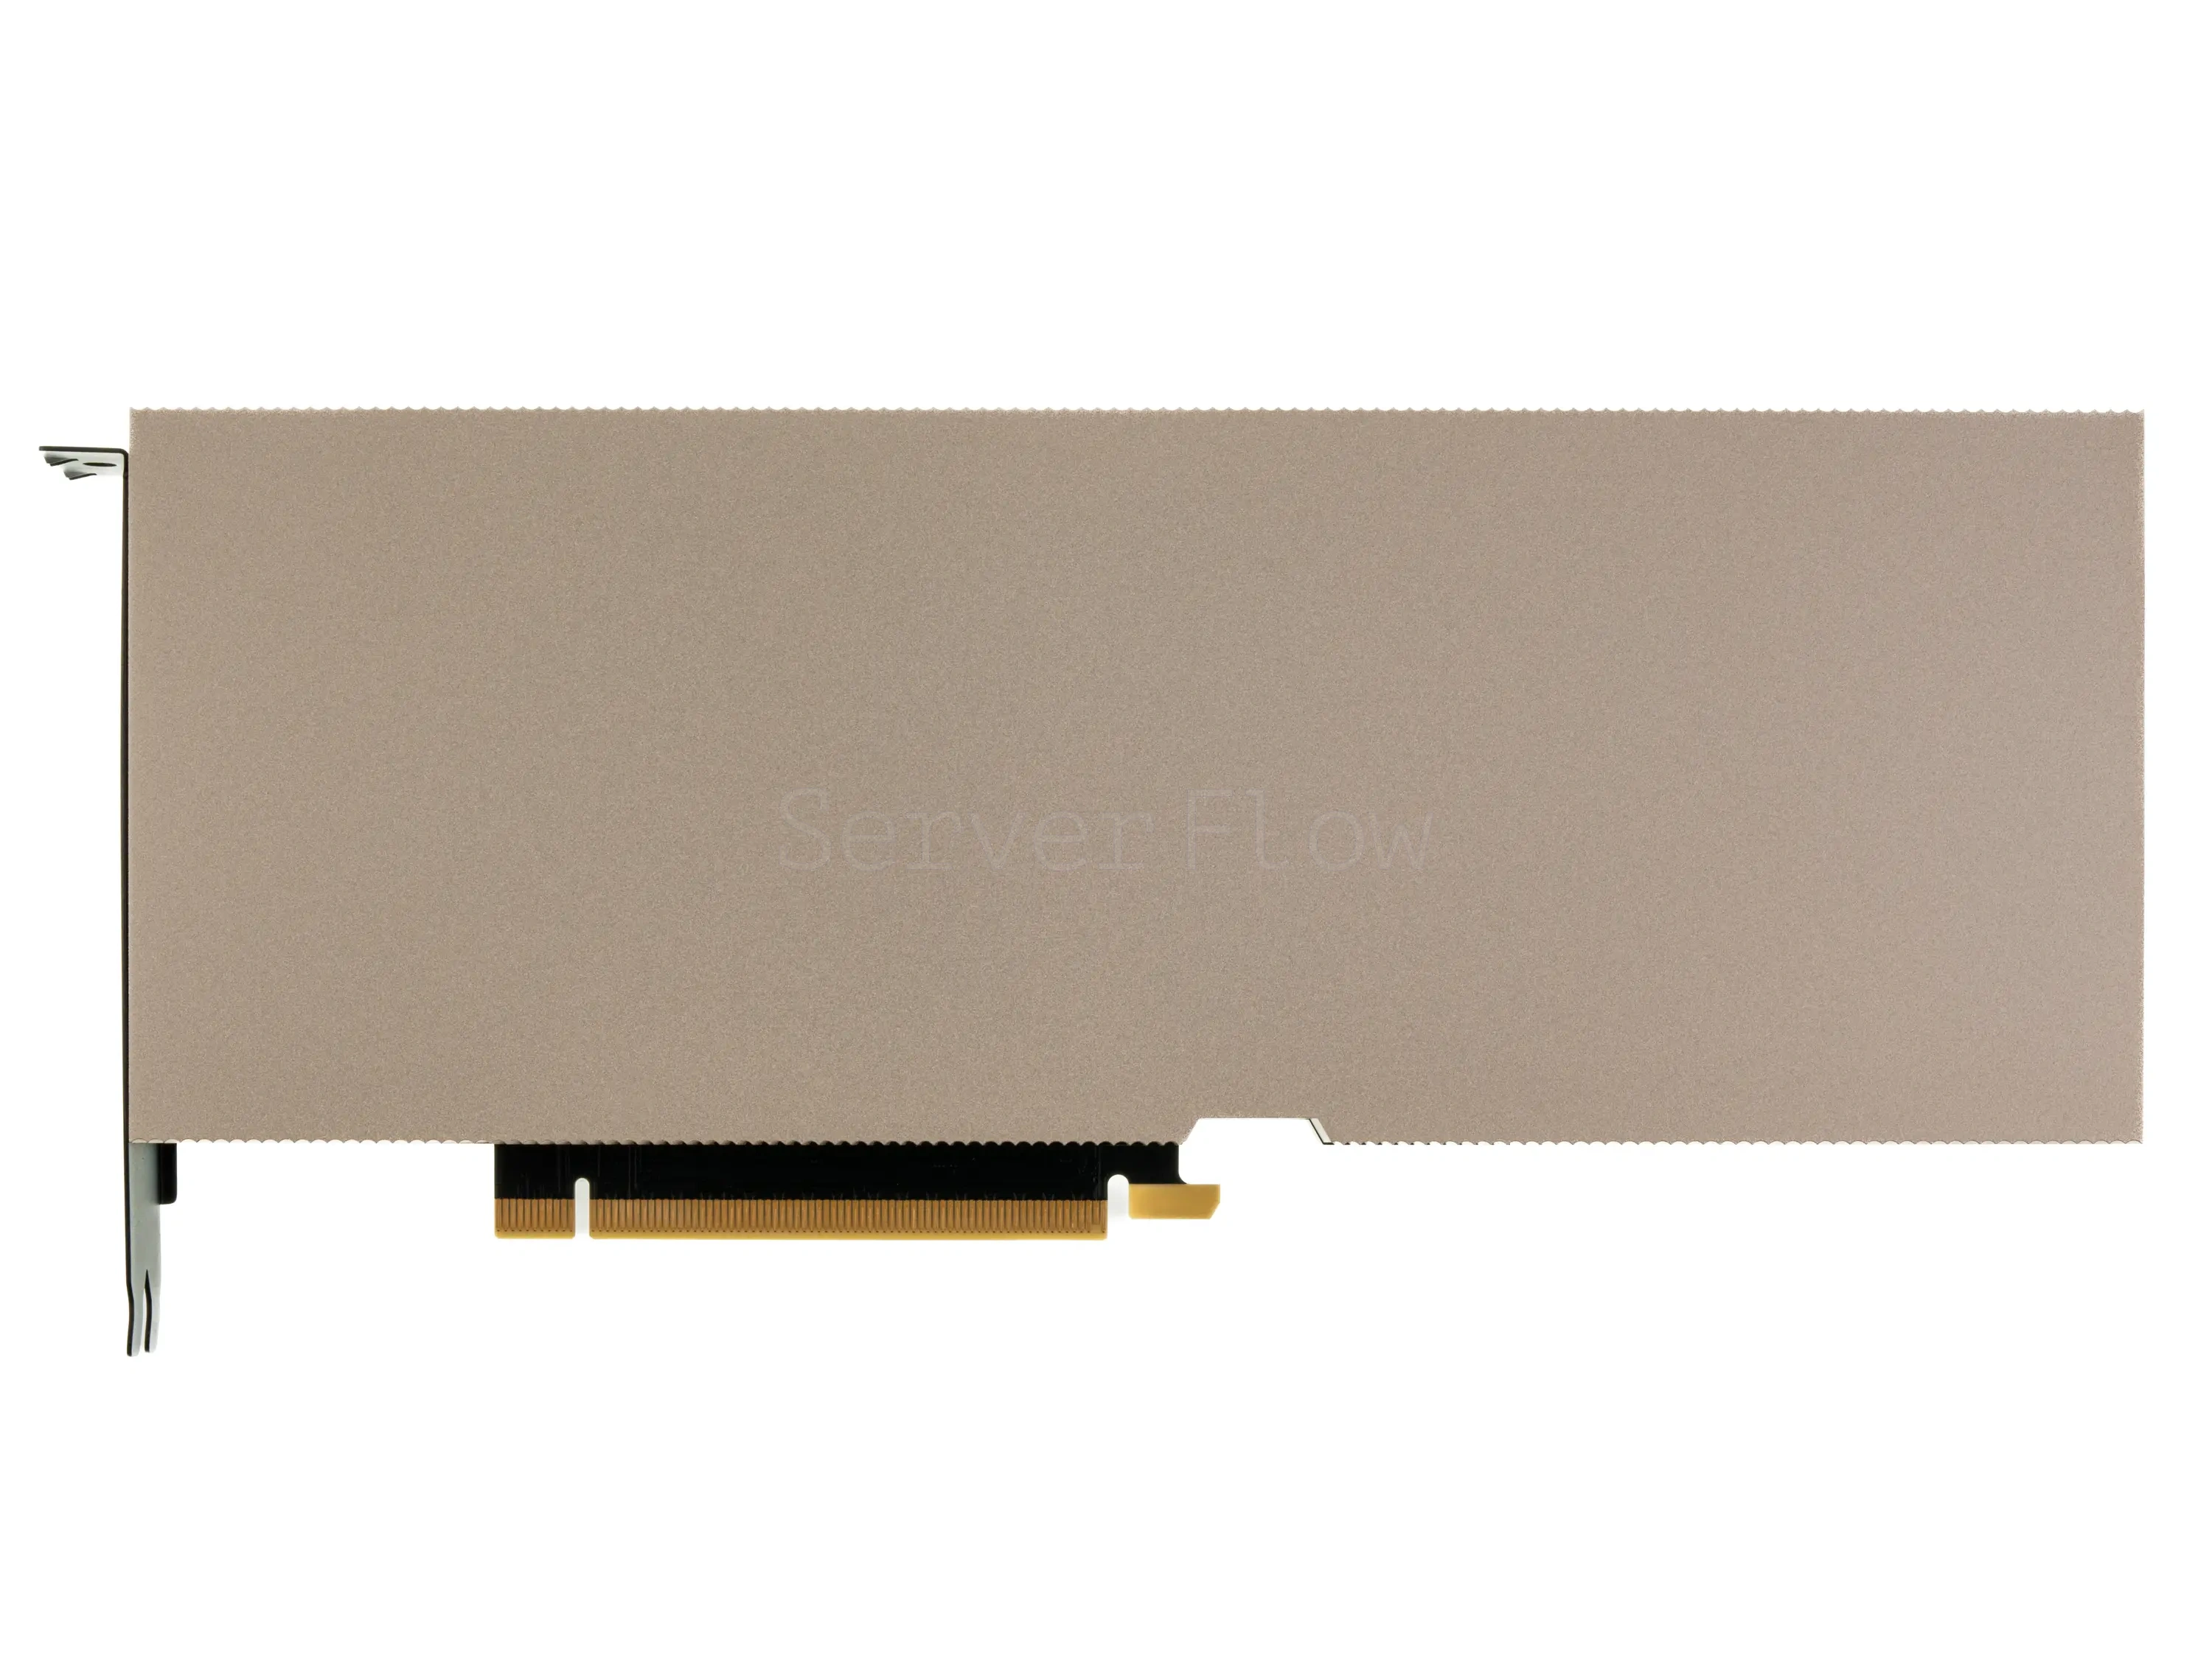
Видеокарта NVIDIA A100 OEM 40GB HBM2e [900-21001-0000-000]
25 900 ₽
Цена ориентировочная. Информация в каталоге не является публичной офертой.
- Артикул
- SF-00003020
- Партномер
- 900-21001-0000-000 / 900-21001-0100-030
- Наличие
- Уточняется
- Обновлено
- 12.11.2026
Поставки организациям и ИП для бизнеса. Для оформления заказа свяжитесь с менеджером и согласуйте итоговую цену, комплектацию и наличие. Контакты менеджера
Характеристики
- Тип
- Новые
- Парт.№
- 900-21001-0000-000 / 900-21001-0100-030
- Тип видеокарты
- Для вычислений
- Количество видеовыходов
- 0
- Видеовыходы
- Нет
- Объем видеопамяти
- 40GB
- Тип видеопамяти
- HBM2
- Разрядность шины памяти
- 5120 bit
- Наличие памяти с коррекцией ошибок(ECC)
- Да
- Частота графического процессора Base Frequency, MHz
- 765
- Максимальная частота графического процессора Turbo Frequency, MHz
- 1410
- Количество вычислительных ядер
- 6912
- Интерфейс подключения
- PCIe 4.0 x16
- Количество занимаемых слотов
- 2
- Совместимость с низкопрофильными решениями
- Нет
- TDP ускорителя, W
- 250
- Тип охлаждения
- Пассивное
- Наличие NVLink
- Поддерживается
- Поддержка ПО vGPU
- Нет
- Архитектура графического процессора
- Ampere
- Наличие кодировщиков NVENC | NVDEC
- NVDEC: 4th Gen
- Разъемы питания
- 1x 8-pin EPS
- Длина видеокарты, mm
- 267
Описание
NVIDIA A100 40GB: Ускоритель нового уровня для ИИ, HPC и аналитики данных
Мощь для прорывных вычислений: Видеокарта NVIDIA A100 40GB на базе революционной архитектуры Ampere — это отраслевой стандарт для ускорения самых требовательных рабочих нагрузок в области искусственного интеллекта (ИИ), высокопроизводительных вычислений (HPC) и анализа больших данных. Оснащенная 40 ГБ высокоскоростной памяти HBM2e с рекордной пропускной способностью до 1.5 ТБ/с, A100 обеспечивает беспрецедентную производительность для обработки гигантских наборов данных и сложнейших моделей.
ИИ производительность:
| Режим вычислений | TFLOPS | TFLOPS* |
| TF32/FP32 | 156 | 312 |
| BFLOAT16/FP16 | 312 | 624 |
| INT8 | 624 | 1248 |
* С использованием структурной разряженности моделей
Ключевые характеристики и преимущества:
Архитектура NVIDIA Ampere:
- Тензорные ядра 3-го поколения: Обеспечивают беспрецедентное ускорение операций смешанной точности (FP64, TF32, FP16, BFLOAT16, INT8, INT4) для обучения и выполнения ИИ-моделей, включая крупные языковые модели (LLM).
- Выдающаяся производительность:
- Пиковая производительность: до 19.5 TFLOPS (FP64), 624 TFLOPS (FP16 Tensor Core с использованием sparsity).
- Ускорение в 20 раз по сравнению с предыдущими поколениями для задач ИИ и HPC.
- Поддержка структурной разреженности (Sparsity): Дополнительно повышает производительность ИИ-вычислений.
Гигантская и быстрая память:
- 40 ГБ HBM2e памяти: Экстремально высокая пропускная способность (1.5 ТБ/с) и низкие задержки.
- Единая память с ECC: Обеспечивает целостность данных в критически важных вычислениях.
- Большой объем: Позволяет работать с огромными моделями ИИ (включая современные LLM) и наборами данных, которые не помещаются в память других ускорителей.
Передовые технологии масштабирования и виртуализации:
- NVIDIA NVLink 3.0: Обеспечивает сверхвысокую скорость соединения между несколькими A100 (до 600 ГБ/с), создавая мощные кластеры для масштабных задач.
- Multi-Instance GPU (MIG): Позволяет разделить одну A100 на несколько (до 7) полностью изолированных GPU-экземпляров с гарантированными QoS. Идеально для облачных сред и оптимального использования ресурсов.
- Поддержка NVIDIA Virtual GPU (vGPU): Обеспечивает мощную виртуализацию GPU для виртуальных рабочих станций (vWS), виртуальных сред для ИИ (AI) и ЦОД. *(Требуется соответствующее ПО и лицензии NVIDIA vGPU).*
- Высокая пропускная способность:
- PCIe 4.0 x16: Удвоенная пропускная способность по сравнению с PCIe 3.0 для быстрого обмена данными с CPU и другими компонентами системы.
Основные сферы применения:
- Обучение и инференс сложнейших моделей ИИ: Глубокое обучение, генеративный ИИ, крупные языковые модели (LLM), рекомендательные системы.
- Научные вычисления (HPC): Молекулярное моделирование, вычислительная гидродинамика (CFD), квантовые вычисления, прогнозирование климата.
- Аналитика больших данных: Обработка и анализ эксабайтных массивов данных в реальном времени.
- Виртуализация и облачные вычисления: Высокопроизводительные виртуальные рабочие станции (vWS), виртуализированные среды для ИИ и HPC.
- Геномные исследования и открытия в медицине.
Форм-фактор и требования:
- Доступна в форм-факторах PCI-E (двухслотовый, пассивное охлаждение).
- Высокое энергопотребление (TDP ~250-400 Вт в зависимости от версии), требует соответствующего серверного питания и охлаждения.
- Важно: Это профессиональный ускоритель, предназначенный в первую очередь для серверных стоек и дата-центров.
NVIDIA A100 40GB — это не просто видеокарта, это фундамент для инноваций. Она открывает возможности для решения задач, которые раньше считались невозможными, ускоряя научные открытия и развитие искусственного интеллекта.

Прирост производительности NVIDIA A100, по сравнению с предыдущими видеокартами серии Tesla.

Производительность видеокарты NVIDIA A100 в нейросетевой модели BERT от Google.