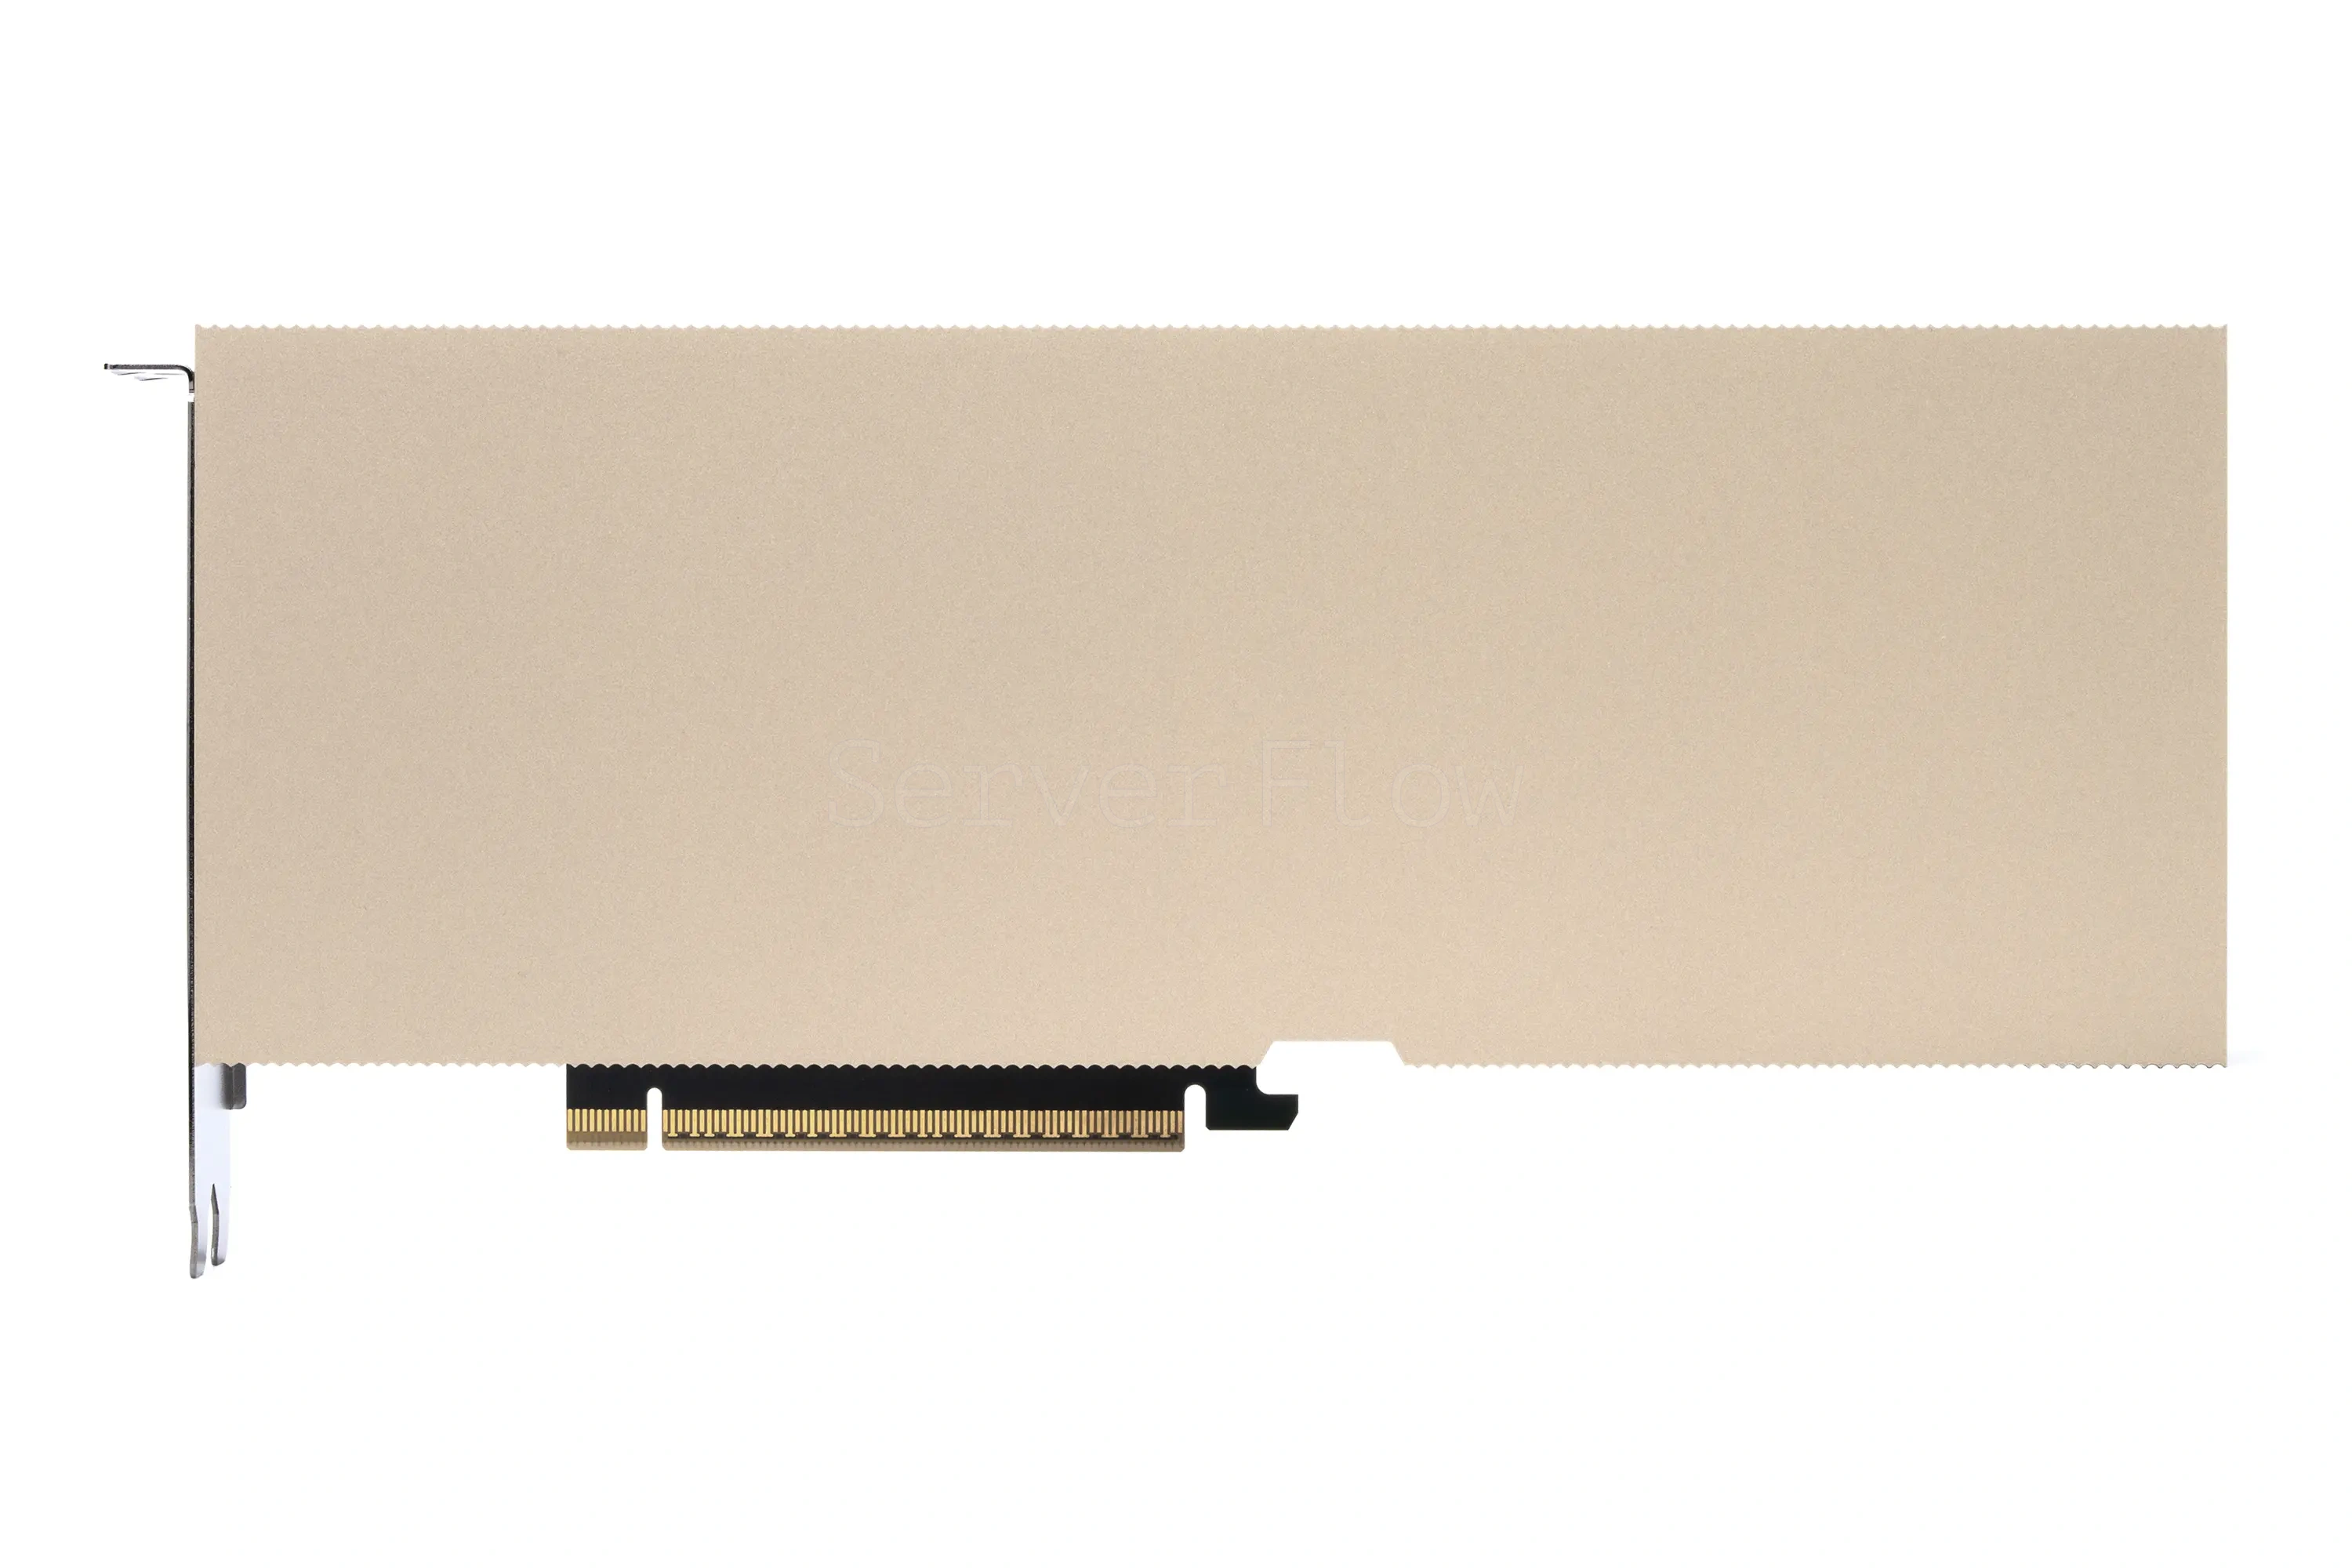
Видеокарта NVIDIA H100 OEM 96GB HBM3 [900-21010-0000-000]
25 900 ₽
Цена ориентировочная. Информация в каталоге не является публичной офертой.
- Артикул
- SF-00003147
- Наличие
- Уточняется
- Обновлено
- 12.11.2026
Поставки организациям и ИП для бизнеса. Для оформления заказа свяжитесь с менеджером и согласуйте итоговую цену, комплектацию и наличие. Контакты менеджера
Характеристики
- Тип
- Новые
- Тип видеокарты
- Для вычислений
- Количество видеовыходов
- 0
- Видеовыходы
- Нет
- Объем видеопамяти
- 96GB
- Тип видеопамяти
- HBM3
- Разрядность шины памяти
- 5120 bit
- Наличие памяти с коррекцией ошибок(ECC)
- Да
- Частота графического процессора Base Frequency, MHz
- 1665
- Максимальная частота графического процессора Turbo Frequency, MHz
- 1837
- Количество вычислительных ядер
- 16896
- Интерфейс подключения
- PCIe 5.0 x16
- Количество занимаемых слотов
- 2
- Совместимость с низкопрофильными решениями
- Нет
- TDP ускорителя, W
- 700
- Тип охлаждения
- Пассивное
- Наличие NVLink
- Поддерживается
- Поддержка ПО vGPU
- Нет
- Архитектура графического процессора
- Hopper
- Наличие кодировщиков NVENC | NVDEC
- Нет
- Разъемы питания
- 1x 8-pin EPS
- Длина видеокарты, mm
- 267
- Тип операций
- Производительность
- FP64 Tensor Core
- 51 TFLOPS
- FP8 Tensor Core
- 3958 TFLOPS
- BF16 / FP16 Tensor Core
- 1979 TFLOPS
- TF32 Tensor Core
- 989 TFLOPS
- INT8 Tensor Core
- 3958 TOPS
Описание
NVIDIA H100 OEM с 96 GB HBM3 — это редкий и высоко специализированный пассивный ускоритель на архитектуре Hopper, предназначенный для создания масштабируемых ИИ‑кластеров и инференса самых ресурсоёмких моделей, включая deepseek‑r1:70B и Mistral‑Large‑Instruct (Q4_K_M). GPU включает 14 592 CUDA‑ядер и 456 тензорных ядер 4‑го поколения, что позволяет обрабатывать сложные LLM с сотнями миллиардов параметров. Объём памяти 96 GB HBM3 обеспечивает пропускную способность порядка 3 TB/s, что критично при обработке LLM со стотысячами параметров. Карта поддерживает NVLink 4‑го поколения (900 GB/s общая пропускная способность), дающий возможность строить системы с быстрой меж‑GPU связью
Ускоритель совместим с NVIDIA AI Enterprise и Triton Inference Server, поддерживает Multi‑Instance GPU (до 7 MIG) и vGPU, что позволяет эффективно распределять ресурсы внутри кластеров. Пассивное охлаждение требует установки в сервер с направленным воздушным потоком, карта занимает два слота PCIe Gen5 x16, потребляя до 350 Ватт. Как и все серверные ускорители серии H100, она не имеет видеовыходов и не оснащена NVENC/NVDEC, полностью ориентирована на ИИ‑вычисления.
Это решение идеально подходит для построения плотных кластеров из сотен GPU, способных выполнять самые сложные задачи по обучению и инференсу генеративных нейросетей в Linux-среде.
| Тип операций | Производительность |
| FP64 Tensor Core | 51 TFLOPS |
| FP8 Tensor Core | 3958 TFLOPS |
| BF16 / FP16 Tensor Core | 1979 TFLOPS |
| TF32 Tensor Core | 989 TFLOPS |
| INT8 Tensor Core | 3958 TOPS |