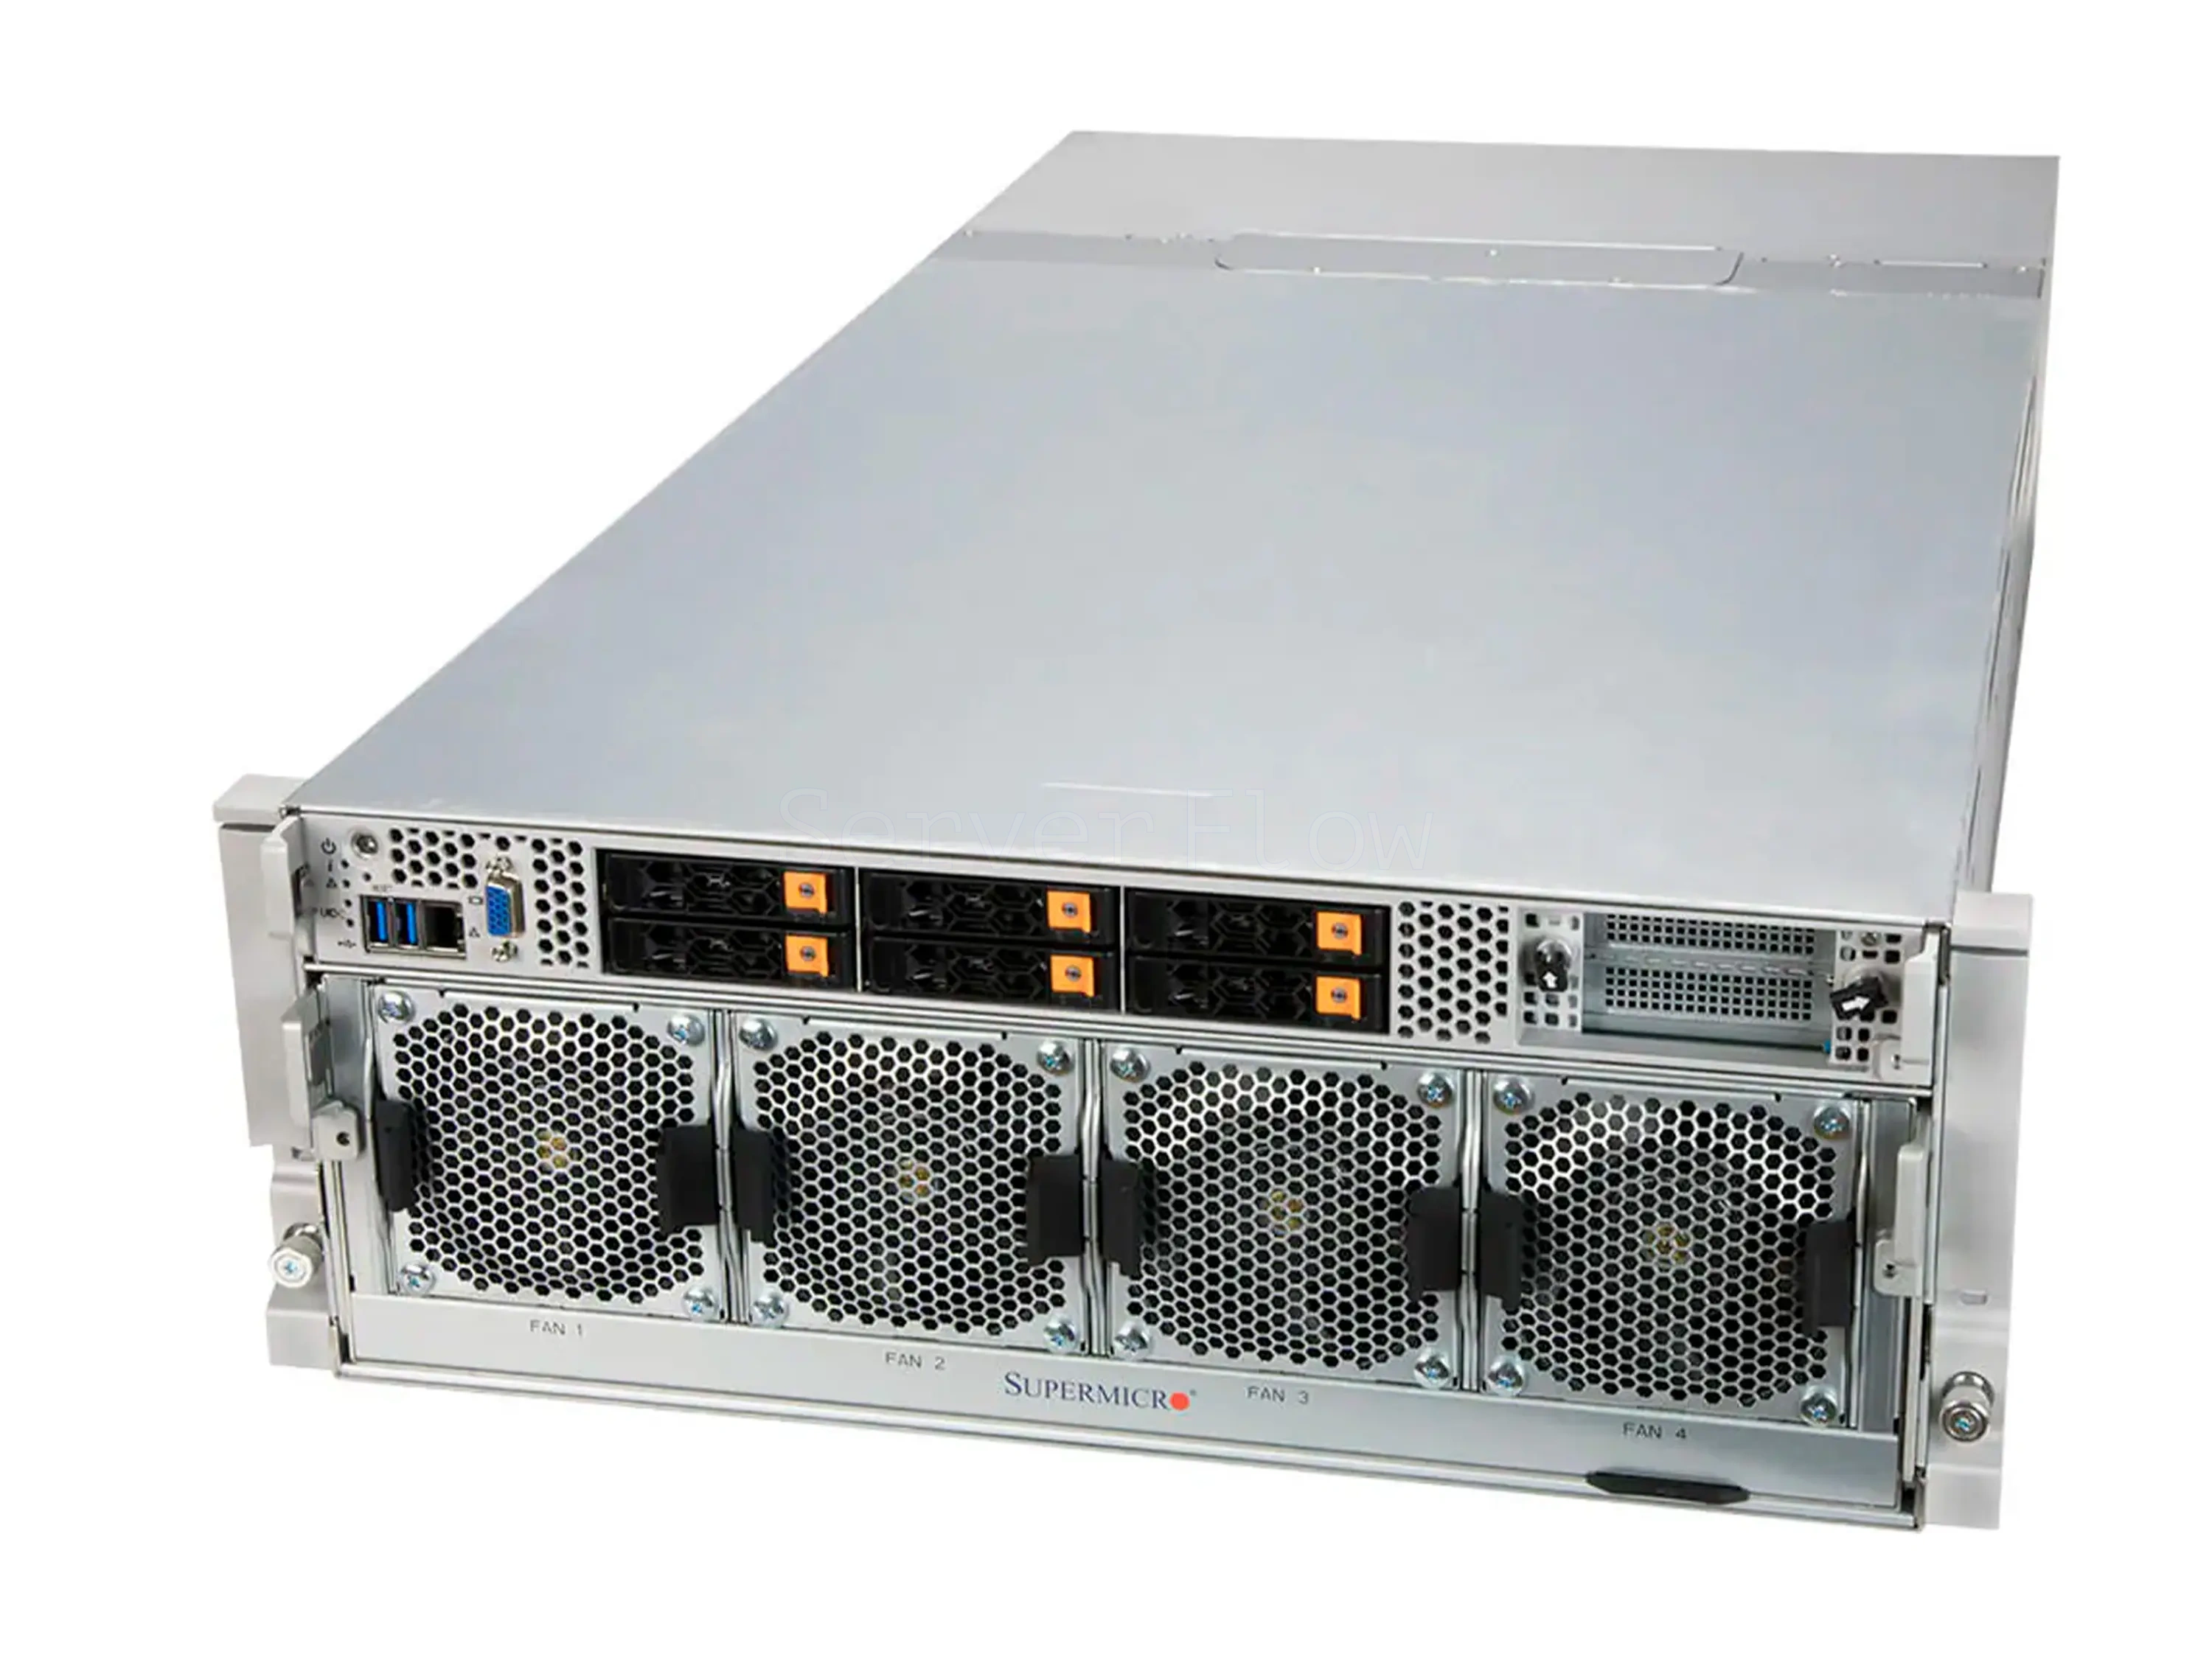
Supermicro SYS-420GP-TNAR (8× A100 SXM 40GB)
16 509 700 ₽
Ориентировочная цена. Требует подтверждения.
- Артикул
- SF-20605
- Наличие
- Уточняется
- Обновлено
- 12.11.2026
Для оформления заказа свяжитесь с менеджером. Наличие, комплектацию и цену уточняйте по телефону. Контакты менеджера
Характеристики
- Тип
- Новые
- Основная задача
- Обучение моделей / Инференс / Дообучение моделей / RAG-системы / Анализ данных / Научные расчеты (HPC)
- Процессор (CPU)
- Intel Xeon
- Видеокарта (GPU)
- NVIDIA A100
- Количество GPU, шт
- 8
- Общий объем видеопамяти (VRAM), ГБ
- 320
- Тип памяти GPU
- HBM2
- Объем оперативной памяти (RAM), ГБ
- 8192
- Тип оперативной памяти
- DDR4 ECC REG
- Форм-фактор
- 4U
- Тип точности Совокупная мощность восьми A100 SXM
- Совокупная мощность восьми A100 SXM
- FP64 Tensor Core
- 156 TFLOPS
- BF16 / FP16 Tensor Core
- 4 992 TFLOPS
- TF32 Tensor Core
- 2 496 TFLOPS
- INT8 Tensor Core
- 9 984 TOPS
- Видеокарта
- 8x Nvidia A100 SXM 40GB HBM2
- Процессор
- 2x Socket P+ (LGA-4189) и Intel Xeon Scalable 3-го поколения
- Оперативная память
- до 8TB ECC DDR4 (также заявлена поддержка Intel Optane Persistent Memory 200 до 8TB, суммарно до 12TB с DRAM)
- SSD накопители
- 6× 2.5" hot-swap NVMe/SATA/SAS и 2× M.2 NVMe/SATA (boot only)
Описание
Конфигурация на базе NVIDIA HGX A100 40GB (8× SXM) рассчитана на Обучение моделей (Training), Дообучение моделей (Fine-tuning), Инференс / Развертывание (Inference), RAG-системы (Retrieval-Augmented Generation) и HPC / Научные расчёты, когда важны плотность ускорителей и масштабирование на несколько GPU.
В узле установлен HGX A100 8-GPU, а суммарный объём видеопамяти составляет 320GB VRAM (8×40GB). Этого достаточно для широкого класса задач обучения и продакшн-инференса, но для очень крупных моделей и длинных контекстов нужно аккуратно планировать распределение по GPU и запас под KV-cache.
Для A100 характерны ускорения на Tensor Cores и режимы TF32, BF16, FP16 и INT8, что удобно для смешанной точности в обучении и высокой пропускной способности в инференсе. Между GPU используется NVLink с NVSwitch, что помогает держать стабильную связанность в multi-GPU нагрузках.
Платформа поддерживает два процессора Intel Xeon Scalable 3-го поколения в сокете LGA4189, до 32 DIMM DDR4 ECC 3200 MT/s общим объёмом до 8 TB, а по накопителям доступны 6 фронтальных 2.5 hot-swap отсеков с NVMe, SAS или SATA плюс два M.2 NVMe или SATA под загрузку.
Производительность GPU
| Тип точности | Совокупная мощность восьми A100 SXM |
| FP64 Tensor Core | 156 TFLOPS |
| BF16 / FP16 Tensor Core | 4 992 TFLOPS |
| TF32 Tensor Core | 2 496 TFLOPS |
| INT8 Tensor Core | 9 984 TOPS |
Совместимость с LLM-моделями
| Модель | Тип квантизации | Требуется VRAM | Совместимость | Примечание |
| DeepSeek-R1-Distill-Llama-70B | Нет | Примерно 141GB | ✅ | На 8×A100 40GB удобно держать на 2–4 GPU и оставлять запас VRAM под KV-cache для длинного контекста и высокого QPS. |
| Qwen3.5-397B-A17B-GGUF | Q4_K_M | Примерно 241GB | ✅ | FP8 помещается в 320GB VRAM и лучше работает при распределении на 4–8 GPU с контролем контекста и батча. |
| gpt-oss:120b | Нет (FP16) | Примерно 260GB | ✅ | Комфортный продакшн-инференс на 4–8 GPU с хорошим запасом под параллельные сессии, батчи и длинный контекст. |
| GLM-4.7-GGUF/td> | Q4_K_M | Примерно 216GB | ✅ | Уверенно запускается на 2–4 GPU и оставляет запас VRAM под KV-cache, но при длинном контексте ограничивайте batch и число диалогов. |
| MiniMax-M3 | UD-Q4_K_M | Примерно 264GB | ✅ | Квантизированная версия с заметно меньшим объёмом; удобна для серверов с ограниченным запасом памяти, RAG-сценариев, ассистентов и локальных LLM-сервисов. |
| MiMo-V2.5 | Нет | Примерно 316GB | ✅ | Базовая версия среднего объёма для серверов с хорошим запасом памяти; подходит для RAG, корпоративных ассистентов, генерации текста и стабильного инференса без квантизации. |
Совместимость с диффузионными моделями
| Модель | Тип | Совместимость | Примечание |
| Stable Diffusion XL 1.0 | Текст в изображение | ✅ | High-res, refiner и инпейтинг идут стабильно, генерацию легко распараллелить на 8 GPU для высокой пропускной способности. |
| Flux.2-dev | Текст в изображение | ✅ | 40GB на GPU хватает для большинства high-res пайплайнов, throughput растёт при распределении задач по 8 GPU. |
| SD Turbo | Быстрые предпросмотры | ✅ | Максимальная скорость итераций при большом числе параллельных прогонов на одном узле и минимальных очередях. |
| Kandinsky-5.0-T2I-Lite-sft-Diffusers | Текст в изображение | ✅ | Лёгкая модель с высоким QPS и несколькими пайплайнами одновременно, запас VRAM можно тратить на качество и батчи. |
| Kandinsky-5.0-T2V-Lite-sft-5s-Diffusers | Текст в видео | ✅ | Удобно распараллеливать по нескольким GPU и держать пакетную генерацию коротких роликов без длинных очередей. |
| NVIDIA-Cosmos3-Super | Генерации, анализа и симуляции физического мира, которая может работать с текстом, изображениями, видео и действиями | ✅ | Модель объёмом 133 GB для генерации, анализа и симуляции физического мира. Работает с текстом, изображениями, видео и действиями, поэтому подходит для сложных мультимодальных сценариев. Требует высокой производительности и большого объёма видеопамяти, а стабильность запуска зависит от конкретной конфигурации и настроек оптимизации. |
Технические характеристики
| Видеокарта | 8x Nvidia A100 SXM 40GB HBM2 |
| Процессор | 2x Socket P+ (LGA-4189) и Intel Xeon Scalable 3-го поколения |
| Оперативная память | до 8TB ECC DDR4 (также заявлена поддержка Intel Optane Persistent Memory 200 до 8TB, суммарно до 12TB с DRAM) |
| SSD накопители | 6× 2.5" hot-swap NVMe/SATA/SAS и 2× M.2 NVMe/SATA (boot only) |
Если нужна конфигурация на эту платформу под ваши задачи - свяжитесь с менеджером, и мы предложим подходящий вариант под бюджет и требования.