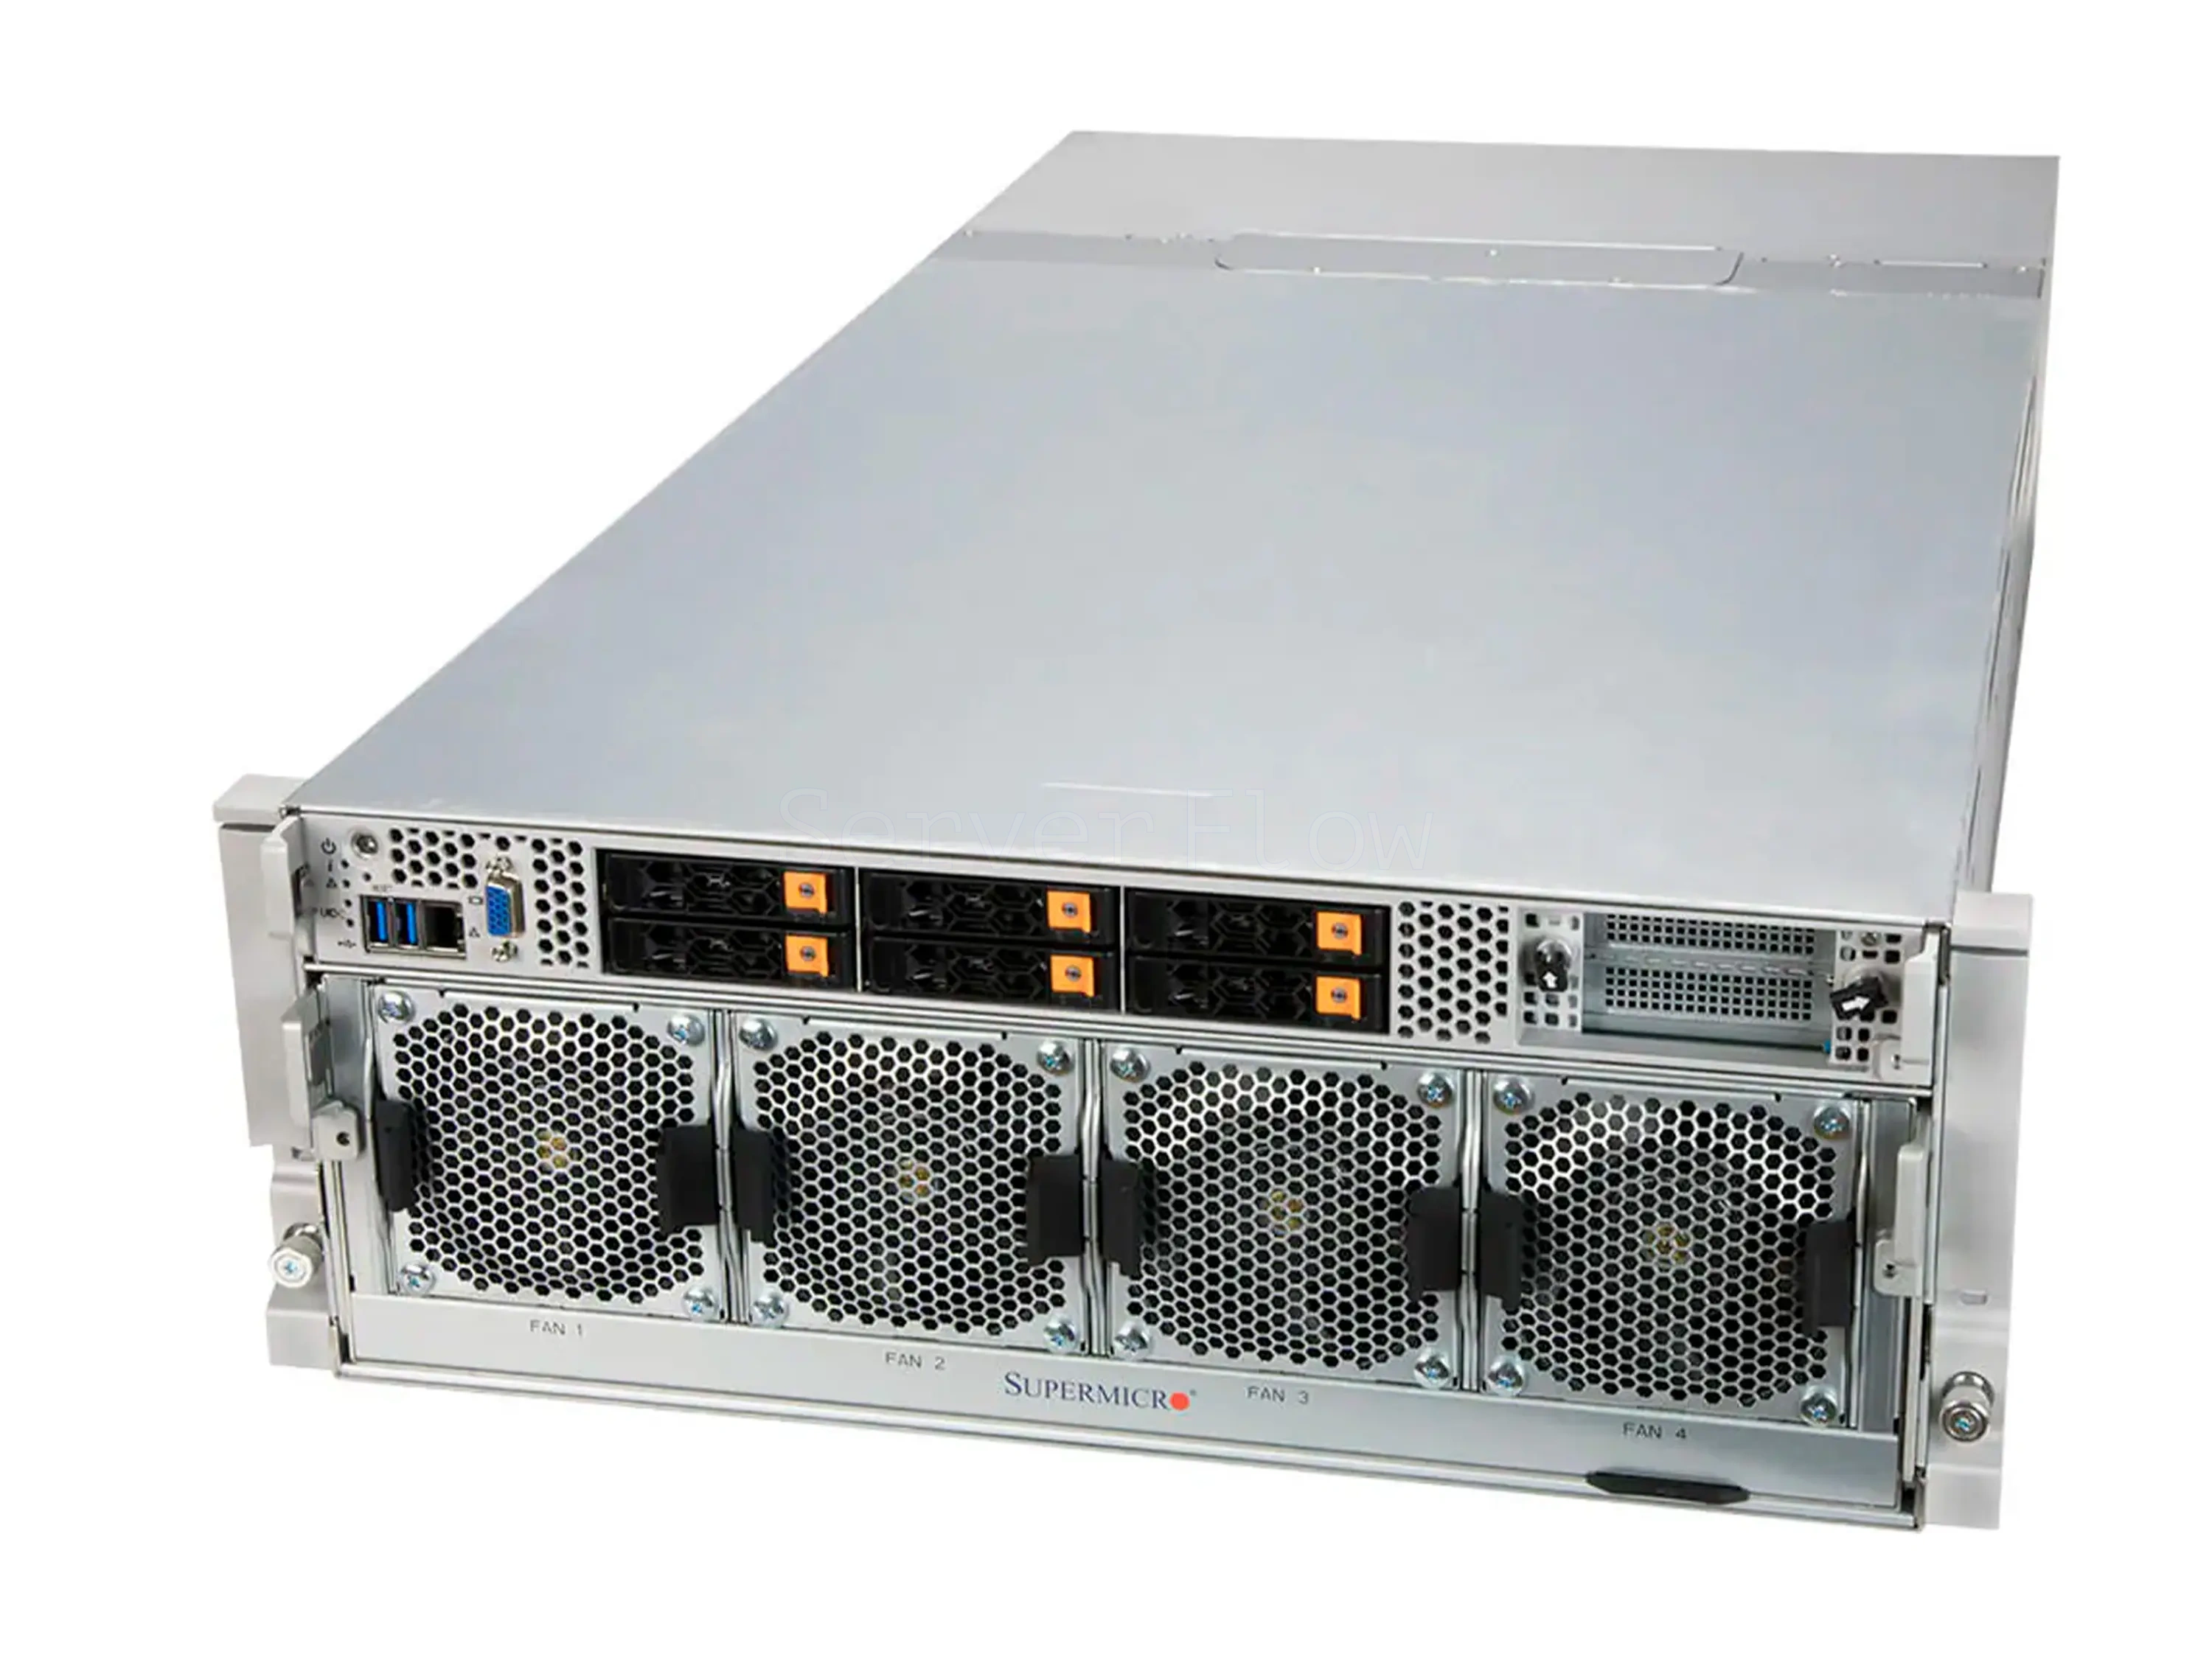
Supermicro SYS-420GP-TNAR (8× A100 SXM 80GB)
17 906 700 ₽
Цена ориентировочная. Информация в каталоге не является публичной офертой.
- Артикул
- SF-20187
- Наличие
- Уточняется
- Обновлено
- 12.11.2026
Поставки организациям и ИП для бизнеса. Для оформления заказа свяжитесь с менеджером и согласуйте итоговую цену, комплектацию и наличие. Контакты менеджера
Характеристики
- Тип
- Новые
- Основная задача
- Обучение моделей / Инференс / Дообучение моделей / RAG-системы / Анализ данных / Научные расчеты (HPC)
- Процессор (CPU)
- Intel Xeon
- Видеокарта (GPU)
- NVIDIA A100
- Количество GPU, шт
- 8
- Общий объем видеопамяти (VRAM), ГБ
- 640
- Тип памяти GPU
- HBM2e
- Объем оперативной памяти (RAM), ГБ
- 8192
- Тип оперативной памяти
- DDR4 ECC REG
- Форм-фактор
- 4U
- Тип точности Совокупная мощность восьми A100 SXM
- Совокупная мощность восьми A100 SXM
- FP64 Tensor Core
- 156 TFLOPS
- BF16 / FP16 Tensor Core
- 4 992 TFLOPS
- TF32 Tensor Core
- 2 496 TFLOPS
- INT8 Tensor Core
- 9 984 TOPS
- Видеокарта
- 8x Nvidia A100 SXM 80GB HBM2e
- Процессор
- 2x Socket P+ (LGA-4189) и Intel Xeon Scalable 3-го поколения
- Оперативная память
- до 8TB ECC DDR4 (также заявлена поддержка Intel Optane Persistent Memory 200 до 8TB, суммарно до 12TB с DRAM)
- SSD накопители
- 6× 2.5" hot-swap NVMe/SATA/SAS и 2× M.2 NVMe/SATA (boot only)
Описание
Платформа с HGX A100 80GB (8×SXM) хорошо подходит под Обучение моделей (Training), Дообучение моделей (Fine-tuning), Инференс / Развертывание (Inference), RAG-системы (Retrieval-Augmented Generation) и HPC / Научные расчёты - когда важны стабильная multi-GPU работа и масштабирование нагрузки.
GPU-секция построена на HGX A100 8-GPU и использует NVLink с NVSwitch, а суммарный объём видеопамяти в данной сборке - 640GB VRAM (8×80GB), что удобно для больших батчей и длинных контекстов при правильном контроле KV-cache
Из ограничений по накопителям: M.2 (NVMe/SATA) предназначены только под загрузочные диски, а основные диски ставятся в фронтальные hot-swap отсеки.
Платформа поддерживает 2× Socket P+ (LGA-4189) и Intel Xeon Scalable 3-го поколения, память - 32 DIMM слота с максимумом до 8TB ECC DDR4 (также заявлена поддержка Intel Optane Persistent Memory 200 до 8TB, суммарно до 12TB с DRAM). Для накопителей доступны 6× 2.5" hot-swap NVMe/SATA/SAS и 2× M.2 NVMe/SATA (boot only).
Производительность GPU
| Тип точности | Совокупная мощность восьми A100 SXM |
| FP64 Tensor Core | 156 TFLOPS |
| BF16 / FP16 Tensor Core | 4 992 TFLOPS |
| TF32 Tensor Core | 2 496 TFLOPS |
| INT8 Tensor Core | 9 984 TOPS |
Совместимость с LLM-моделями
| Модель | Тип квантизации | Требуется VRAM | Совместимость | Примечание |
| DeepSeek-R1-GGUF 685B | Q4_K_M | Примерно 404GB | ✅ | Оптимально 4-бит и TP на 4–8 GPU; держите запас VRAM под KV-cache при длинном контексте. |
| Qwen3.5-397B-A17B-FP8 / Qwen3.6-35B-A3B | FP8 / Нет | Примерно 406GB / 71.9 GB | ✅ | Лучше распараллеливать по 6–8 GPU для стабильного serving и больших батчей. |
| Gpt-oss:120b | Нет | Примерно 196GB | ✅ | Комфортно на 2–4 GPU с большим запасом под KV-cache и высокий throughput. |
| GigaChat3.5-432B-A28B | Нет | Примерно 438GB | ✅ | Запуск в 4-бит с TP на 8 GPU; контролируйте контекст и batch, чтобы не упираться в KV-cache. |
| Mistral-Large-3-675B-Instruct-2512-GGUF | Q4_K_M | Примерно 407GB | ✅ | Логично держать в 4-бит и распределять по 4–8 GPU, сохраняя запас под KV-cache. |
| GLM-5.3-Flash | Нет | Примерно 328GB | ✅ | Стабильно на 2-4 GPU; в 4-бит остаётся запас под длинный контекст и параллельные запросы. |
| Kimi-K2.7-Code | Нет | Примерно 595GB | ✅ | Полноразмерная версия для мощных GPU-серверов; подходит для reasoning-задач, RAG, агентных рабочих процессов и производственного инференса с высоким запасом качества. |
| MiniMax-M3 | UD-Q4_K_M | Примерно 264GB | ✅ | Квантизированная версия с заметно меньшим объёмом; удобна для серверов с ограниченным запасом памяти, RAG-сценариев, ассистентов и локальных LLM-сервисов. |
| MiMo-V2.5-Pro-GGUF | UD_Q4_K_M | Примерно 630GB | ✅ | Квантизированная Pro-версия для более гибкого размещения на серверных конфигурациях с разным объёмом памяти; подходит для RAG, reasoning-задач и производственных LLM-сервисов. |
Совместимость с диффузионными моделями
| Модель | Тип | Совместимость | Примечание |
| Stable Diffusion XL 1.0 | Текст в изображение | ✅ | Высокий throughput: масштабируйте генерацию по нескольким GPU и держите большие батчи. |
| Flux.2-dev | Текст в изображение | ✅ | Требует ~178GB VRAM - лучше распределять по нескольким GPU или использовать offload/оптимизации памяти. |
| SD Turbo | Быстрые предпросмотры | ✅ | Максимальная скорость предпросмотров; легко держит высокий concurrency и параллельные очереди. |
| Kandinsky-5.0-T2I-Lite-sft-Diffusers | Текст в изображение | ✅ | Требует ~35GB VRAM - остаётся большой запас под высокое разрешение и batch. |
| Kandinsky-6.0-Pro-distill-5s-Diffusers | Текст/изображение в видео со звуком | ✅ | ~29GB VRAM на ролики до ~5 секунд; хорошо параллелится по GPU в продакшн-пайплайне. |
| NVIDIA-Cosmos3-Super | Генерации, анализа и симуляции физического мира, которая может работать с текстом, изображениями, видео и действиями | ✅ | Модель объёмом 133 GB для генерации, анализа и симуляции физического мира. Работает с текстом, изображениями, видео и действиями, поэтому подходит для сложных мультимодальных сценариев. Требует высокой производительности и большого объёма видеопамяти, а стабильность запуска зависит от конкретной конфигурации и настроек оптимизации. |
Технические характеристики
| Видеокарта | 8x Nvidia A100 SXM 80GB HBM2e |
| Процессор | 2x Socket P+ (LGA-4189) и Intel Xeon Scalable 3-го поколения |
| Оперативная память | до 8TB ECC DDR4 (также заявлена поддержка Intel Optane Persistent Memory 200 до 8TB, суммарно до 12TB с DRAM) |
| SSD накопители | 6× 2.5" hot-swap NVMe/SATA/SAS и 2× M.2 NVMe/SATA (boot only) |
Если нужна конфигурация на эту платформу под ваши задачи - свяжитесь с менеджером, и мы предложим подходящий вариант под бюджет и требования.