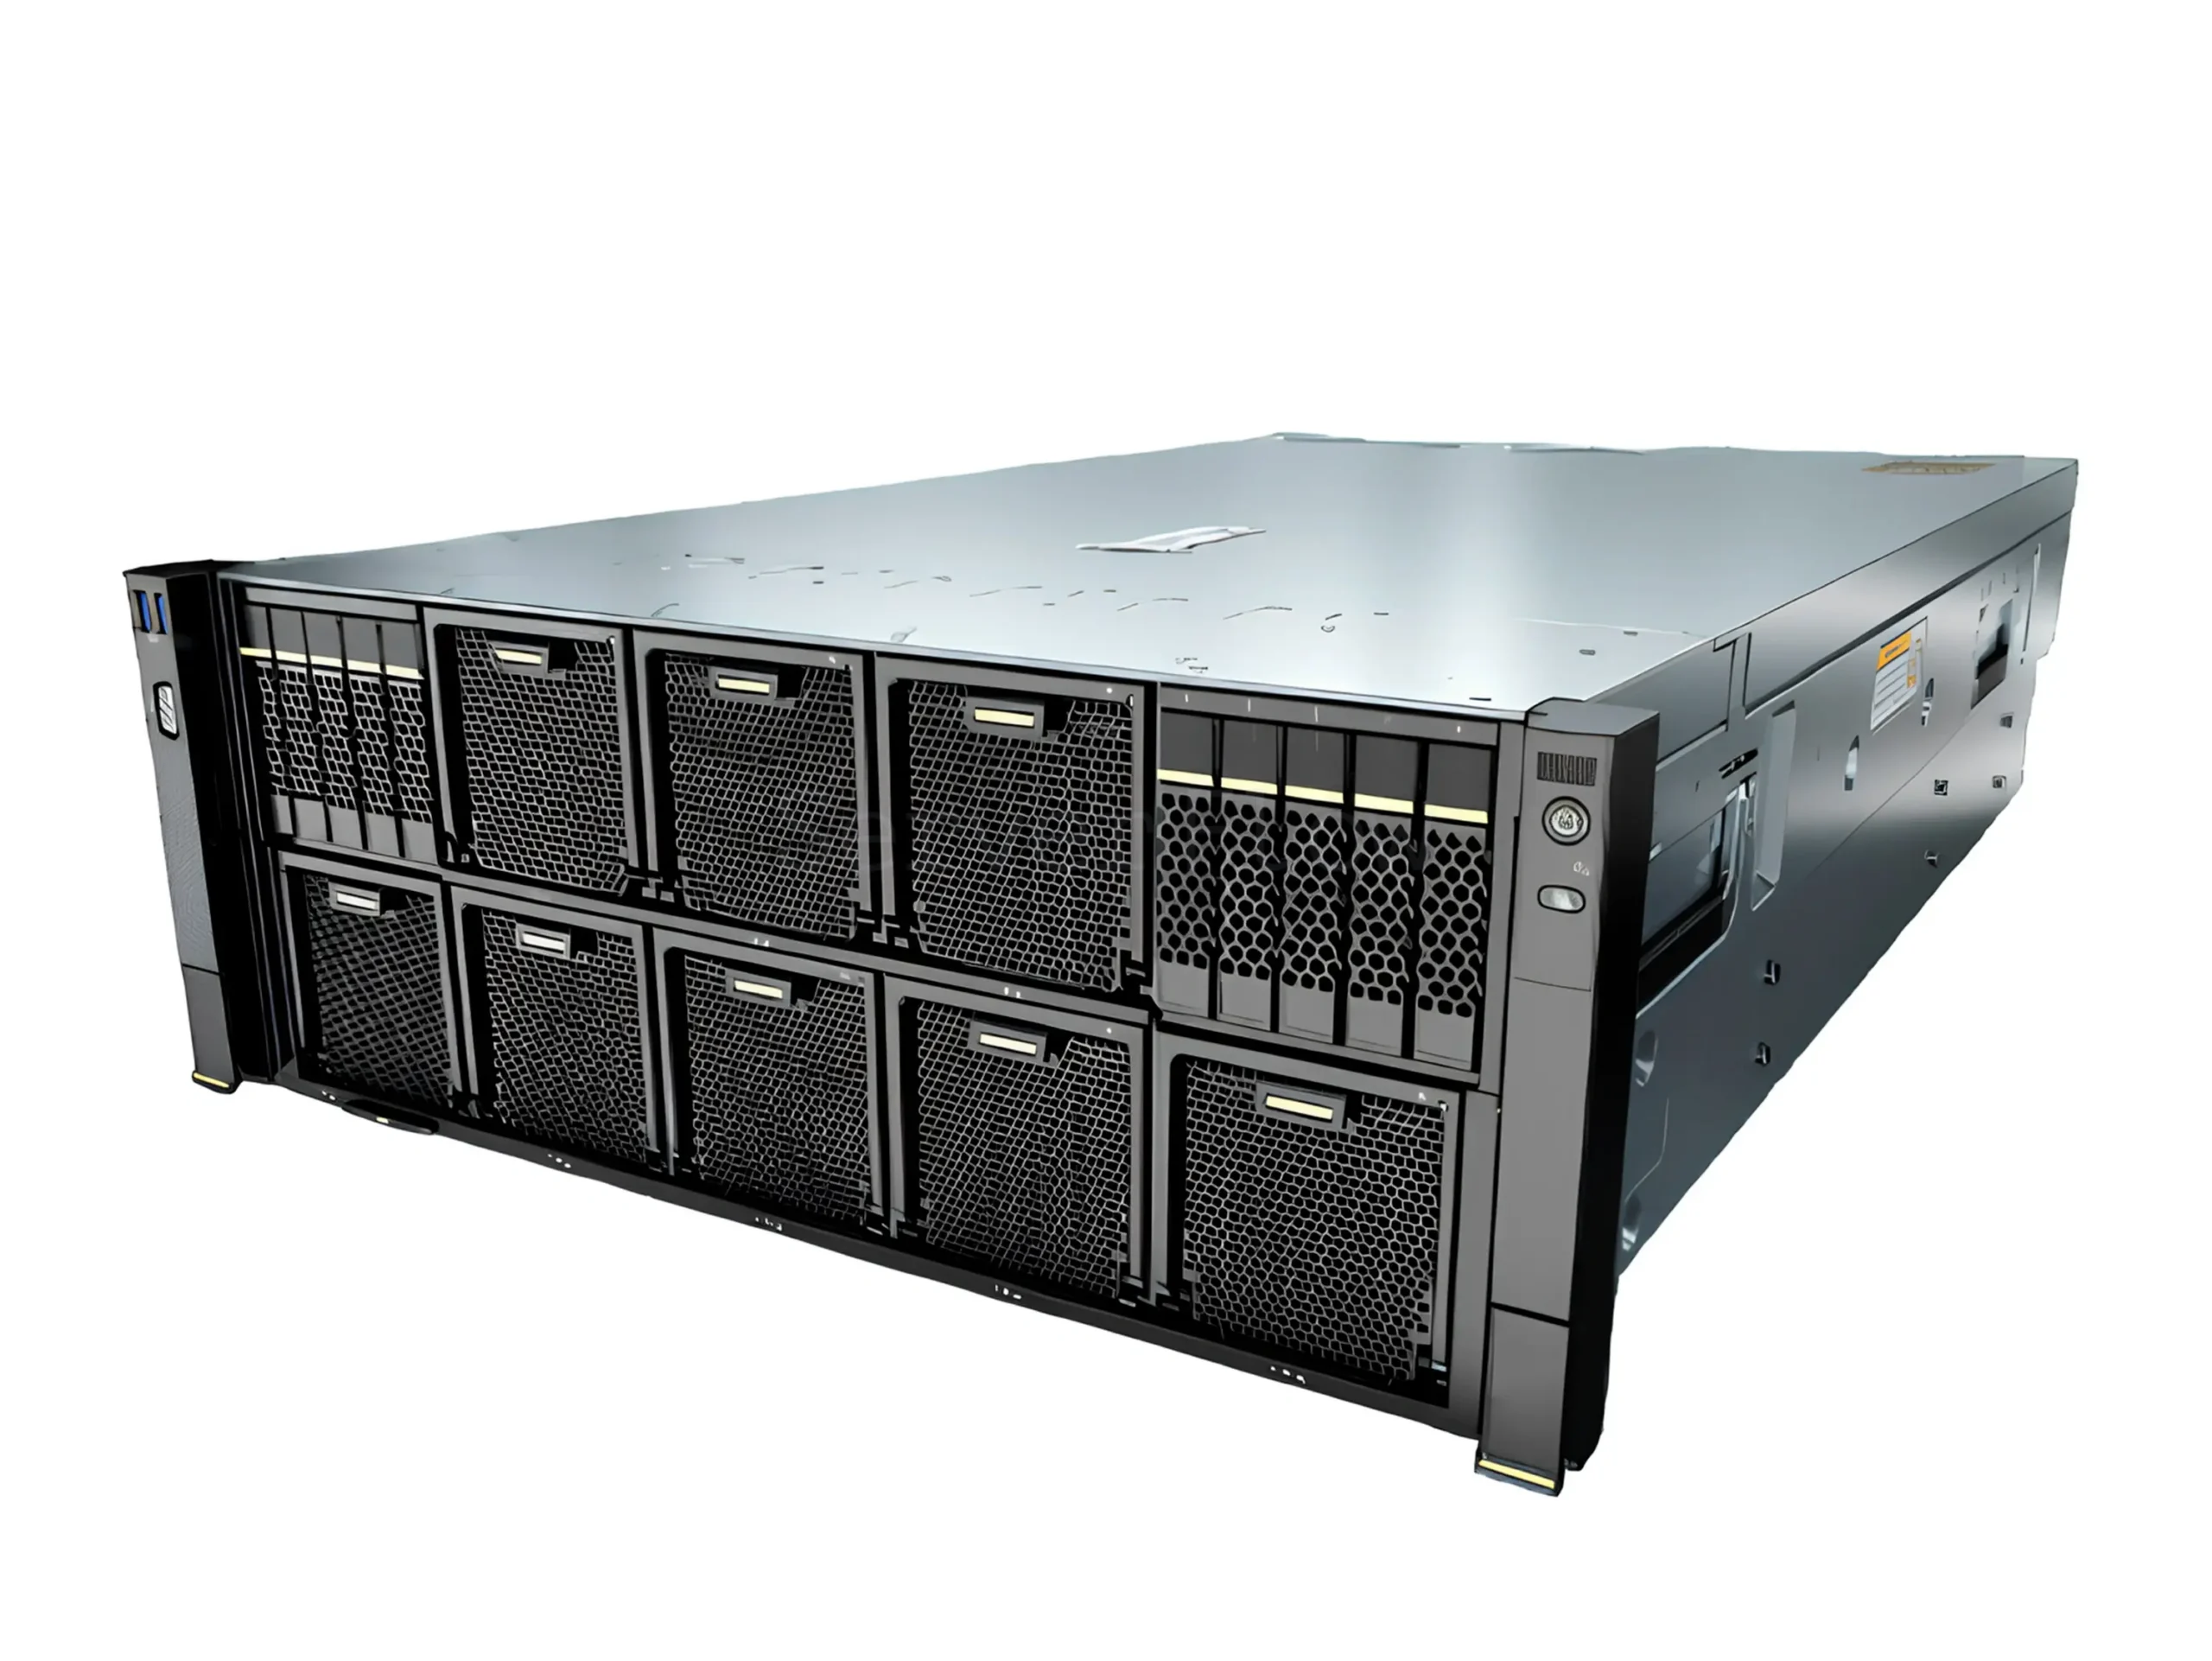
Huawei Atlas 800I A2 (8× Ascend 910B 64GB, 4× Kunpeng 920, RAM 512GB)
21 023 300 ₽
Цена ориентировочная. Информация в каталоге не является публичной офертой.
- Артикул
- SF-19312
- Наличие
- Уточняется
- Обновлено
- 12.11.2026
Поставки организациям и ИП для бизнеса. Для оформления заказа свяжитесь с менеджером и согласуйте итоговую цену, комплектацию и наличие. Контакты менеджера
Характеристики
- Тип
- Новые
- Основная задача
- Инференс / RAG-системы / Анализ данных / Научные расчеты (HPC)
- Процессор (CPU)
- Kunpeng 920
- Видеокарта (GPU)
- Ascend 910B
- Количество GPU, шт
- 8
- Общий объем видеопамяти (VRAM), ГБ
- 512
- Тип памяти GPU
- HBM
- Объем оперативной памяти (RAM), ГБ
- 512
- Тип оперативной памяти
- DDR4 ECC REG
- Форм-фактор
- 4U
- Тип точности Совокупная мощность восьми Ascend 910B Reasoning
- Совокупная мощность восьми Ascend 910B Reasoning
- FP32
- 0.60 PFLOPS
- FP16
- 2.24 PFLOPS
- INT8
- 4.48 POPS
- Видеокарта
- 8x Ascend 910B Reasoning 64GB HBM
- Оперативная память
- 512GB DDR4 ECC REG возможно увеличить до 2TB
- Сетевые карты
- 8-port 200Gbe QSFP интерфейс прямого выхода, протокол RoCE
Описание
Huawei Atlas 800I A2 - это 4U стоечный inference-сервер на базе четырёх CPU Kunpeng 920 и восьми NPU Ascend 910B Reasoning, рассчитанный на промышленные сценарии Инференса / Развертывания (Inference), RAG-систем (Retrieval-Augmented Generation) и reasoning-моделей в интернет-, финтех- и гос-проектах. Сервер официально позиционируется как inference-платформа для крупных генеративных моделей, развёртываемых в ЦОД и облаках.
В конфигурации с 8 × Ascend 910B Reasoning суммарная мощность достигает 2,24 PFLOPS в FP16 и 4,48 POPS в INT8, при этом каждый NPU Ascend 910B оснащён 64 ГБ HBM - всего до 512 ГБ “GPU-памяти” с пропускной способностью до 1,6 ТБ/с по шине HBM.
Поддержка до 32 модулей DDR4-3200 (16/32/64 ГБ на слот, суммарно до 2 ТБ) позволяет держать большие индексы для RAG-систем, KV-кэши и пайплайны Анализа данных (Data Science), а гибкая корзина локального хранилища (варианты до 10×2.5″ SATA/NVMe с поддержкой RAID 0/1/5/6/10/50/60) закрывает задачи хранения датасетов, снапшотов и чекпоинтов. Восемь 200GE QSFP-портов с RoCE дают плотную сетевую связность для кластеров, а до трёх слотов PCIe 4.0 позволяют добавить сетевые карты или специализированные адаптеры.
Сервер использует программный стек Huawei CANN + MindSpore / Ascend-совместимый PyTorch (torch-npu), а также уже поддерживается vLLM-Ascend для LLM-сервинга на Atlas A2 (Ascend-cann-kernels-910b), куда входит и Atlas 800I A2. Это делает его практичной альтернативой NVIDIA-кластерам для развёртывания современных LLM и reasoning-моделей, но требует ориентации на экосистему Ascend вместо CUDA/ROCm. Ограничения: сервер не предназначен для GPU-графики и классического FP64-ориентированного HPC / Научных расчётов, а перенос части tooling’а (TensorRT, CUDA-ориентированные фреймворки) потребует портирования или использования Ascend-специфичных реализаций.
Производительность GPU
| Тип точности | Совокупная мощность восьми Ascend 910B Reasoning |
| FP32 | 0.60 PFLOPS |
| FP16 | 2.24 PFLOPS |
| INT8 | 4.48 POPS |
Совместимость с LLM-моделями
| Модель | Тип квантизации | Требуется VRAM | Совместимость | Примечание |
| DeepSeek-R1-GGUF 671B | Q4_K_M | Примерно 404GB | ✅ | Требует аккуратной раскладки весов и ограничения batch/контекста; на 8×Ascend 910B Reasoning (512ГБ HBM) возможен продакшн-инференс при использовании оптимизированного стека под Ascend. |
| Qwen3.5-397B-A17B-GGUF / Qwen3.6-35B-A3B | Q4_K_M / Нет | Примерно 241GB / 71.9 GB | ✅ | Отлично подходит для reasoning-задач и аналитики; уверенно размещается на 8×Ascend 910B Reasoning и масштабируется по всем NPU для снижения латентности. |
| gpt-oss-120b | Нет | Примерно 196GB | ✅ | Даёт высокую скорость отклика на Ascend 910B; остаётся значительный запас HBM для RAG-индексов и одновременного запуска нескольких инстансов в продакшн-сервисах. |
| GigaChat3.5-432B-A28B | Нет | Примерно 438GB | ✅ | Подходит для сложных русскоязычных ассистентов, аналитики и генерации длинных текстов; комфортно работает в Q4_K_M на всех 8 NPU Ascend 910B Reasoning. |
| Mistral-Large-3-675B GGUF | Q4_K_M | Примерно 404GB | ✅ | Многоязычная модель для reasoning-задач, RAG-сценариев и интеллектуальных агентов; хорошо масштабируется по NPU и подходит для сервисов с длинным контекстом на Atlas 800I A2. |
| GLM-5.3-Flash | Нет | Примерно 328GB | ✅ | Уверенно работает на 8×Ascend 910B Reasoning и подходит для многоязычных ассистентов, аналитики и производственных LLM-сервисов. |
| MiniMax-M3 | UD-Q4_K_M | Примерно 264GB | ✅ | Квантизированная версия с заметно меньшим объёмом; удобна для серверов с ограниченным запасом памяти, RAG-сценариев, ассистентов и локальных LLM-сервисов. |
| MiMo-V2.5 | Нет | Примерно 316GB | ✅ | Базовая версия среднего объёма для серверов с хорошим запасом памяти; подходит для RAG, корпоративных ассистентов, генерации текста и стабильного инференса без квантизации. |
Совместимость с диффузионными моделями
| Модель | Тип | Совместимость | Примечание |
| Stable Diffusion 3 Medium | Текст в изображение | ✅ | Использует 8×Ascend 910B Reasoning и большой объём HBM для генерации изображений до 4096×4096 с высокими batch-размерами; подходит для сложных композиций и художественных стилей при наличии сборок под Ascend. |
| FLUX.2-dev | Текст в изображение | ✅ | Ускоренная версия FLUX для 4K-генерации; на Atlas 800I A2 хорошо масштабируется по 8 NPU Ascend 910B Reasoning и подходит для потоковой генерации и рендеринга при использовании фреймворков с поддержкой Ascend. |
| Stable Video Diffusion 1.1 | Видео(img2vid) | ✅ | Использует Ascend 910B Reasoning для генерации роликов до ~8 секунд в Full HD; для длинных видео рекомендуется рендер по сегментам с последующей склейкой и параллельным запуском нескольких задач. |
| Kandinsky-5.0-T2I-Lite-sft-Diffusers | Текст в изображение | ✅ | Лёгкая версия Kandinsky 5.0 (~35 GB VRAM); на Atlas 800I A2 есть большой запас HBM для высокого разрешения, крупных батчей и одновременного запуска нескольких диффузионных пайплайнов. |
| Kandinsky-6.0-Pro-distill-5s-Diffusers | Текст/изображение в видео со звуком | ✅ | T2V-модель (~29 GB VRAM) для роликов до ~5 секунд; на Atlas 800I A2 хорошо масштабируется по нескольким NPU Ascend 910B Reasoning и подходит для продакшн-пайплайнов генерации короткого видео. |
| NVIDIA-Cosmos3-Super | Генерации, анализа и симуляции физического мира, которая может работать с текстом, изображениями, видео и действиями | ✅ | Модель объёмом 133 GB для генерации, анализа и симуляции физического мира. Работает с текстом, изображениями, видео и действиями, поэтому подходит для сложных мультимодальных сценариев. Требует высокой производительности и большого объёма видеопамяти, а стабильность запуска зависит от конкретной конфигурации и настроек оптимизации. |
Технические характеристики
| Видеокарта | 8x Ascend 910B Reasoning 64GB HBM |
| Процессор | 4x Kunpeng 920 (64c/64t, 2.6Ghz, 180W) |
| Оперативная память | 512GB DDR4 ECC REG возможно увеличить до 2TB |
| Сетевые карты | 8-port 200Gbe QSFP интерфейс прямого выхода, протокол RoCE |